Uma conta do Cloud Run pode parecer inexplicável quando um serviço recebe poucas solicitações, mas ainda precisa fazer trabalho depois que responde. O problema costuma ser uma mistura de três decisões: quando a CPU fica disponível, por quanto tempo uma instância deve existir e se um serviço HTTP é mesmo o recurso certo para o trabalho.
A introdução ao Google Cloud Run explica a plataforma em termos gerais. Este artigo responde a uma escolha mais específica: quando usar faturamento baseado em solicitações e quando usar faturamento baseado em instâncias.
Não executei um serviço Cloud Run nem medi uma aplicação específica para escrever este artigo. A comparação usa a documentação atual do Google Cloud, uma leitura de discussões públicas para identificar dúvidas recorrentes e uma matriz de decisão original. Os comandos são referências de configuração, não prova de resultado no seu projeto.
Resposta curta
- Use faturamento por solicitações quando o trabalho estiver ligado ao processamento de pedidos e o tráfego for esporádico, em rajadas ou variável.
- Use faturamento por instâncias quando a aplicação realmente precisar de CPU durante toda a vida da instância, inclusive para trabalho em segundo plano limitado.
- Não escolha o modo apenas pela palavra “cobrança”. Confirme se o trabalho deveria estar em um Service, Job, worker pool ou instância do Cloud Run.
- Meça custo, latência, encerramentos e trabalho pendente depois de mudar uma variável por vez.
Qual é a diferença entre os dois modos?
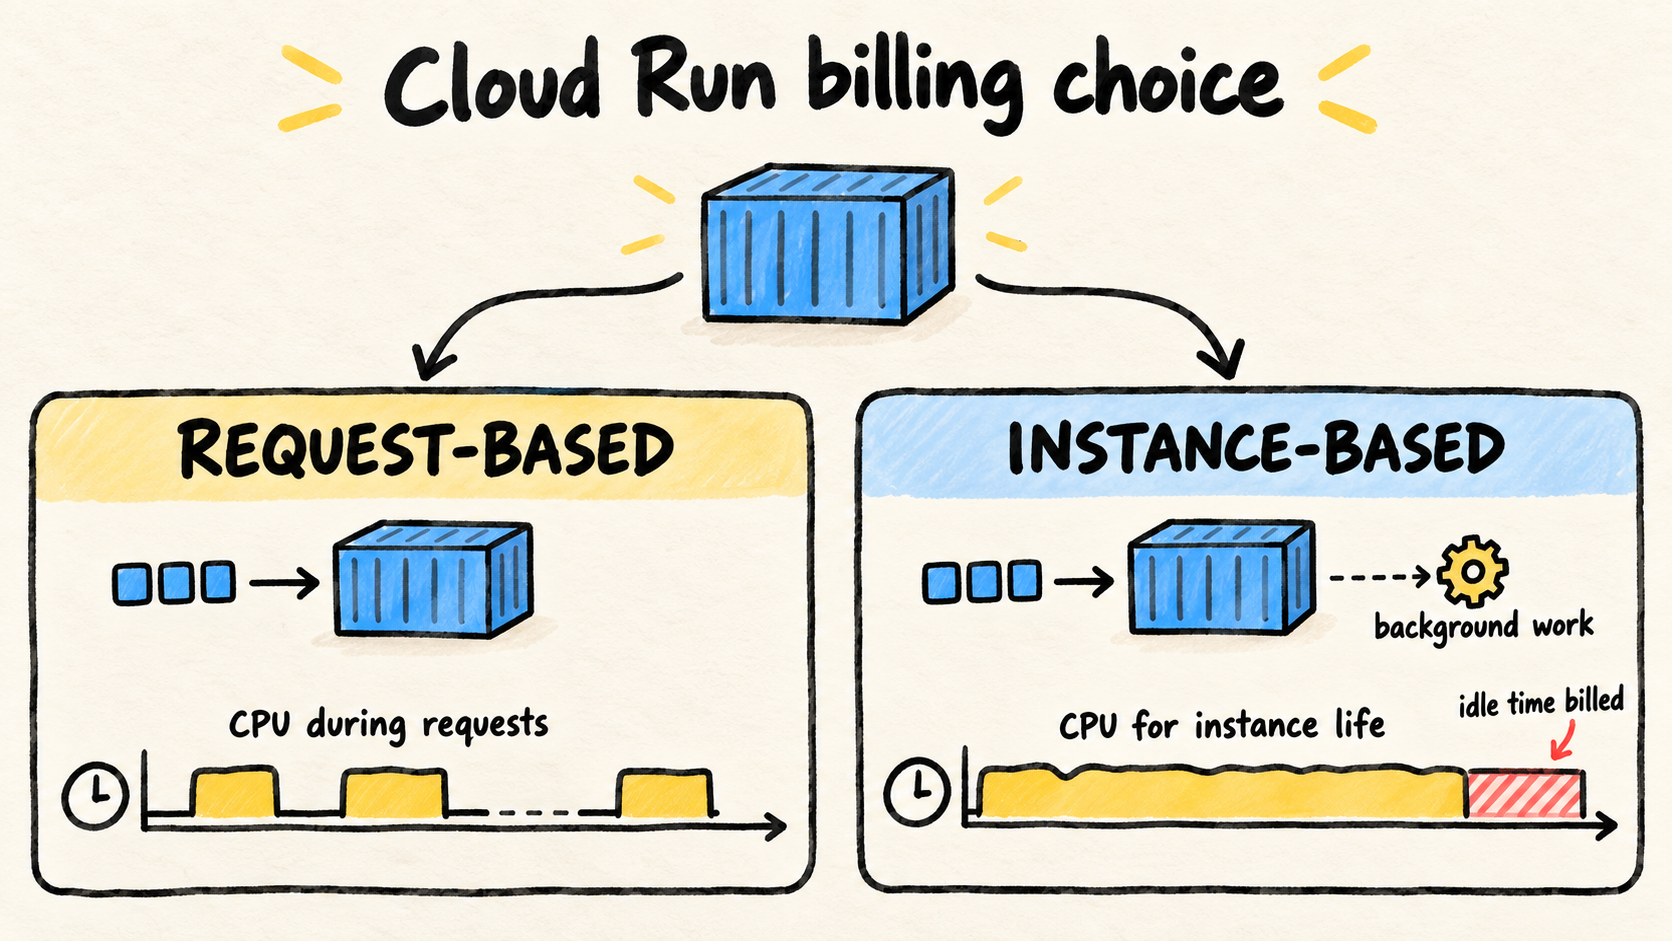
Na documentação de configuração de faturamento do Cloud Run, consultada em 28/10/2026, o modo baseado em solicitações aloca CPU durante o processamento das solicitações. O modo baseado em instâncias mantém a CPU alocada durante todo o ciclo de vida da instância.
Essa diferença também muda o que acontece quando não há uma solicitação ativa. No modo por solicitações, a capacidade ociosa não continua executando o processo com CPU alocada. No modo por instâncias, a instância continua sendo cobrada durante seu ciclo de vida, inclusive quando está ociosa. O preço do Cloud Run, consultado na mesma data, descreve a distinção entre o tempo processando solicitações e o tempo de vida da instância.
| Pergunta | Faturamento por solicitações | Faturamento por instâncias |
|---|---|---|
| Quando a CPU fica alocada? | Durante o processamento das solicitações | Durante a vida da instância |
| Tráfego típico | Esporádico, em rajadas ou variável | Contínuo, lento ou com trabalho além da solicitação |
| O que acontece no idle? | O serviço pode escalar e não processa trabalho de fundo com CPU alocada | A instância continua no ciclo de vida cobrado enquanto existir |
| Uso que merece atenção | APIs e handlers ligados ao pedido | Tarefas de fundo limitadas, agentes de telemetria e trabalho iniciado pela aplicação |
| Risco de decisão | Pagar por capacidade que não é necessária | Pagar por instâncias ociosas ou usar um Service como worker durável |
O modo não é uma promessa de custo baixo ou alto por si só. Ele é uma declaração sobre o ciclo de vida que sua aplicação precisa.
Quando o faturamento por solicitações é a melhor escolha?
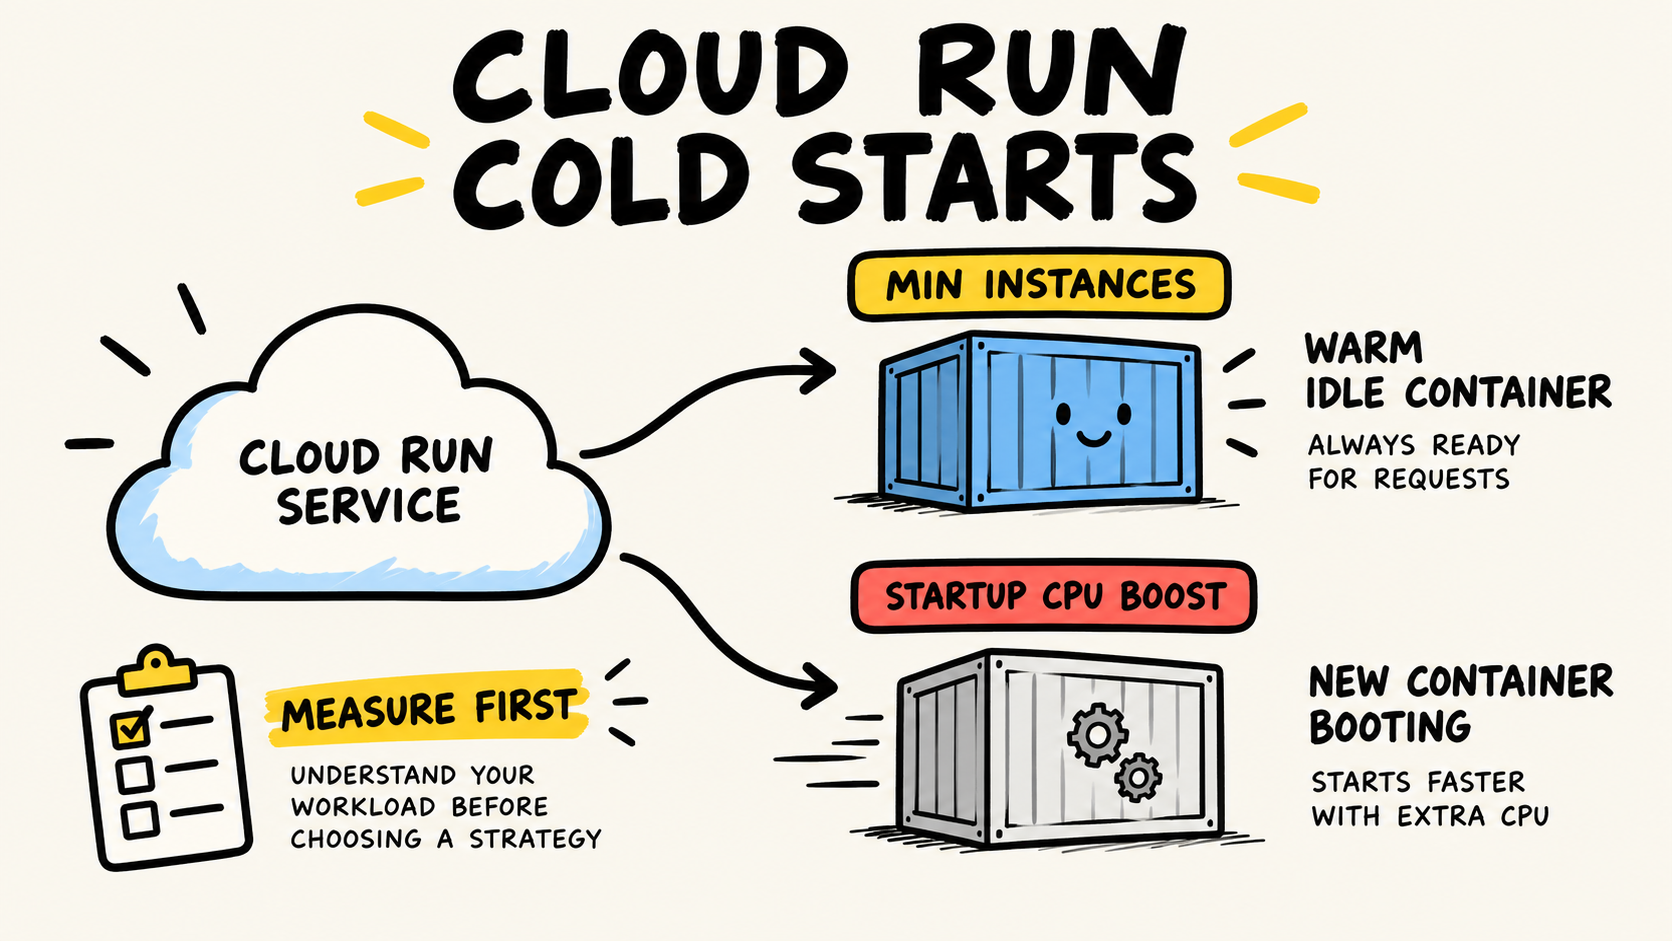
O modo por solicitações costuma combinar com uma API que faz seu trabalho durante o pedido e termina a maior parte da atividade antes de responder. Ele também é adequado quando o tráfego varia bastante e o serviço pode se beneficiar de escalar a partir de zero. Se a primeira requisição é a preocupação, compare essa decisão com o diagnóstico de cold start no Cloud Run.
O próprio Google Cloud recomenda esse modo para workloads esporádicos, em rajadas ou com picos. Essa recomendação está na documentação de configuração de faturamento do Cloud Run, não em uma estimativa de preço universal. O custo real depende do uso, da região, da configuração e dos recursos associados.
Escolha esse caminho quando todas estas condições forem verdadeiras:
- O trabalho importante acontece durante uma solicitação.
- O processo não precisa de CPU confiável depois de enviar a resposta.
- O atraso de escalar a partir de zero cabe no objetivo da rota.
- O serviço pode repetir a operação ou persistir seu estado sem depender do processo atual continuar vivo.
Isso não significa que o modo por solicitações seja seguro para qualquer endpoint curto. Se a rota inicia um trabalho assíncrono e devolve sucesso antes de persistir uma unidade de trabalho durável, o problema é de confiabilidade do fluxo, não apenas de faturamento.
Quando o faturamento por instâncias resolve um problema real?
O modo por instâncias faz sentido quando existe trabalho que precisa de CPU fora do período estrito de uma solicitação. A documentação do Google Cloud cita trabalho assíncrono ou em segundo plano limitado depois da resposta, como agentes de OpenTelemetry, tarefas assíncronas de Node.js, threads Java e coroutines Kotlin.
Ele também pode combinar com tráfego contínuo ou com uma aplicação que faz trabalho de fundo enquanto a instância existe. Mas a frase importante é “enquanto a instância existe”. O autoscaling ainda se aplica. O Cloud Run pode encerrar instâncias, e uma instância ociosa pode permanecer por no máximo 15 minutos depois de uma solicitação, salvo outras configurações como instâncias mínimas (Google Cloud, “Billing settings for services”, consultado em 28/10/2026).
Portanto, escolha o modo por instâncias somente quando você também puder responder:
- O que acontece se a instância for encerrada durante o trabalho?
- Qual estado durável permite retomar ou repetir a unidade de trabalho?
- Qual limite de custo impede instâncias ociosas de crescerem sem controle?
- Por que esse trabalho pertence a um Service HTTP e não a um Cloud Run Job com retries ou a um worker pool?
O faturamento por instâncias fornece CPU durante a vida da instância. Não fornece uma fila, checkpoint, reprocessamento, exclusão mútua ou garantia de permanência.
O que esse modo não garante?
Há quatro confusões recorrentes que podem transformar uma mudança de billing em uma falsa correção.
Uma instância viva não é uma garantia de continuidade
Autoscaling, implantação, falha no startup, capacidade regional e quota ainda afetam o ciclo de vida. Instâncias mínimas podem reduzir a chance de começar do zero, mas são uma meta de capacidade, não uma promessa de que uma instância específica permanecerá viva.
CPU alocada não torna o trabalho durável
Se o processo é encerrado, a memória e o sistema de arquivos gravável da instância não são um checkpoint para a próxima instância. Grave o estado em armazenamento durável e use uma chave idempotente quando a unidade puder ser repetida. O artigo sobre SIGTERM no Cloud Run sem perder trabalho detalha esse handoff.
Um 504 não informa sozinho se o trabalho terminou
Na documentação de timeout de solicitações do Cloud Run, consultada em 28/10/2026, o Google Cloud explica que o timeout padrão é de 300 segundos, que o limite máximo documentado é de 3600 segundos e que um 504 fecha a conexão, embora o container possa continuar processando a solicitação interrompida. Isso exige idempotência e uma forma de verificar o estado fora da conexão.
Não aumente o timeout para esconder uma fila, uma dependência lenta ou uma tarefa que deveria ser um Job. Um timeout maior muda o limite da solicitação, mas não cria uma transação distribuída.
Health check pode mudar a escolha
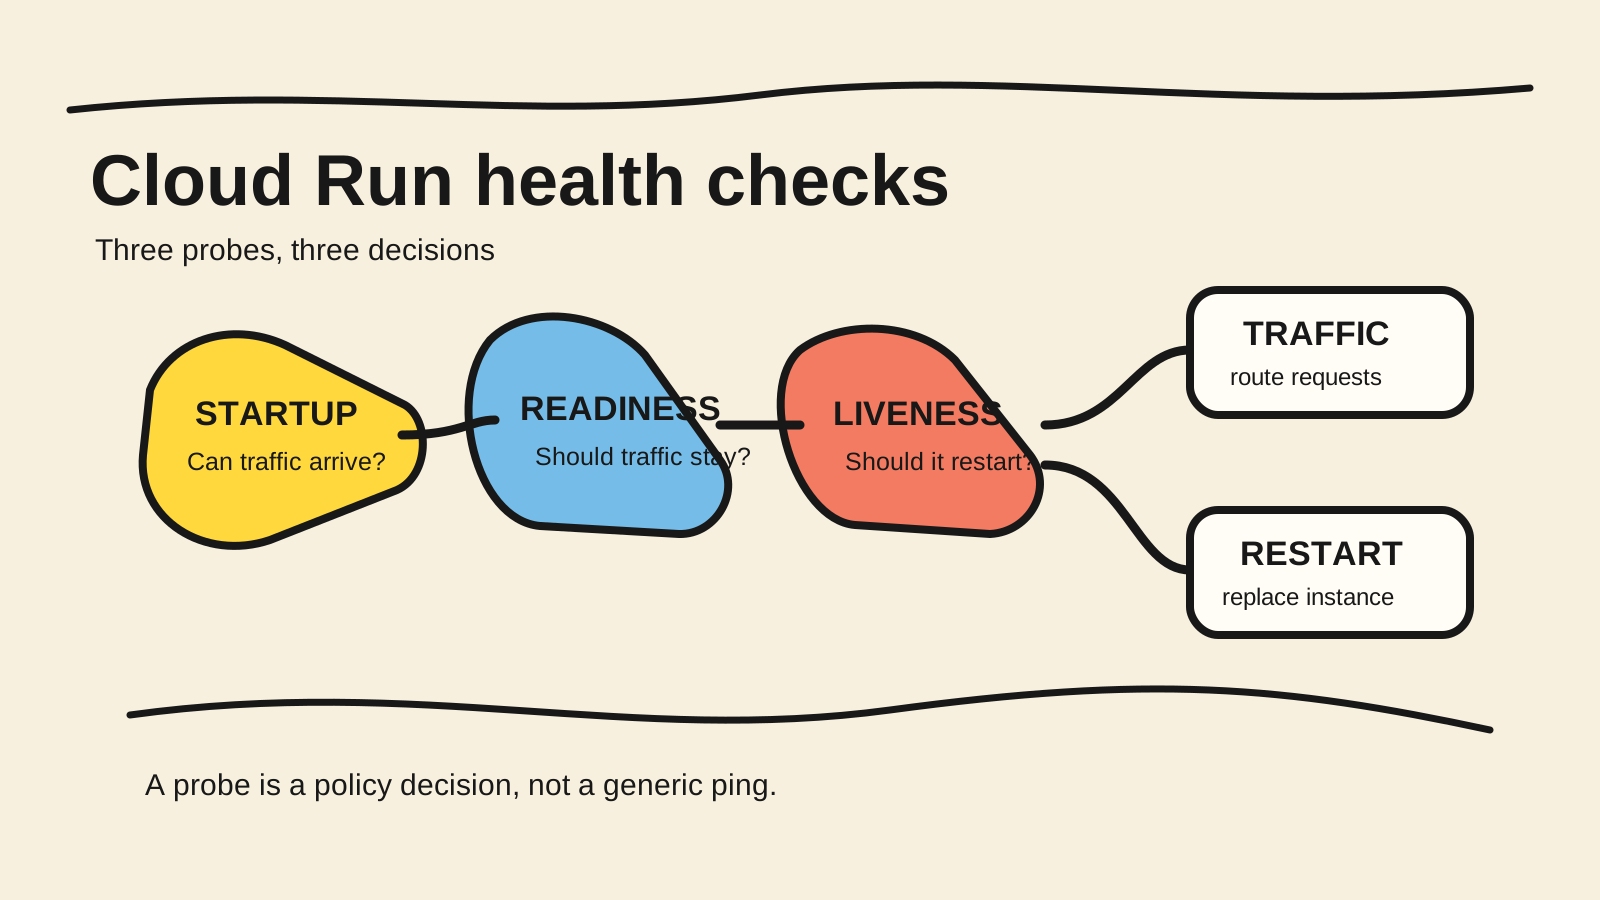
A documentação de billing do Cloud Run informa que health checks exigem o modo baseado em instâncias. A explicação de startup, liveness e readiness no Cloud Run ajuda a separar a função da sonda do modo de cobrança. Se a verificação precisa executar com CPU fora do processamento normal de solicitações, trate isso como requisito técnico que deve ser validado junto com o custo.
Service, Job, worker pool ou instância?
Antes de escolher a cobrança, escolha o dono do ciclo de trabalho. A página de modelo de recursos e opções de implantação do Cloud Run, consultada em 28/10/2026, ajuda a separar serviços, jobs, worker pools e instâncias.
| Forma do trabalho | Recurso a investigar primeiro | Por que não começar pelo billing? |
|---|---|---|
| Resposta HTTP curta e ligada ao pedido | Cloud Run Service | O ciclo termina com a solicitação e pode escalar com o tráfego |
| Lote finito que deve terminar e pode ser repetido | Cloud Run Job | O job explicita execução, tarefas e retries |
| Consumo contínuo de uma fila sem endpoint público | Cloud Run worker pool | O modelo representa o worker sem transformar uma API em fila improvisada |
| Processo longo que precisa de uma instância específica | Cloud Run instance | O ciclo da instância é o objeto que você está tentando operar |
Um Service com billing por instâncias pode ser útil para um caso limitado, como uma aplicação que inicia trabalho de fundo controlado. Ele é uma escolha ruim quando serve apenas para manter um worker sem fila, sem checkpoint e sem política de encerramento.
Como mudar o modo e verificar a revisão?
Na documentação de billing, o Google Cloud documenta estes comandos para um serviço:
gcloud run services update SERVICE --cpu-throttling
gcloud run services update SERVICE --no-cpu-throttling
gcloud run services describe SERVICE --region REGION
--cpu-throttling seleciona o comportamento baseado em solicitações. --no-cpu-throttling seleciona o comportamento baseado em instâncias. A mudança cria uma nova revisão e o modo por instâncias exige pelo menos 512 MiB de memória, conforme a mesma documentação.
O terceiro comando não prova que o custo melhorou. Use-o para conferir a configuração da revisão e registre junto a região, CPU, memória, concorrência, instâncias mínimas e imagem. Se o problema aparece em picos, separe billing de concorrência por instância no Cloud Run. Depois compare o mesmo cenário de tráfego nas revisões.
Faça uma verificação pequena e reversível:
- Escolha uma rota ou workload que represente o problema.
- Registre solicitações, erros, latência, número de instâncias e custo no período de comparação.
- Se houver trabalho assíncrono, registre o início, o checkpoint e a conclusão fora do container.
- Mude somente o modo de CPU e billing.
- Verifique se o trabalho de fundo terminou, foi repetido com segurança ou ficou abandonado.
- Reverta a revisão se o objetivo não melhorar ou se o custo crescer sem uma justificativa operacional.
Não use um keep-alive artificial para impedir o scale-to-zero sem medir o efeito. Uma chamada periódica pode alterar o tráfego e dificultar a atribuição do custo.
Checklist de decisão
Use estas perguntas antes de trocar a configuração:
- A unidade de trabalho precisa continuar depois que a resposta foi enviada?
- Existe um estado durável que permite repetir ou retomar o trabalho?
- O tráfego é esporádico, em rajadas, contínuo ou desconhecido?
- Uma instância ociosa pode continuar sendo cobrada dentro do orçamento?
- O health check ou outro requisito realmente precisa de CPU fora das solicitações?
- Um Job ou worker pool expressaria melhor o ciclo do que um Service?
- A revisão nova será comparada com a anterior usando a mesma métrica?
Se você não consegue responder às duas primeiras perguntas, ainda não está diante de uma escolha de billing. Está diante de um problema de desenho de trabalho e estado.
Conclusão
O faturamento por solicitações combina com trabalho ligado ao pedido e com tráfego que pode escalar a partir de zero. O faturamento por instâncias combina com CPU necessária durante toda a vida da instância, inclusive algum trabalho assíncrono limitado. Nenhum dos dois cria durabilidade, fila ou permanência.
Comece pelo ciclo de vida do trabalho. Depois escolha Service, Job, worker pool ou instância. Só então altere o billing, compare uma revisão com a outra e confira o custo junto com a conclusão real do trabalho.
Como esta análise foi feita
Samuel Fajreldines é o autor responsável por este artigo. A pesquisa comparou a documentação atual do Cloud Run, o inventário local de posts para evitar sobreposição e discussões públicas de praticantes para identificar dúvidas e linguagem. A matriz de decisão é síntese editorial original. Os comandos não foram executados contra um projeto Cloud Run neste artigo, e não há benchmark, caso de cliente ou preço calculado. A assistência de IA apoiou descoberta, redação, geração da imagem, localização e revisão de consistência; não forneceu experiência de produção nem substituiu a verificação das fontes.