O serviço pode estar saudável e ainda punir o primeiro usuário depois de um intervalo sem tráfego. A requisição espera a imagem ser preparada, o processo iniciar e o container ficar pronto para receber tráfego. Depois disso, a mesma rota responde normalmente.
Esse atraso costuma ser chamado de cold start, mas o nome sozinho não diz qual ajuste resolve o problema. O guia de introdução ao Cloud Run explica o serviço em termos gerais. Aqui, a pergunta é mais estreita: vale manter uma instância aquecida, dar mais CPU durante a inicialização ou aceitar o atraso depois de medir?
Não executei um serviço Cloud Run nem medi uma aplicação específica para escrever este artigo. A comparação abaixo usa a documentação atual do Google Cloud e separa configuração, medição e decisão. Os comandos são referências de configuração, não prova de um resultado no seu projeto.
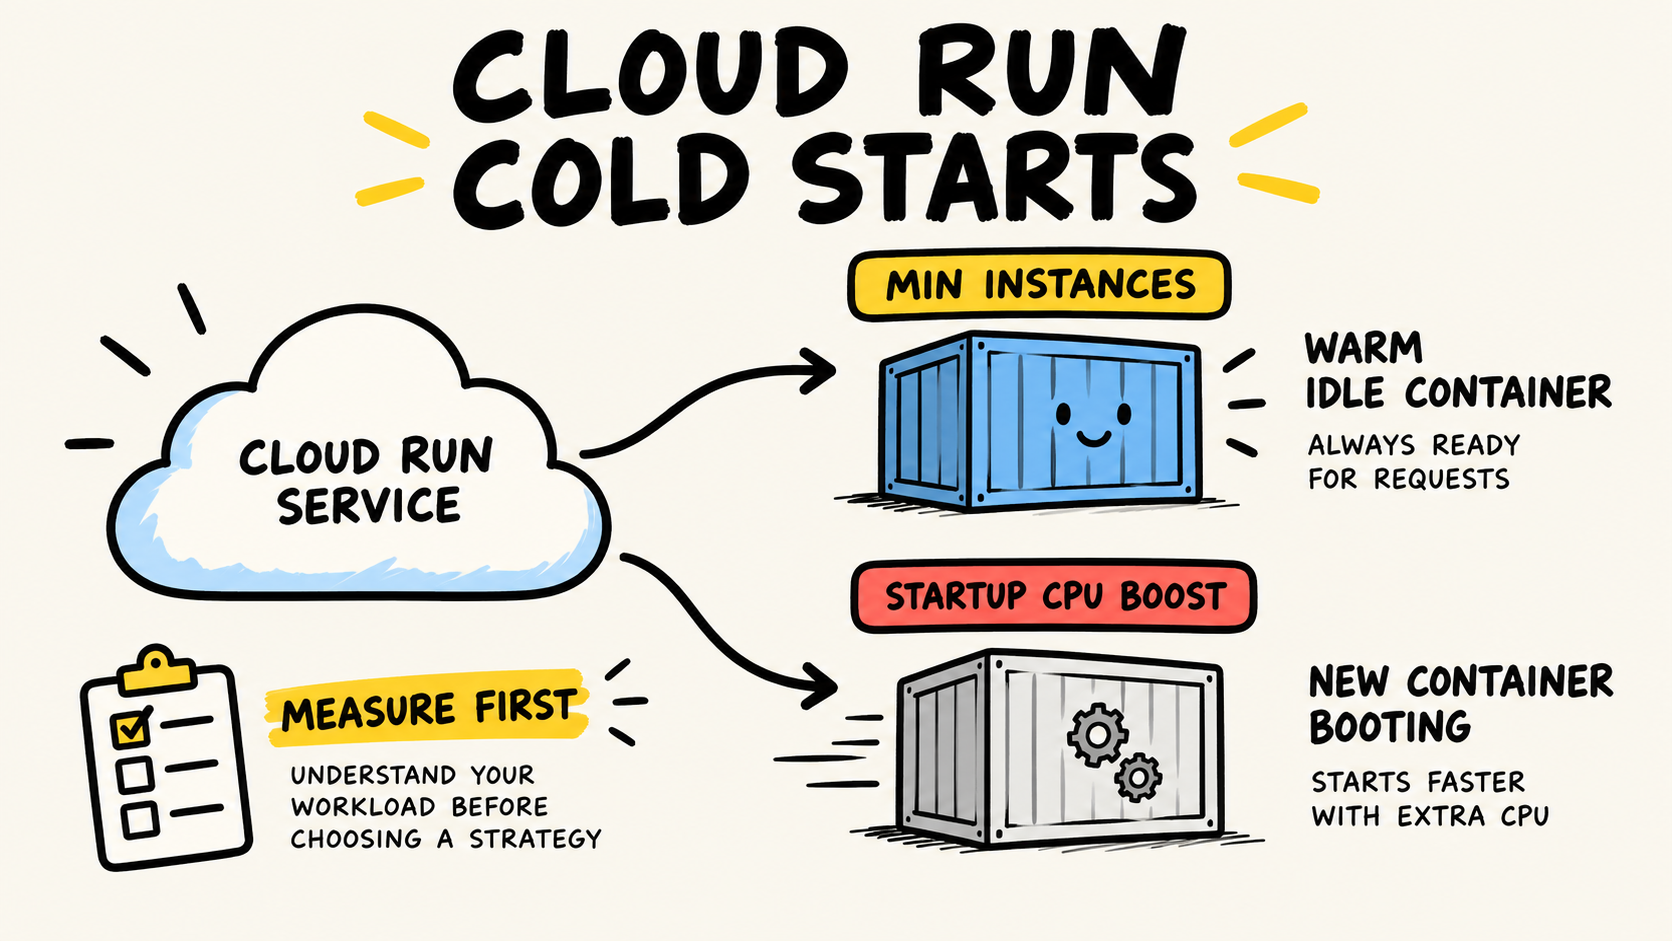
Resposta curta
- Use
min-instancesquando o custo da primeira espera justificar manter capacidade pronta.- Use startup CPU boost quando uma instância nova precisa iniciar mais rápido, inclusive durante uma expansão.
- Reduza imagem, imports e inicialização quando o container faz trabalho demais antes de escutar a porta.
- Meça o tempo pendente, o startup e a execução da aplicação separadamente antes de escolher.
Como saber se o atraso é mesmo um cold start?
Em 2026, a documentação Google Cloud, “General development tips”, consultada em 23/09/2026, descreve que o Cloud Run separa a inicialização da instância do processamento da requisição. Quando o serviço escala a partir de zero, uma requisição pode esperar a imagem, o processo e a porta ficarem prontos. Portanto, uma latência alta no primeiro pedido não prova que o handler ou o banco sejam lentos.
Comece comparando três medidas. A latência pendente mostra o tempo até a requisição chegar a uma instância. A latência de startup mostra quanto o container levou para iniciar. A execução do usuário mostra quanto seu código levou depois que recebeu o pedido. Sem essa separação, é fácil aumentar CPU para corrigir uma consulta lenta ou manter uma instância ligada para esconder uma imagem pesada.
O Cloud Run já expõe métricas de startup de container, contagem de instâncias e latência de requisições no Cloud Monitoring. A documentação Google Cloud, “Monitor health and performance”, consultada em 23/09/2026, também orienta usar a aba de métricas do serviço. Se a dúvida estiver em uma requisição específica, use logs e traces para descobrir se a espera veio do container ou de uma dependência.
O que min-instances resolve?
min-instances mantém uma quantidade mínima de instâncias prontas, mesmo quando elas não estão processando requisições. Em 2026, Google Cloud, “Set minimum instances for services”, consultado em 23/09/2026, documenta o valor padrão 0 e o uso de um mínimo maior para reduzir a latência ao sair de zero. Esse ajuste ataca a espera por uma primeira instância, não a execução lenta dentro dela.
Há um custo direto: instâncias mantidas pelo mínimo geram cobrança mesmo sem processar uma requisição. O alvo também é de melhor esforço. A documentação lista capacidade de zona ou região, rebalanceamento, crash no startup, limites de quota e billing desativado como motivos para ficar temporariamente abaixo do número configurado. min-instances: 1 reduz uma fonte de espera, mas não é uma garantia de que toda requisição nunca encontrará uma instância nova.
Uma instância aquecida também não cobre automaticamente toda expansão. Se o tráfego exceder a capacidade disponível, o serviço ainda poderá iniciar outras instâncias. A comparação sobre como escolher a concorrência no Cloud Run ajuda a decidir quantas requisições uma instância deve atender. Não use concorrência alta para mascarar uma inicialização lenta, nem use um mínimo alto antes de entender quantas instâncias o tráfego realmente cria.
O caso típico para min-instances é uma API interativa em que o primeiro pedido depois de um período ocioso tem um objetivo de latência rígido. Se a rota é acessada poucas vezes por dia e o usuário aceita esperar, escalar a partir de zero pode ser a decisão mais simples.
O que startup CPU boost resolve?
Startup CPU boost dá CPU adicional durante a inicialização da instância e por 10 segundos depois que ela inicia. Em 2026, Google Cloud, “Configure CPU limits for services”, consultado em 23/09/2026, documenta que um limite de 0 a 1 vCPU recebe boost para 2, enquanto outros limites têm regras próprias. A mesma página avisa que a CPU adicional é cobrada durante o período de inicialização.
Esse recurso acelera o caminho de uma instância que precisa nascer. Ele não mantém uma instância ligada e não elimina a descarga da imagem, a inicialização de dependências ou um banco lento. Se o atraso vem do trabalho feito pelo processo antes de escutar a porta, CPU extra pode ajudar. Se o atraso está depois que o handler começou, procure a métrica de execução e a dependência responsável.
Você pode habilitar o recurso em uma revisão com o comando documentado pelo Google Cloud:
gcloud run services update SERVICE --cpu-boostPara remover a configuração, use --no-cpu-boost. A mudança cria uma nova revisão, então compare a revisão antiga e a nova no mesmo cenário de tráfego. Não trate o nome “boost” como uma promessa de latência fixa. O benefício depende do runtime, da imagem e do trabalho executado durante o startup.
Min instances ou CPU boost: qual escolher?
A escolha fica mais clara quando você nomeia o ponto em que a espera acontece. min-instances compra prontidão. Startup CPU boost compra mais capacidade temporária para iniciar. Otimizar o container reduz o trabalho que os dois caminhos precisam executar.
| Sintoma observado | Primeira hipótese | Ajuste a testar | O que ainda precisa ser verificado |
|---|---|---|---|
| Primeira requisição depois de escala a zero é lenta | Não há instância pronta | min-instances maior que 0 |
custo, revisões e falhas que derrubam a instância |
| A nova instância demora para iniciar | O startup usa CPU ou inicialização pesada | startup CPU boost | latência de startup e cobrança da CPU adicional |
| Toda revisão começa devagar | Imagem ou imports fazem trabalho demais | reduzir imagem e inicialização | tamanho, dependências, porta e startup probe |
| A primeira requisição chega, mas o handler demora | Problema de execução ou dependência | revisar código, banco e traces | latência de execução do usuário |
| A espera aparece só em picos | Falta de capacidade durante scale-out | rever concorrência, CPU e limites | número de instâncias e latência pendente |
Como regra prática, teste a opção mais específica. Primeiro confirme se a espera está no startup. Depois reduza o trabalho do container. Só então escolha entre manter capacidade pronta ou acelerar cada nova inicialização. Essa ordem evita transformar um sintoma de código em custo permanente.
Como medir a mudança sem se enganar?
Em 2026, Google Cloud, “About instance autoscaling in Cloud Run services”, consultado em 23/09/2026, descreve o equilíbrio entre cold-start latency e o tempo em que uma requisição fica pendente esperando uma vaga ou uma nova instância. A documentação informa que a fila pode manter uma requisição pendente por até 3,5 vezes o startup médio ou 10 segundos, o que for maior. Esse limite é comportamento da plataforma, não um SLO da sua aplicação.
Faça uma comparação que mude uma variável por vez:
- Registre a revisão, região, CPU, memória, imagem, concorrência e mínimo de instâncias.
- Observe latência pendente, latência de startup, execução do usuário, erros e contagem de instâncias.
- Compare tráfego depois de escala a zero com tráfego que cria instâncias adicionais.
- Verifique logs de criação de instância. O Cloud Logging no Cloud Run registra razões como
MANUAL_OR_CUSTOMER_MIN_INSTANCE,AUTOSCALINGeDEPLOYMENT_ROLLOUT. - Remova o ajuste se a métrica que motivou a mudança não melhorar ou se o custo aumentar sem benefício dentro do objetivo.
Uma implantação que termina com sucesso prova que a revisão iniciou. Não prova que a primeira requisição atende sua meta. A documentação Google Cloud, “Introduction to Cloud Run troubleshooting”, consultada em 23/09/2026, recomenda observar a latência do serviço e filtrar instâncias específicas nos logs quando há picos.
Como configurar e verificar min-instances?
O comando abaixo cria uma revisão ou atualiza o serviço para manter uma instância mínima, conforme a configuração escolhida:
gcloud run services update SERVICE --min 1
gcloud run services describe SERVICE
Use o segundo comando para conferir a configuração retornada antes de atribuir qualquer melhora ao ajuste. A documentação também distingue o mínimo no nível do serviço do mínimo no nível da revisão. Quando o tráfego está dividido entre revisões, essa distinção muda onde a capacidade fica aquecida.
O teste precisa cobrir pelo menos três momentos: depois de um período sem tráfego, durante uma expansão e após uma nova implantação. Um mínimo configurado pode perder efeito se o container falhar no startup ou não passar na verificação de saúde. A visão geral de health checks no Google Cloud e AWS ajuda a separar prontidão, reinício e latência de aplicação.
Não adicione um keep-alive artificial apenas para impedir escala a zero. Uma chamada periódica pode alterar o padrão de tráfego, gerar custo e esconder o comportamento que você queria medir. Se a aplicação exige processamento contínuo, consumo de fila ou tarefas longas, compare o serviço com Cloud Run Jobs e seus retries em vez de transformar uma API em worker improvisado.
Quando não vale pagar por uma instância aquecida?
Manter instâncias mínimas não é uma correção universal. Pode não valer a pena quando o tráfego é raro, a rota tolera alguns segundos de espera, o problema está no banco ou a aplicação ainda não mede startup e execução separadamente. Nesse caso, escalar a partir de zero preserva a simplicidade enquanto você melhora o container e coleta evidência.
Também não use min-instances para compensar crash, health check incorreto, quota esgotada ou imagem que demora para iniciar. O Cloud Run tentará alcançar o mínimo, mas uma instância que não fica saudável não atende ninguém. Corrija o motivo da falha e repita a medição.
O resultado esperado não é “sempre manter uma instância”. É saber qual espera o usuário encontrou e qual configuração a reduz. Às vezes a melhor otimização é uma imagem menor. Às vezes é CPU durante o startup. Às vezes é uma instância aquecida. E, quando a primeira requisição não é importante, nenhuma dessas mudanças é necessária.
Perguntas frequentes
min-instances: 1 elimina todo cold start?
Não. Ele mantém pelo menos uma instância como alvo de prontidão, mas não impede toda expansão, reinício, crash, falta de quota ou evento de capacidade. A documentação de mínimo de instâncias do Google Cloud também descreve o recurso como melhor esforço. Meça a latência de startup e a contagem de instâncias antes e depois.
Startup CPU boost mantém o container sempre ligado?
Não. O recurso dá CPU adicional durante o startup e por 10 segundos depois. Ele acelera a criação de uma instância nova, mas não substitui min-instances. Também não resolve o tempo gasto pelo handler depois que o container já está pronto. Use métricas de startup e execução para separar essas partes.
Devo habilitar os dois ajustes juntos?
Pode fazer sentido, mas não como primeiro passo automático. min-instances reduz a chance de começar do zero, enquanto CPU boost ajuda quando uma nova instância ainda precisa nascer. Habilite um ajuste por vez, compare a revisão em um cenário controlado e confira cobrança, startup, latência pendente e execução.
Como diferenciar cold start de banco lento?
Compare a latência pendente, o startup do container e a execução do usuário. Se o startup está normal, mas a execução cresce quando a aplicação abre uma conexão ou consulta dados, o ajuste de instâncias não ataca a causa. Use Cloud Logging ou Cloud Trace para atribuir a espera à dependência correta.
Conclusão
Cold start é uma pergunta de medição antes de ser uma pergunta de configuração. min-instances mantém capacidade aquecida. Startup CPU boost torna o nascimento de uma instância mais rápido. Otimizar imagem e inicialização reduz o trabalho dos dois caminhos.
Comece com uma revisão observável. Registre startup, espera pendente, execução, erros, instâncias e custo. Mude uma variável. Se a primeira requisição não tiver um objetivo de latência rígido, aceite o scale-to-zero e preserve o dinheiro para o gargalo que os dados realmente mostrarem.
Como esta análise foi feita
Samuel Fajreldines é o autor responsável por este artigo. A pesquisa comparou a documentação atual do Google Cloud Run, a estrutura dos posts recentes e sinais públicos de praticantes. A matriz de decisão é síntese editorial original. Os comandos não foram executados contra um projeto Cloud Run neste artigo, e não há benchmark, caso de cliente ou preço calculado. A assistência de IA apoiou descoberta, redação, geração da imagem, localização e revisão de consistência; não forneceu experiência de produção nem substituiu a verificação das fontes.
Fontes consultadas
- Google Cloud, “General development tips”, consultado em 23/09/2026
- Google Cloud, “Set minimum instances for services”, consultado em 23/09/2026
- Google Cloud, “Configure CPU limits for services”, consultado em 23/09/2026
- Google Cloud, “About instance autoscaling in Cloud Run services”, consultado em 23/09/2026
- Google Cloud, “Monitor health and performance”, consultado em 23/09/2026
- Google Cloud, “Logging and viewing logs in Cloud Run”, consultado em 23/09/2026
- Google Cloud, “Introduction to Cloud Run troubleshooting”, consultado em 23/09/2026