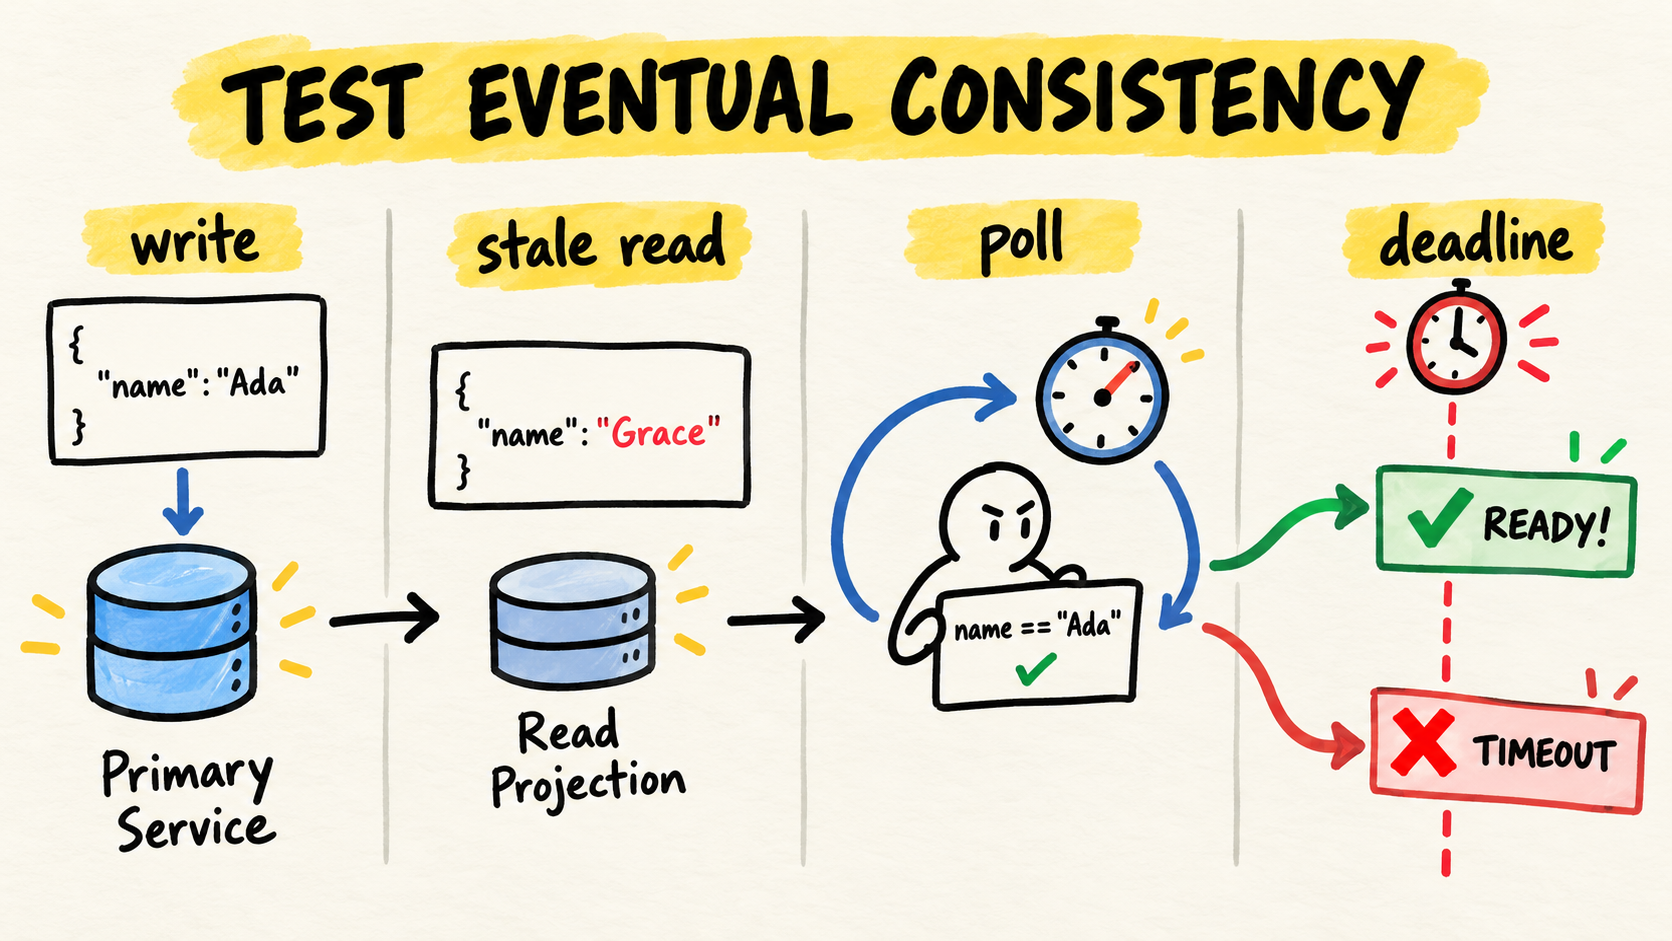
Um teste de agente pode ficar verde porque o mock devolveu exatamente a resposta que você escreveu. O runner talvez nem tenha processado a tool, conferido o estado ou encerrado o loop no lugar certo.
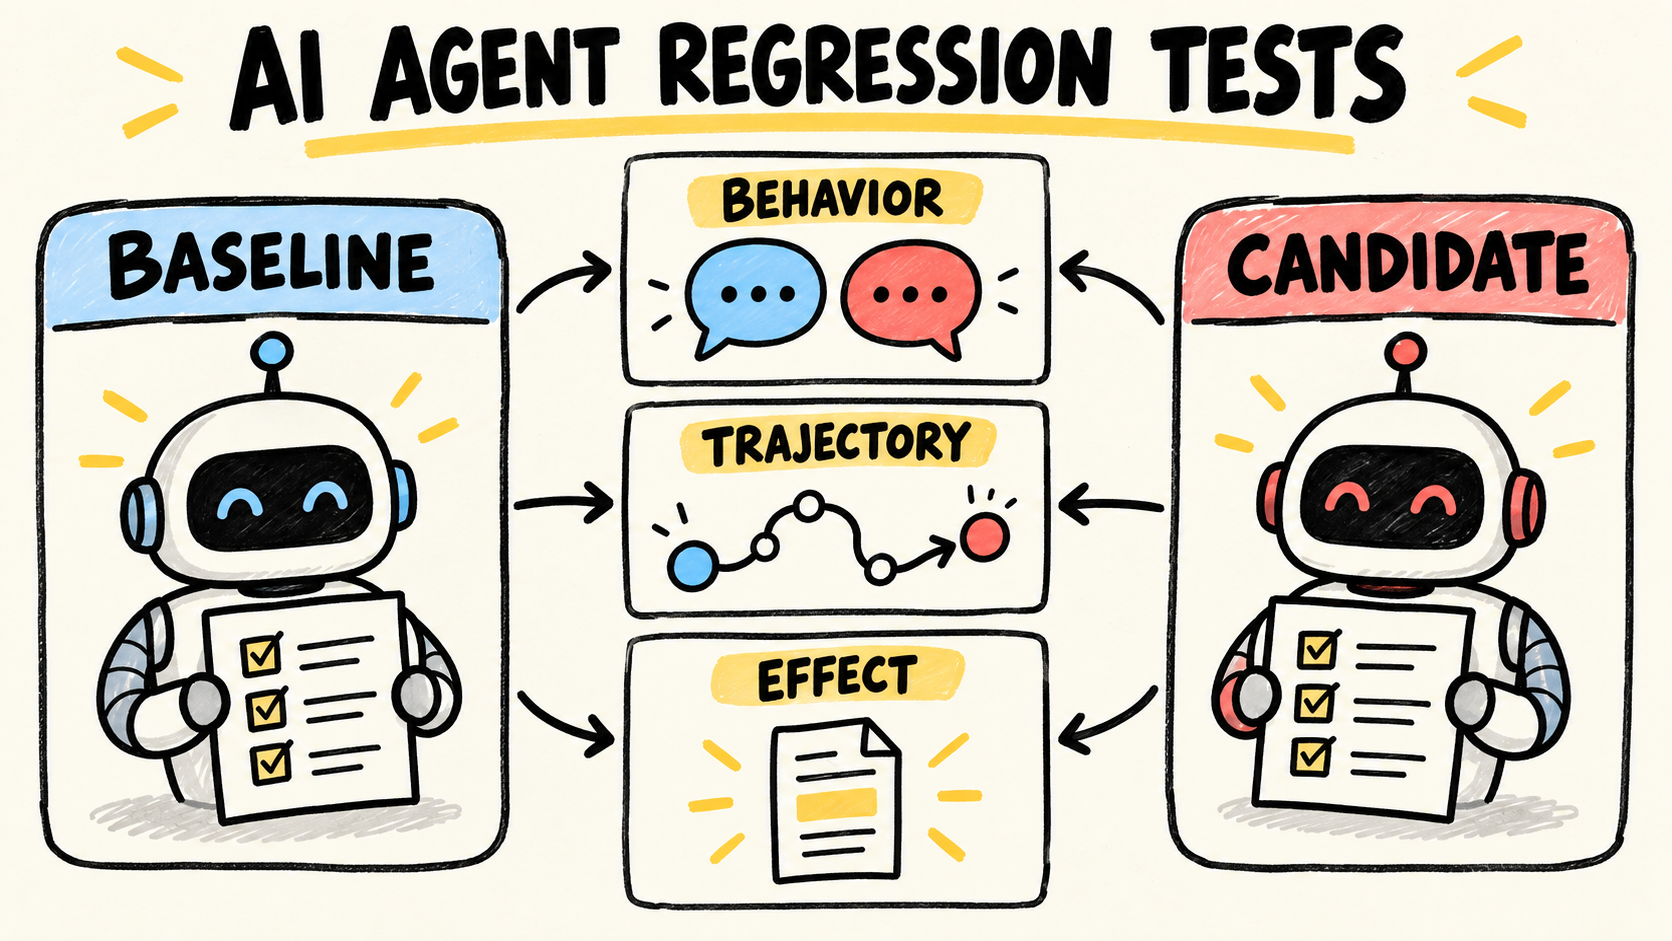
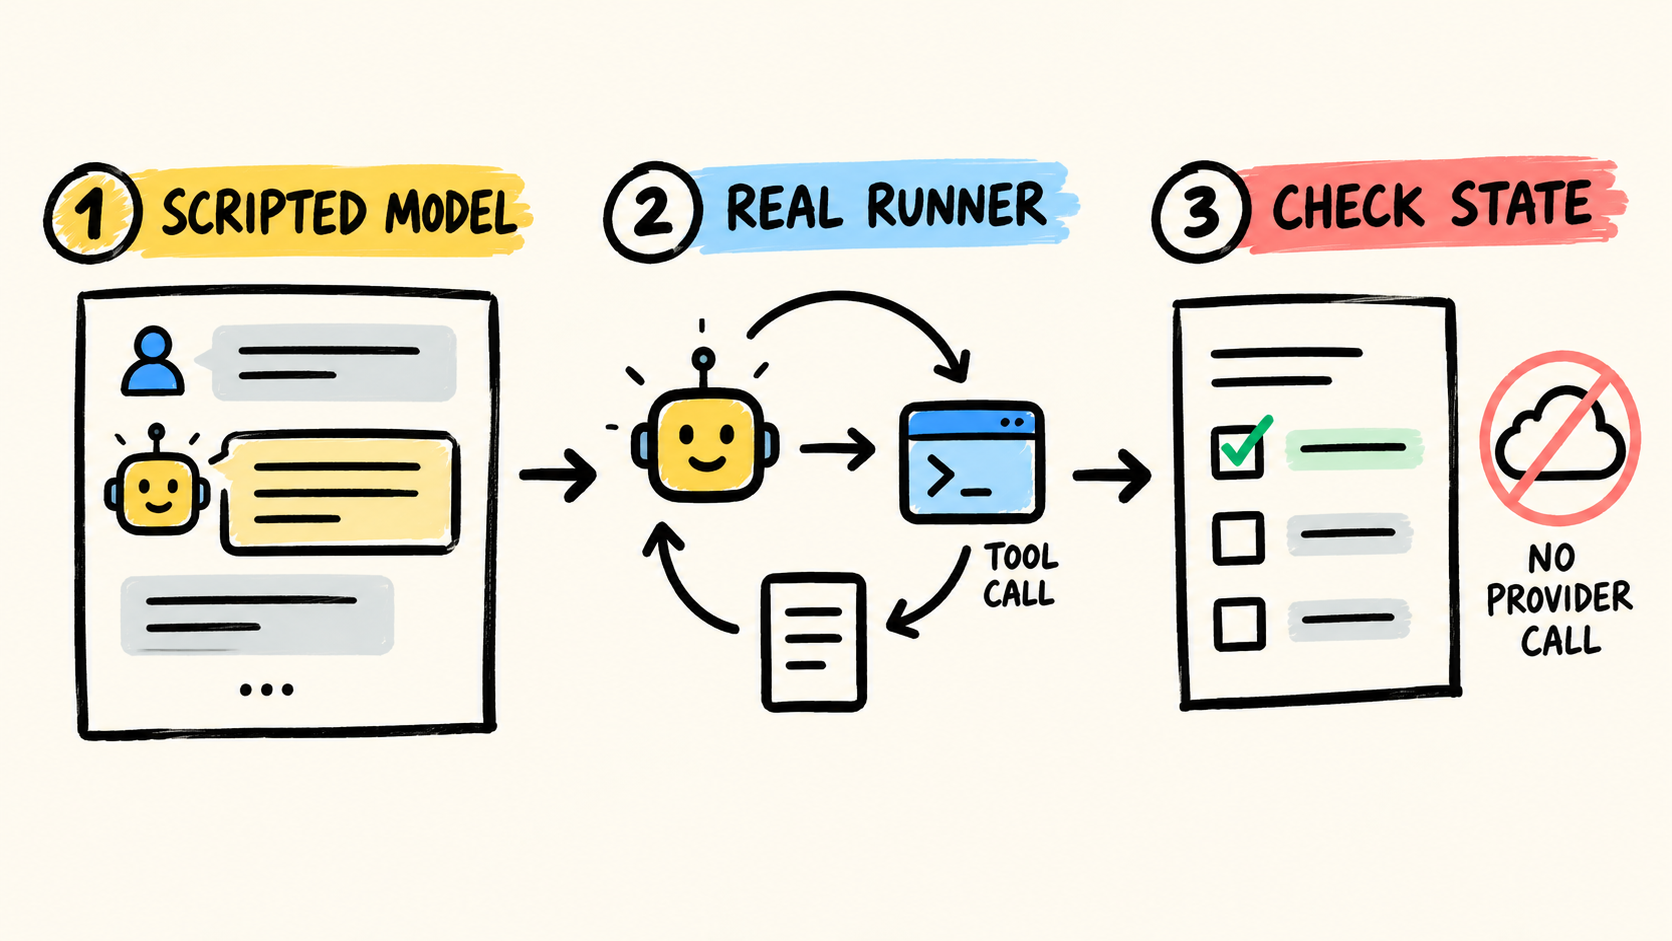
Para testar o código do agente sem fazer uma nova chamada ao provedor, substitua a fronteira do modelo por uma sequência local. Mantenha o runner, o dispatcher e os fakes de estado sob teste. Depois confira a trajetória e o efeito, não apenas a frase final.
Essa é uma camada diferente do teste com mock ou modelo real. O post anterior ajuda a escolher a dependência. Aqui, o foco é montar o teste que roda rápido, não precisa de segredo e mostra exatamente o que ele consegue provar.
Resposta curta
- Troque o cliente do modelo por respostas roteirizadas, não o runner inteiro.
- Use tools falsas, observáveis e sem rede para controlar o cenário.
- Confira chamadas, argumentos, estado e encerramento do loop.
- Reserve o modelo real para testar escolhas, prompts e comportamento emergente.
O que este teste controla e o que ele não controla?
O teste controla a entrada que o runner recebe do modelo e as dependências que ficam sob seu código. Isso permite reproduzir uma chamada de tool, um erro conhecido, uma resposta incompleta ou uma tentativa extra. A documentação da Anthropic, "Demystifying evals for AI agents", descreve tarefas, tentativas, graders e traces como partes separadas de uma avaliação.
Use esta tabela antes de escrever a fixture:
| Pergunta | Fronteira controlada | Evidência esperada |
|---|---|---|
| O runner aceita uma tool call válida? | Modelo roteirizado | Nome e argumentos registrados |
| A resposta da tool volta para o próximo turno? | Tool em memória | Mensagem de tool e próximo passo |
| O loop termina ao receber uma resposta final? | Sequência finita | Nenhuma chamada inesperada |
| O estado produzido está correto? | Repositório em memória | Registro antes e depois |
| O modelo real escolheria essa tool? | Nenhuma, no teste offline | Exige integração ou eval real |
O último item é o limite principal. Um fake prova que seu código sabe lidar com uma decisão conhecida. Ele não prevê como um modelo vai interpretar uma instrução nova. A própria documentação da OpenAI, "Evaluate agent workflows" separa traces, graders, datasets e execuções de avaliação. Não misture essas perguntas no mesmo verde.
Como ligar um modelo roteirizado ao runner real?
Comece pela interface que o runner já precisa. O fake deve conhecer apenas o formato de entrada e saída, e não as regras internas do loop. A cada chamada, ele devolve o próximo passo da sequência. Se o runner pedir um passo que não existe, o teste falha em vez de inventar uma resposta conveniente.
O exemplo abaixo usa somente módulos nativos do Node.js. A documentação do Node.js, "Test runner" suporta testes assíncronos que retornam Promise. A fixture não importa SDK de provedor e não abre uma conexão de rede.
const test = require("node:test");
const assert = require("node:assert/strict");

function scriptedModel(...replies) {
  let position = 0;
  const calls = [];

  return {
    calls,
    async complete(input) {
      calls.push(input);
      const reply = replies[position++];
      if (!reply) throw new Error("unexpected model call");
      return reply;
    },
    assertConsumed() {
      assert.equal(position, replies.length, "the script was not fully consumed");
    },
  };
}
O método assertConsumed é pequeno, mas protege contra um falso verde comum. Se o runner parar cedo e ignorar uma etapa esperada, a fixture precisa denunciar isso. O mesmo vale para uma chamada extra: ela deve falhar antes de chegar a uma dependência externa.
Como manter o loop e as tools sob observação?
O runner continua sendo o objeto importante. Ele lê uma resposta do modelo, despacha a tool, devolve o resultado ao próximo turno e para quando recebe uma resposta final. A tool falsa não deve ser um return fixo escondido. Ela precisa registrar o argumento e alterar um estado pequeno que o teste possa consultar.
async function runAgent({ model, tools, input }) {
  const messages = [{ role: "user", content: input }];
  const trace = [];

  for (let turn = 0; turn < 4; turn += 1) {
    const reply = await model.complete({ messages });

    if (reply.type === "final") {
      return { answer: reply.text, trace };
    }

    if (reply.type !== "tool") {
      throw new Error("invalid model reply");
    }

    const tool = tools[reply.name];
    if (!tool) throw new Error(`unknown tool: ${reply.name}`);

    trace.push({ name: reply.name, args: reply.args });
    const result = await tool(reply.args);
    messages.push({ role: "assistant", content: JSON.stringify(reply) });
    messages.push({ role: "tool", content: JSON.stringify(result) });
  }

  throw new Error("turn limit exceeded");
}

test("runs the real loop with a local scripted model", async () => {
  const orders = new Map([["ord-7", { status: "paid" }]]);
  const calls = [];
  const model = scriptedModel(
    { type: "tool", name: "getOrder", args: { id: "ord-7" } },
    { type: "final", text: "O pedido ord-7 está pago." },
  );

  const result = await runAgent({
    model,
    input: "Qual é o status de ord-7?",
    tools: {
      async getOrder({ id }) {
        calls.push({ name: "getOrder", id });
        return orders.get(id);
      },
    },
  });

  assert.equal(result.answer, "O pedido ord-7 está pago.");
  assert.deepEqual(result.trace, [
    { name: "getOrder", args: { id: "ord-7" } },
  ]);
  assert.deepEqual(calls, [{ name: "getOrder", id: "ord-7" }]);
  assert.equal(model.calls.length, 2);
  model.assertConsumed();
});

test("rejects a tool that is not in the test boundary", async () => {
  const model = scriptedModel({
    type: "tool",
    name: "deleteOrder",
    args: { id: "ord-7" },
  });

  await assert.rejects(
    () => runAgent({ model, input: "Apague ord-7", tools: {} }),
    /unknown tool: deleteOrder/,
  );
  assert.equal(model.calls.length, 1);
});
A documentação do Vitest sobre mocks de funções oferece APIs equivalentes para controlar retornos e observar chamadas. O princípio não depende do Vitest: o modelo é um contrato substituível, enquanto o loop, a tool e o estado continuam visíveis.
Executei esta fixture com Node.js v25.5.0. Ela faz duas chamadas ao fake local, nenhuma chamada ao provedor, e mantém o pedido em uma Map. Isso prova o dispatcher e o contrato do runner neste cenário. Não prova autenticação, serialização de SDK, concorrência, banco de dados ou a escolha de uma tool por um modelo real.
Quais asserções evitam um falso verde?
Comece com sinais observáveis. A resposta final é útil, mas raramente é suficiente para um agente que chama ferramentas. O teste deve dizer qual chamada ocorreu, quais argumentos cruzaram a fronteira, qual estado mudou e por que o loop terminou.
Confira pelo menos:
- Tool permitida: uma chamada desconhecida falha antes do efeito.
- Argumentos: o dispatcher recebe o identificador e os defaults esperados.
- Resultado consumido: a resposta da tool aparece no próximo turno.
- Estado: o registro ou evento produzido tem o valor esperado.
- Encerramento: o runner não faz uma chamada depois da resposta final.
- Limite: uma sequência que nunca termina encontra um número máximo de turnos.
Essas asserções devem ser menores que a implementação. Se o requisito é "consultar o pedido correto", não congele a redação inteira da resposta. Se o requisito é uma confirmação legal exata, a igualdade textual pode fazer parte do contrato. A escolha precisa vir do comportamento que você quer preservar.
Quando a tool tem efeito mutável, use um fake que conte as operações e exponha o estado final. Para um envio de e-mail, por exemplo, registre destinatário e corpo em memória. Para uma atualização, mantenha um registro sintético. Se o teste olha apenas para "feito", ele pode passar sem executar nada ou depois de executar duas vezes.
Como transformar falhas em casos repetíveis?
Uma sequência feliz é o começo, não a suíte. Adicione uma fixture por falha que o runtime precisa saber tratar. O caso deve informar a entrada, o estado inicial, o retorno controlado, o efeito permitido e o resultado esperado.
| Cenário | Resposta controlada | O que conferir |
|---|---|---|
| Tool retorna erro transitório | erro na primeira chamada, sucesso na seguinte | retry limitado e nenhuma chamada extra depois do sucesso |
| Tool retorna payload inválido | objeto sem campo obrigatório | rejeição explícita ou fallback seguro |
| Modelo pede tool inexistente | chamada fora do catálogo | erro antes de qualquer efeito |
| Runner recebe resposta final cedo | final na primeira etapa | zero chamadas posteriores |
| Processo excede o limite | chamadas de tool repetidas | término claro e estado consistente |
O teste de falha não precisa fingir que representa toda a produção. Ele prova uma combinação escolhida. Para uma cobertura mais ampla, complemente com o teste de trajetória do agente e transforme um defeito reproduzido em caso de regressão. Para validar formato e argumentos no limite da tool, use validação de tool calls em TypeScript.
Evite uma armadilha: um fake de ferramenta pode repetir exatamente a suposição do código que deveria testar. Mantenha fixtures simples, valide entradas e inspecione o efeito produzido. Quando o comportamento depende do serviço real, acrescente um teste de integração contra um ambiente isolado. Não transforme a fixture local em certificado de integração.
Como separar o teste offline do eval real no CI?
Rode a camada determinística no pull request. Ela deve funcionar sem chave, rede ou estado compartilhado. Guarde o eval com o modelo real para uma rotina separada, uma mudança de prompt ou uma troca de provedor. Essa divisão deixa claro por que um teste falhou e evita que uma indisponibilidade externa esconda uma regressão no runner.
O teste offline pode provar que uma resposta roteirizada percorre o caminho esperado. O eval real precisa verificar se o modelo escolhe esse caminho diante de linguagem natural. Um não substitui o outro.
No CI, trate como artefato a sequência de chamadas, os argumentos normalizados, o estado inicial, o estado final e a versão do caso. Não publique tokens, segredos ou dados de usuário. Um trace mínimo é mais fácil de revisar e suficiente para entender qual fronteira falhou.
Se a mudança é no próprio verificador, teste o verificador com casos positivos e negativos. Uma suíte que só confirma o caminho feliz pode aceitar um state correto enquanto ignora um efeito duplicado. O teste precisa falhar quando a evidência relevante desaparece.
Checklist antes de confiar na suíte
- O modelo do teste é local, roteirizado e denuncia chamadas inesperadas?
- O runner real continua sendo executado?
- As tools do cenário não acessam a rede nem um banco compartilhado?
- O teste confere nome, argumentos, ordem quando ela for requisito e resultado?
- O estado externo foi representado por uma evidência que o teste consegue ler?
- Há um limite claro para turnos, retries e efeitos?
- Os casos de erro distinguem falha, sucesso desconhecido e payload inválido?
- Está escrito qual pergunta exige um modelo real ou uma integração?
- Uma pessoa consegue investigar o trace sem abrir um segredo?
Se você não consegue responder a última pergunta, o teste talvez esteja verde, mas ainda não esteja ajudando a depurar. A utilidade da camada determinística está na fronteira explícita: ela torna o comportamento do seu código repetível e deixa as incertezas restantes para a camada que pode medi-las.
Conclusão
Para testar um agente sem chamadas extras ao LLM, roteirize a fronteira do modelo e mantenha o restante do runner sob observação. Use tools falsas, estado pequeno e asserções sobre chamadas, argumentos, efeitos e encerramento.
Depois, escreva o limite ao lado do teste. A fixture local prova o comportamento do código diante de uma sequência conhecida. Um eval com modelo real prova outra coisa. Quando as duas camadas têm nomes e critérios próprios, um teste verde informa mais do que apenas "o agente respondeu".
Como este artigo foi produzido
Samuel Fajreldines é o autor responsável por este artigo. A pesquisa comparou a documentação atual da Anthropic, OpenAI, Vitest e Node.js com os owners de testes existentes neste cluster. Discussões públicas foram usadas apenas para linguagem e failure modes, não como prova técnica. A fixture foi executada localmente com Node.js v25.5.0. Ela não chama um provedor, não mede qualidade de modelo e não representa um ambiente de produção.
A ferramenta do autor para manter contexto e evidência entre sessões é o RemoteCode. Ela apoiou o fluxo de escrita, mas não executou a fixture nem provou as afirmações técnicas.
A assistência de IA apoiou descoberta de fontes, comparação, redação, geração da imagem, localização e revisão de consistência. Ela não executou a fixture nem forneceu experiência de produção. O código e os limites descritos foram conferidos no repositório antes da publicação.