O deploy termina verde, mas a primeira requisição recebe erro. Em outro caso, o container está vivo, esperando um banco que voltou a responder, e a probe de liveness reinicia a instância antes que ela se recupere. “Health check” descreve pouco quando a decisão errada está configurada.
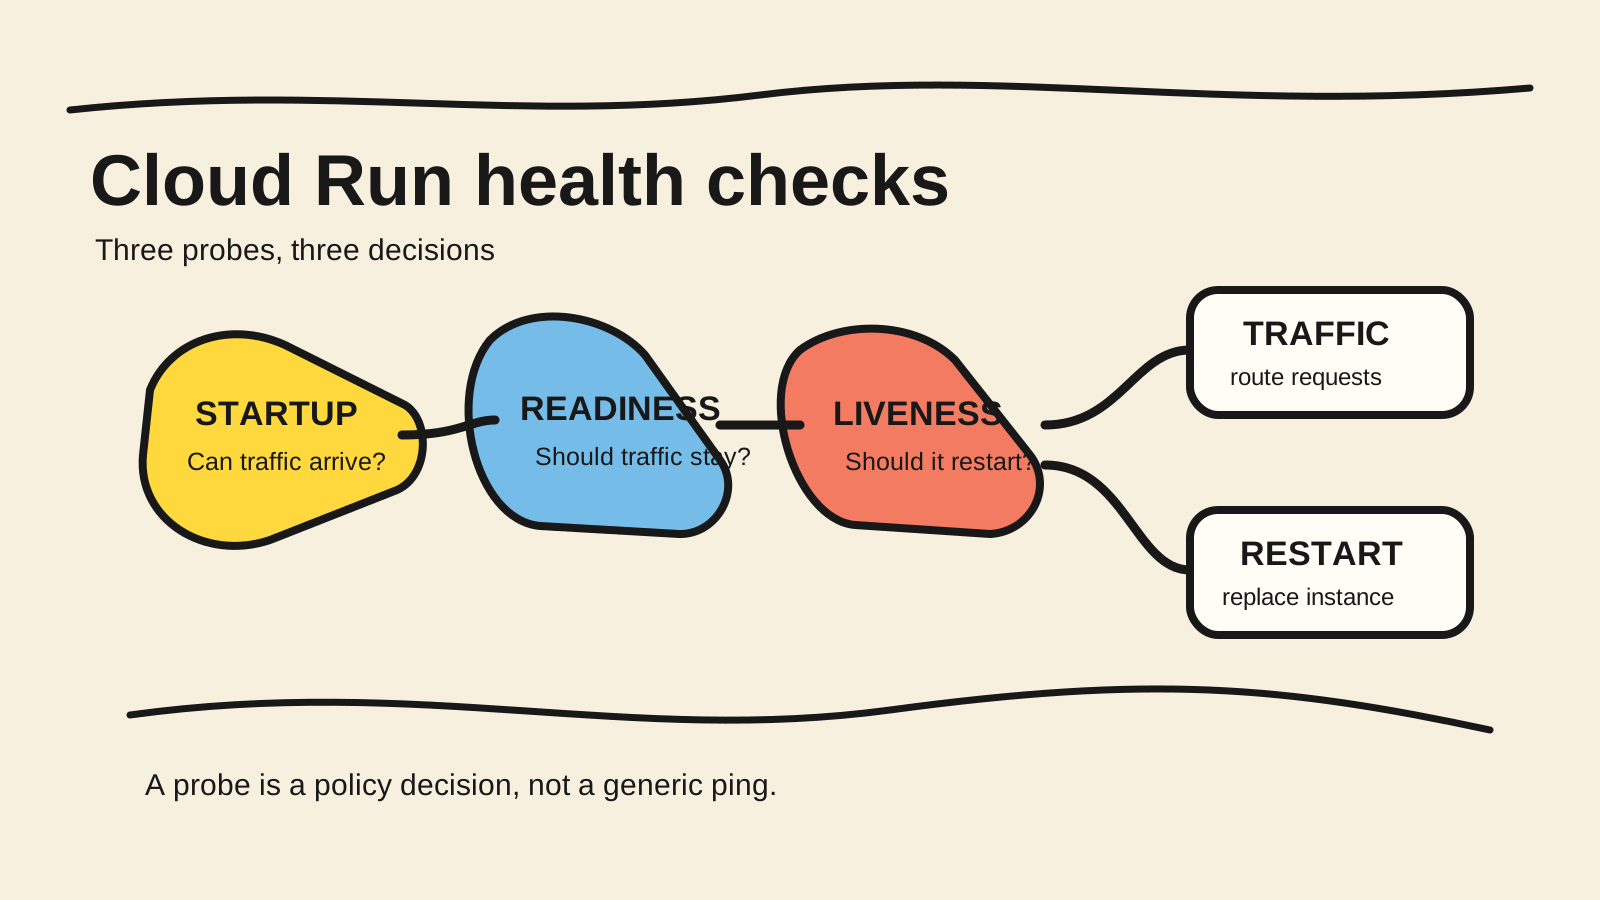
No Cloud Run, startup, readiness e liveness respondem a perguntas diferentes. Startup decide quando o container pode receber tráfego. Readiness decide se uma instância deve continuar recebendo tráfego. Liveness decide se uma instância sem progresso precisa ser reiniciada. Escolha a probe pelo estado que ela protege, não pelo nome do endpoint.
Este artigo transforma essa diferença em uma matriz de diagnóstico, um endpoint Node.js ilustrativo e uma configuração mínima para revisar. Não implantei um serviço Cloud Run para escrever este texto. Os comandos e o YAML são exemplos que precisam ser ajustados e verificados no projeto real.
Resposta curta
- Use startup para proteger a inicialização e evitar que um liveness precoce mate o container.
- Use readiness para retirar uma instância do tráfego sem tratá-la como morta.
- Use liveness para detectar um processo que não consegue mais progredir, como um deadlock.
- Não faça a liveness depender de cada banco, fila ou API externa sem definir o que um restart realmente corrige.
O que cada probe decide no Cloud Run?
Em 2026, a documentação Google Cloud, “Configure container health checks for services”, consultada em 30/09/2026, separa as três probes por consequência operacional. Startup libera a transição para receber tráfego, readiness controla o envio de novas requisições e liveness pode encerrar a instância para que outra seja iniciada.
| Probe | Pergunta | Falha típica | Consequência |
|---|---|---|---|
| Startup | O processo terminou a inicialização segura? | porta fechada, imports incompletos, configuração essencial ausente | o container não é liberado e pode ser encerrado |
| Readiness | Esta instância deve receber tráfego agora? | modo de drenagem, dependência temporariamente indisponível | o Cloud Run deixa de enviar tráfego novo |
| Liveness | O processo ainda consegue progredir? | deadlock ou loop sem avanço | o container pode ser reiniciado |
Os nomes não são intercambiáveis. Uma aplicação pode estar viva e ainda não pronta. Também pode estar pronta para responder, mas travada depois de algumas horas. Se o mesmo endpoint responde “200” para todos os estados, a plataforma perde a informação que deveria orientar a ação.
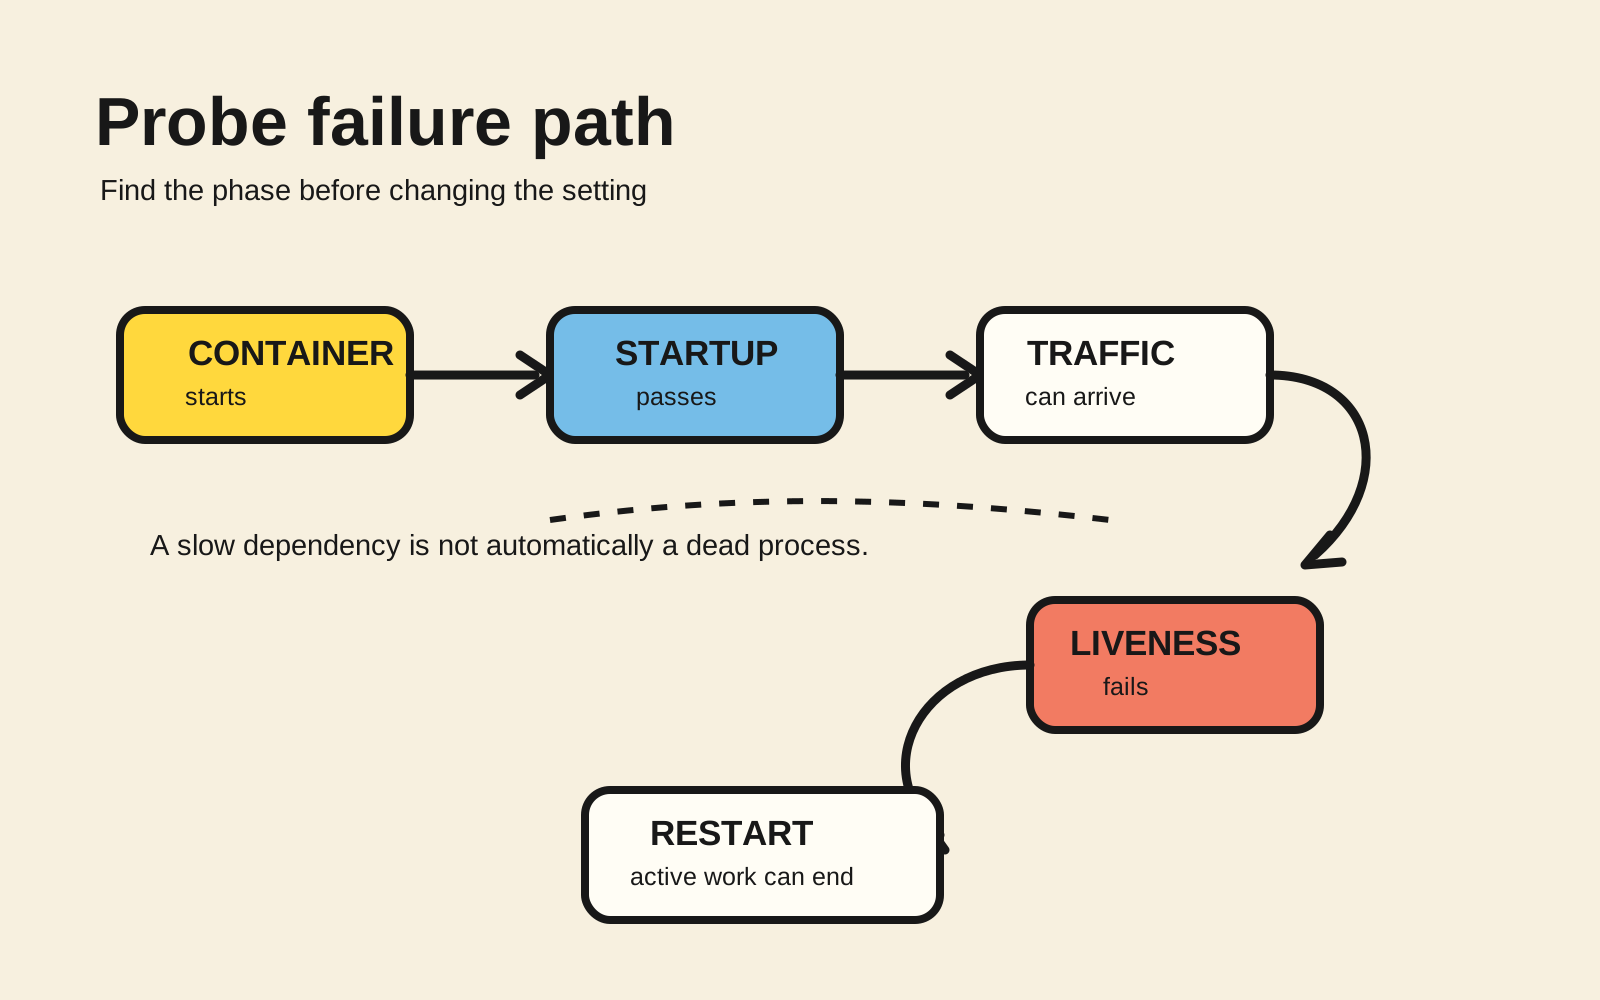
O Cloud Run trata o startup com cuidado: quando ele existe, as probes de liveness e readiness ficam desativadas até o startup passar. A própria documentação recomenda que o startup prove uma condição suficiente para receber tráfego, porque uma instância pode receber uma requisição antes da primeira checagem de readiness terminar.
Por que startup deve vir antes de liveness?
Um processo lento não é necessariamente um processo travado. Se a aplicação carrega um modelo, restaura configuração ou abre conexões antes de servir, o startup deve representar esse ponto de prontidão. Um liveness agressivo durante a inicialização pode criar um ciclo em que o container é reiniciado antes de completar o trabalho.
O padrão TCP do Cloud Run verifica se o processo abriu a porta. Na documentação atual, quando nenhuma startup probe é configurada, o serviço recebe uma configuração TCP padrão com timeoutSeconds: 240, periodSeconds: 240 e failureThreshold: 1 (Google Cloud, “Configure container health checks for services”, consultada em 30/09/2026). Esse padrão confirma a porta, não a disponibilidade de cada dependência.
Para uma aplicação que precisa de uma condição mais forte, use HTTP ou gRPC. Uma startup HTTP considera sucesso uma resposta 2xx ou 3xx; qualquer outra resposta falha. O endpoint precisa estar no HTTP/1 e o caminho configurado deve existir no container. Um status positivo deve significar que a instância já pode atender com segurança, não apenas que o processo abriu um socket.
Como desenhar endpoints que não criam um loop de restart?
O endpoint de liveness deve ser barato e local. Ele precisa detectar um estado que o restart pode corrigir. Se ele consulta o banco a cada chamada e o banco fica indisponível, todas as instâncias podem parecer mortas ao mesmo tempo. O sistema troca uma falha de dependência por uma fila de reinícios.
Um servidor Node.js pode separar os estados. O exemplo abaixo é ilustrativo e não usa um framework específico:
import http from 'node:http';

let started = false;
let acceptingTraffic = false;
let stuck = false;

const server = http.createServer((request, response) => {
  if (request.url === '/startup') {
    response.statusCode = started ? 204 : 503;
  } else if (request.url === '/ready') {
    response.statusCode = acceptingTraffic ? 204 : 503;
  } else if (request.url === '/live') {
    response.statusCode = stuck ? 503 : 204;
  } else {
    response.statusCode = 404;
  }

  response.end();
});

server.listen(process.env.PORT || 8080, '0.0.0.0', () => {
  started = true;
  acceptingTraffic = true;
});
O exemplo mostra a separação, não uma política pronta. Em um serviço real, started deve mudar depois da inicialização que o tráfego exige. acceptingTraffic deve mudar durante drenagem e recuperação. stuck precisa representar uma condição que o processo não consegue corrigir sozinho. Não retorne detalhes internos nem credenciais no corpo da resposta.
A documentação do Google Cloud informa que endpoints HTTP de health check são externamente acessíveis e seguem os mesmos princípios de qualquer endpoint exposto. Por isso, mantenha a resposta mínima, não confie em segredo escondido no caminho e use headers configuráveis quando o seu desenho realmente precisar deles. O endpoint não deve virar um relatório público da arquitetura.
Quando usar TCP, HTTP ou gRPC?
TCP prova apenas que existe um socket aceitando conexão. É um bom começo para um processo simples, mas não sabe se o roteamento interno, a configuração necessária ou o estado da aplicação terminou de carregar. O Cloud Run pode aplicar TCP, HTTP e gRPC em startup; liveness e readiness também têm formas HTTP e gRPC documentadas.
HTTP é útil quando a decisão cabe em um endpoint pequeno. Ele permite diferenciar 204 de 503, expor uma regra clara e testar localmente com curl. Não use a rota principal como probe se ela consulta dados, exige autenticação de usuário ou produz efeitos colaterais.
gRPC faz sentido quando o serviço já implementa o protocolo de health checking. A configuração precisa apontar para a porta e, quando aplicável, para o serviço gRPC correto. Não adicione gRPC apenas para chamar a mesma dependência de outro jeito. A probe deve continuar barata e determinística.
O tipo de probe não corrige uma configuração errada. Uma porta diferente da porta que o processo escuta, um path ausente ou um timeout menor que o tempo de inicialização produzem falhas que parecem indisponibilidade da aplicação. Verifique primeiro a interface que o container realmente expõe.
Como configurar e verificar uma revisão?
A configuração cria uma nova revisão do serviço. Use YAML, Terraform ou a CLI documentada pelo Google Cloud, mas mantenha o exemplo pequeno o suficiente para revisar no diff. Esta versão ilustra uma startup HTTP e uma liveness HTTP:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: example-service
spec:
  template:
    spec:
      containers:
        - image: REGION-docker.pkg.dev/PROJECT/REPOSITORY/IMAGE:TAG
          ports:
            - containerPort: 8080
          startupProbe:
            httpGet:
              path: /startup
              port: 8080
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 12
          livenessProbe:
            httpGet:
              path: /live
              port: 8080
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 3
Os valores não são uma recomendação universal. Eles só tornam explícitas as perguntas do exemplo. A documentação do Cloud Run limita o timeout ao período configurado e indica 3 como valor padrão para failureThreshold em probes configuradas. Ajuste o tempo à inicialização observada e ao custo de encerrar uma instância que ainda atende requisições.
Depois do deploy, verifique a revisão e os logs do container. Confirme o nome da revisão, a imagem, a porta, o path, os eventos de falha da probe e o momento em que o startup passou. Teste os endpoints localmente antes de procurar uma causa no Cloud Run:
curl -i http://localhost:8080/startup
curl -i http://localhost:8080/live
Em produção, um 503 de liveness pode encerrar requisições que ainda estavam sendo atendidas. A referência do Google Cloud descreve esse efeito e o início de uma nova instância depois do encerramento. Faça a primeira falha em uma revisão sem tráfego crítico e confirme que o resultado observado corresponde ao contrato que você queria testar.
Quais falhas devem entrar no teste?
Teste cada transição que muda a ação da plataforma. Uma suíte curta é mais informativa quando cada caso tem uma expectativa explícita:
| Cenário | O que simular | Resultado esperado |
|---|---|---|
| inicialização lenta | atrasar started além da primeira tentativa |
startup continua falhando até a condição existir |
| path incorreto | configurar /health e servir apenas /live |
a revisão denuncia a incompatibilidade |
| porta errada | escutar fora da porta configurada | startup TCP ou HTTP não passa |
| dependência fora do ar | fazer o banco falhar sem travar o processo | readiness pode retirar tráfego; liveness não deve reiniciar sem motivo |
| deadlock | manter o processo vivo, mas sem progresso | liveness falha e o restart é observável |
| drenagem | marcar acceptingTraffic como falso |
readiness deixa de aceitar tráfego novo |
O teste do deadlock precisa provar que o restart ajuda. Se a causa está em uma configuração persistida ou em um banco indisponível, criar outra instância não resolve. Nesse caso, o alerta e a recuperação devem apontar para a dependência, não esconder o evento em reinícios sucessivos.
O que um health check não prova?
Uma probe prova apenas a condição que você codificou. Um 204 em /live não confirma que a consulta principal está correta, que a fila tem mensagens, que as credenciais funcionam ou que os usuários conseguem concluir uma operação. Uma readiness que deixa de receber tráfego também não corrige o estado que causou a falha.
O guia geral sobre health checks em Google Cloud e AWS explica o papel mais amplo de monitoramento, uptime e load balancer. No Cloud Run, essa probe interna é apenas uma camada. Use métricas, logs, traces e uma verificação externa quando a pergunta for “o usuário consegue completar o fluxo?”.
Também não misture probe de serviço com capacidade. A escolha de concorrência no Cloud Run trata de quantas requisições uma instância sustenta. Um serviço pode estar pronto para receber tráfego e ainda ficar lento sob concorrência alta. O diagnóstico de cold start com min instances e CPU boost trata de outro ponto da espera. Se o restart interromper trabalho ativo, veja também como lidar com SIGTERM no Cloud Run antes de escolher liveness.
Perguntas frequentes
Readiness e liveness são a mesma coisa no Cloud Run?
Não. Readiness controla se a instância deve continuar recebendo tráfego. Liveness indica que a instância precisa ser reiniciada. Na documentação consultada em 30/09/2026, readiness aparece como recurso Preview e a falha pode retirar tráfego sem terminar a instância, enquanto liveness pode encerrá-la após falhas repetidas (Google Cloud, “Configure container health checks for services”).
Posso colocar uma consulta ao banco na liveness?
Só se o contrato provar que reiniciar a instância corrige a falha. Se o banco está fora do ar, cada instância pode falhar ao mesmo tempo e entrar em reinício. Em geral, mantenha a liveness local e use readiness, métricas e alertas para dependências externas. O desenho certo depende de qual estado a sua aplicação consegue reparar.
Startup probe substitui readiness?
Não completamente. Startup define quando a instância terminou a inicialização e pode começar a receber tráfego. Readiness pode retirar tráfego depois disso e permitir que a instância volte quando o estado melhorar. O Cloud Run recomenda que o startup seja suficiente para receber tráfego, porque uma requisição pode chegar antes da primeira checagem de readiness terminar.
Conclusão
Escolha a probe pela ação que uma falha deve provocar. Startup protege a entrada no serviço. Readiness controla a participação temporária no tráfego. Liveness reinicia um processo que não consegue mais progredir. Um endpoint comum com três nomes diferentes não cria essas decisões sozinho.
Configure uma revisão pequena, teste porta e path, simule uma inicialização lenta, retire uma dependência e provoque um estado sem progresso. Se o restart não corrige a causa, não o transforme em liveness. A melhor health check é a que dá à plataforma uma decisão segura, não a que retorna verde para tudo.
Como esta análise foi feita
Samuel Fajreldines é o autor responsável por este artigo. A pesquisa comparou a documentação atual do Google Cloud sobre health checks e o contrato de containers, a documentação do Kubernetes sobre semântica de probes, o histórico de posts do site e discussões públicas recentes. Não houve deploy ou benchmark de Cloud Run. O código e o YAML são ilustrativos. A assistência de IA apoiou descoberta, redação, geração das imagens e revisão de consistência, mas não executou a configuração nem substituiu a verificação das fontes.
Fontes consultadas
- Google Cloud, “Configure container health checks for services”, consultado em 2026-09-30
- Google Cloud, “Configure container health checks for instances”, consultado em 2026-09-30
- Google Cloud, “Container runtime contract”, consultado em 2026-09-30
- Kubernetes, “Configure liveness, readiness and startup probes”, consultado em 2026-09-30
- Node.js, “HTTP”, consultado em 2026-09-30