Una lista que cabe en una respuesta no es necesariamente una lista completa. Si una tool MCP devuelve solo los primeros registros sin decir que hay más datos, un agente puede responder con seguridad a partir de una muestra. Si devuelve todo, el coste de la llamada crece justo cuando el conjunto deja de caber cómodamente en el contexto.
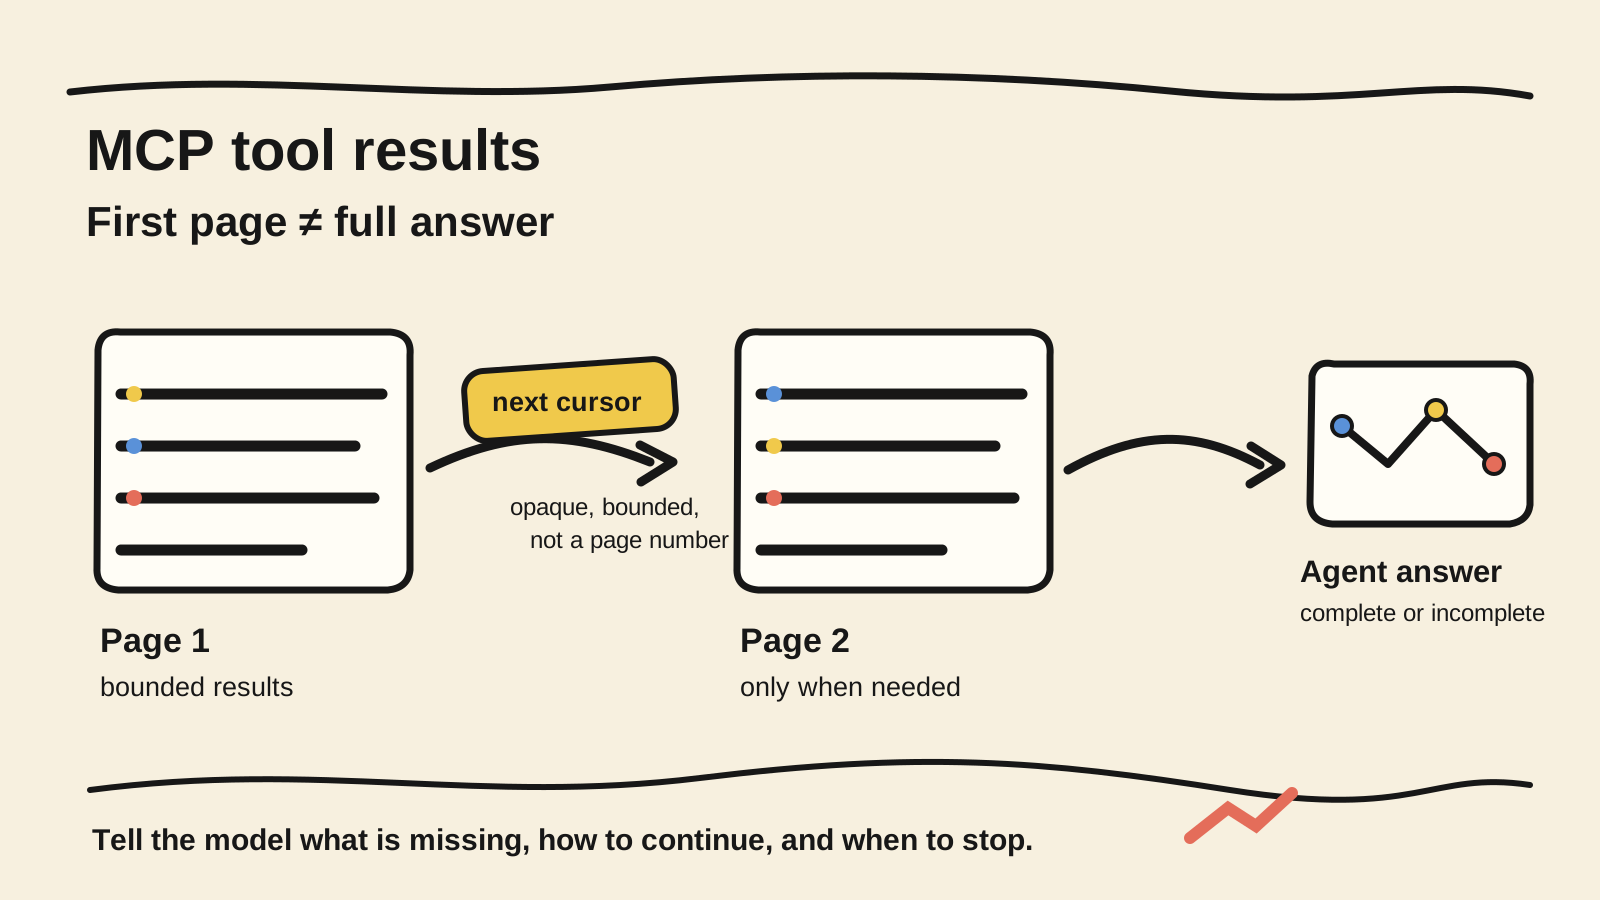
La solución es tratar la paginación como parte del contrato de la tool: devuelve una página limitada, un orden estable, un cursor opaco y una señal explícita de completitud. El agente continúa solo cuando existe una razón para buscar más. Antes de exponer una tool por red, la guía para alojar un servidor MCP remoto en TypeScript con HTTP ayuda a separar transporte, autenticación y ejecución. Este artículo cubre otra frontera: qué promete el resultado.
El código siguiente es una fixture local de Node.js. No llama a un modelo ni a un servidor MCP real. Su objetivo es demostrar la política de paginación, no medir un proveedor.
Regla de diseño
- Una página es un fragmento del resultado, no una respuesta completa.
- El cursor debe ser opaco para el cliente y válido solo para la consulta y el snapshot que controla el servidor.
- La respuesta debe decir si existen más datos, sin obligar al modelo a deducirlo por el tamaño de la lista.
- Filtrar en el servidor, agregar o generar un archivo puede ser mejor que paginar miles de filas dentro del contexto.
El problema está en el significado, más allá del tamaño
El fallo más peligroso no es una respuesta demasiado grande. Es una respuesta parcial que parece final. Un campo items con diez registros no dice si existen diez registros en total, si el servidor aplicó un límite o si la consulta encontró exactamente ese conjunto.
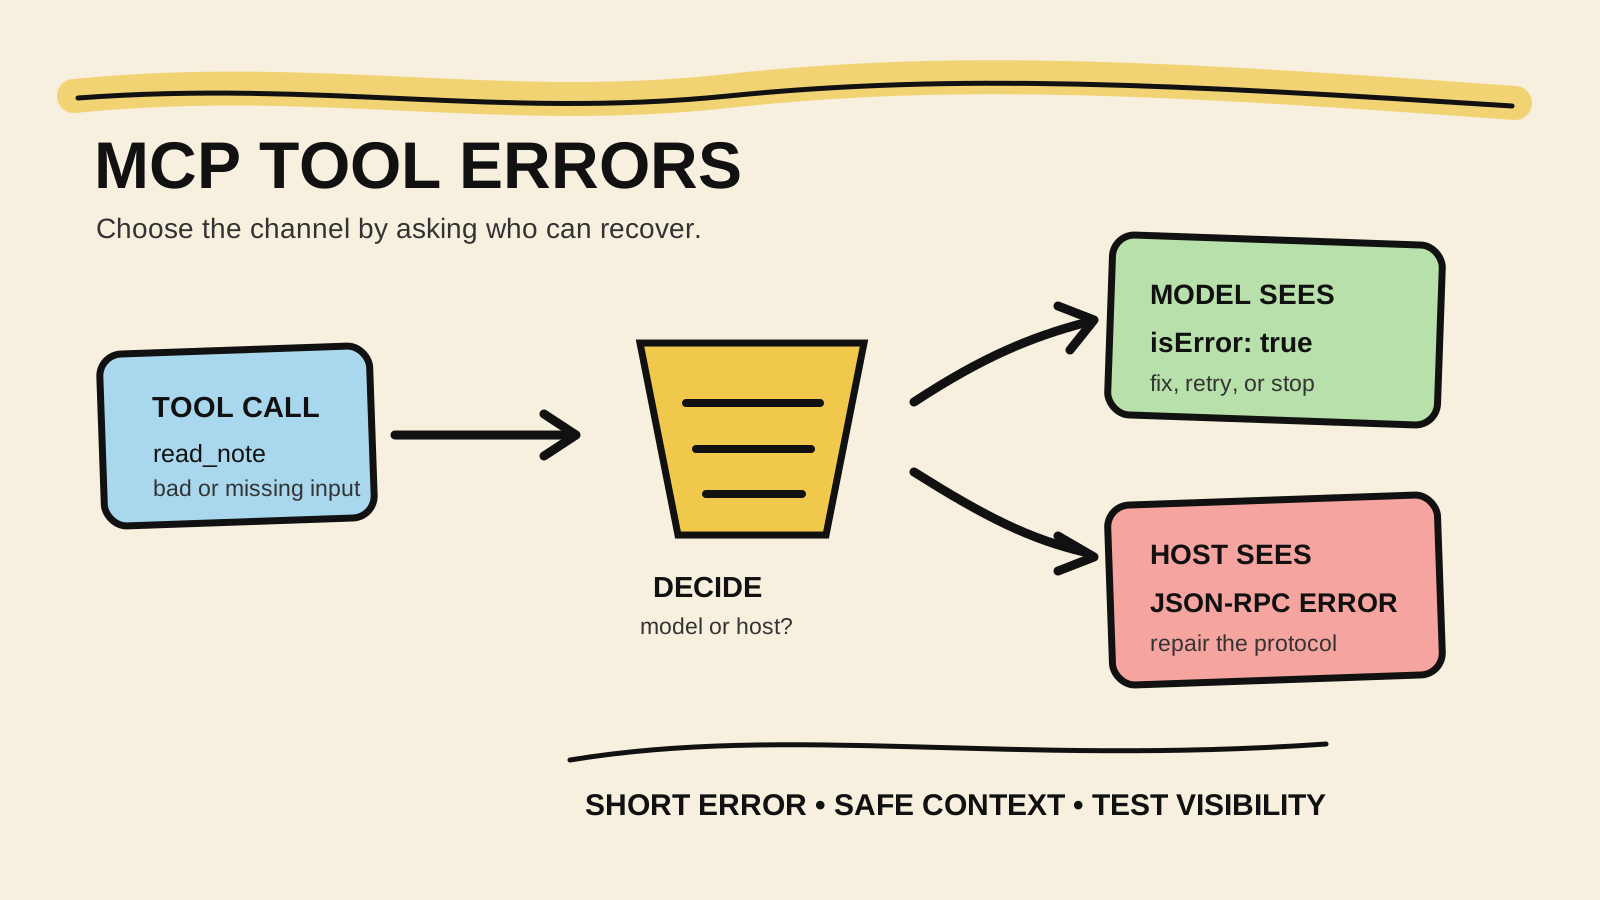
Ese significado tampoco debe quedar escondido en una instrucción vaga dentro de la descripción de la tool. El runtime debe poder registrar si la respuesta estaba completa y el agente debe recibir esa información junto con los datos. Si la tool responde "qué pedidos están atrasados", el resultado debe llevar la condición que permite o impide afirmar "todos".
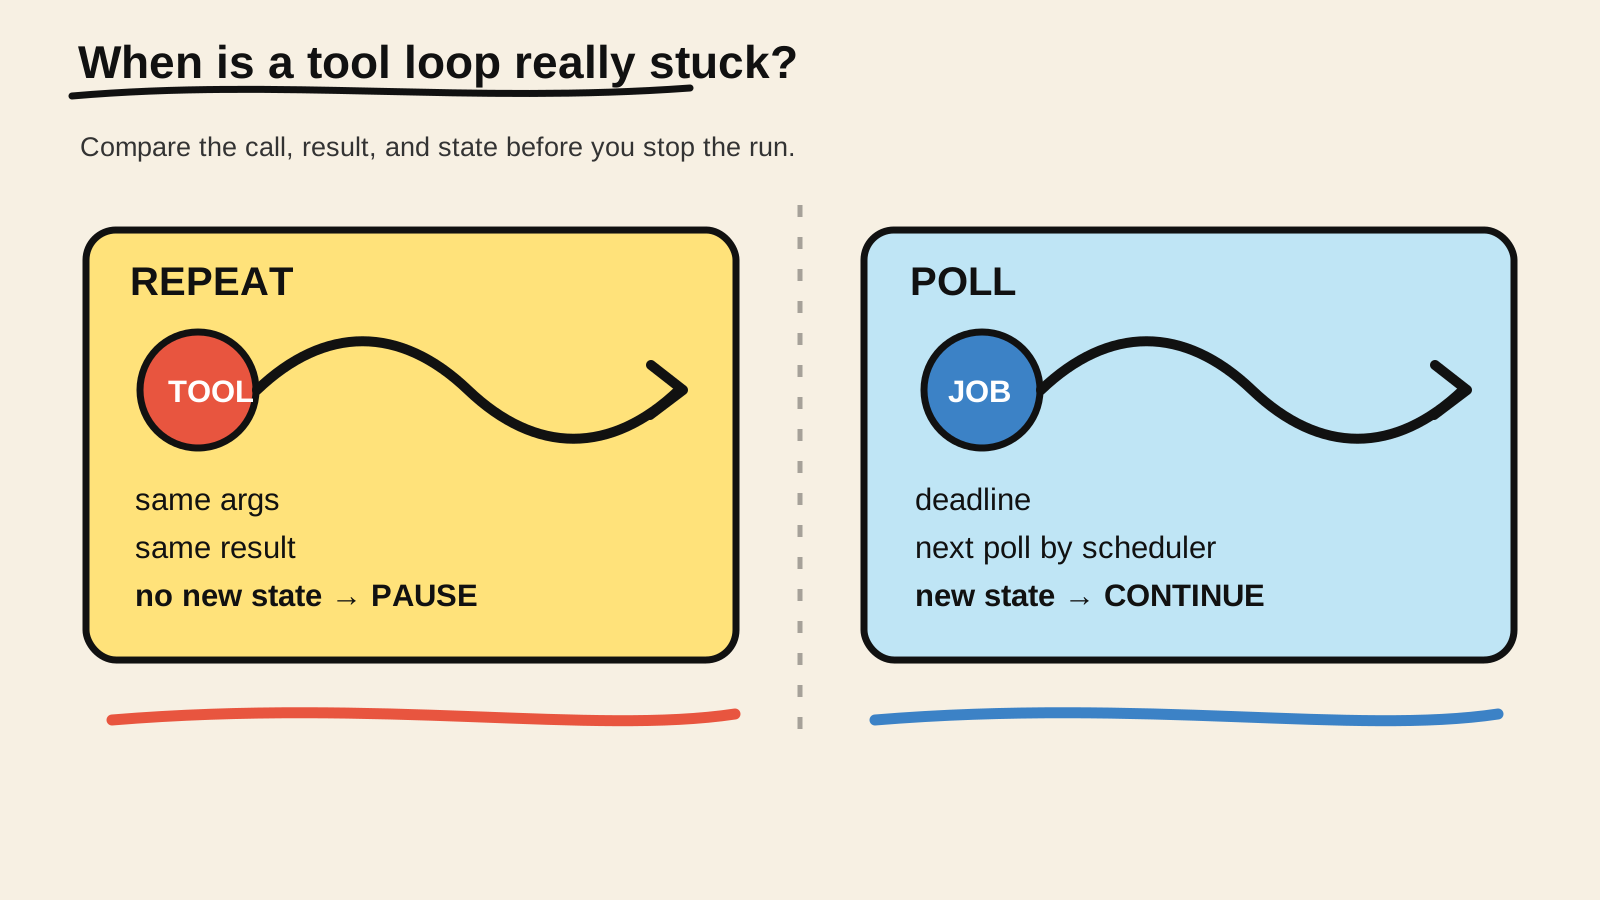
Hay otro riesgo: dejar que el modelo decida por sí solo cuántas páginas leer. Sin un límite por ejecución, la tool puede consumir llamadas repetidas para recorrer un conjunto que debería haberse filtrado en el servidor. El detector de tool calls repetidas y polling legítimo resuelve otro problema, pero la misma idea se aplica aquí: el runtime debe conocer la condición de parada.
Separa la paginación del protocolo de la paginación de resultados
MCP ya tiene paginación para las operaciones de lista del protocolo. La documentación del cliente TypeScript muestra que listTools() sigue nextCursor para agregar páginas de herramientas y también permite acceder a una página concreta con un cursor guardado (MCP TypeScript SDK, "client calling", consultado el 20 de noviembre de 2026). Eso cubre el descubrimiento de tools, prompts, resources y templates.
Este mecanismo no convierte automáticamente la respuesta de una herramienta de negocio en una colección navegable. Una tool como search_orders todavía tiene que definir el formato de página, el significado del cursor, el orden de los registros y la política de continuación. Mezclar los dos contratos crea una suposición peligrosa: nextCursor en tools/list no garantiza que tools/call sepa devolver el resto de search_orders.
Si la implementación usa el SDK actual de TypeScript, structuredContent y outputSchema pueden hacer explícito el contrato de salida para la aplicación y el cliente (MCP TypeScript SDK, "server API", consultado el 20 de noviembre de 2026). El schema tampoco decide si la primera página es suficiente. Solo hace que la decisión se pueda representar y comprobar.
¿Qué debe contener una página de resultados?
Empieza por un envelope pequeño. Los nombres pueden cambiar, pero el significado debe mantenerse estable:
| Campo | Responsabilidad |
|---|---|
items |
Registros de esta página, ya limitados por el presupuesto de la tool. |
nextCursor |
Token opaco para pedir la página siguiente; falta cuando no hay continuación. |
complete |
true solo cuando el servidor sabe que la consulta terminó para este snapshot. |
snapshot |
Identificador o versión usada para mantener coherente la consulta cuando hace falta. |
notice |
Texto corto para el modelo, especialmente cuando el resultado está incompleto o necesita un filtro. |
complete puede parecer redundante junto a nextCursor, pero hace que la intención sea legible. Un cursor puede caducar, ser rechazado o desaparecer en una capa intermedia. El llamador no debería afirmar "todos" solo porque recibió menos elementos que el límite.
No devuelvas total por costumbre. Un total exacto puede requerir una consulta cara, quedar obsoleto antes de la página siguiente o sugerir una precisión que el backend no garantiza. Si la decisión necesita un total, documenta cuándo se calcula y qué snapshot representa.
Cómo mantener estable y seguro el cursor
El cursor no es un número de página para que el agente lo interprete. Es un comprobante de continuación emitido por el servidor. Puede contener la versión del snapshot, la última clave ordenada y una firma. El cliente solo debe devolverlo.
Tres reglas evitan la mayoría de los problemas:
- Usa un orden determinista. Una consulta que cambia de orden entre llamadas puede repetir registros o saltárselos.
- Valida el cursor en el servidor. Rechaza tokens malformados, de otra consulta o de un snapshot incompatible. No aceptes un
offsetenviado libremente si puede atravesar los límites de otro tenant. - Define una vida útil. Un cursor puede caducar cuando desaparece su snapshot. La respuesta debe indicar que la consulta tiene que empezar de nuevo, en vez de continuar desde una posición que ya no representa el mismo conjunto.
Un cursor puede codificarse en Base64URL para transportarlo, pero codificarlo no es autenticarlo. Si su posición revela datos sensibles o puede modificarse para acceder a otro tenant, firma su contenido o guarda el estado en el servidor detrás de una referencia aleatoria.
Fixture de Node.js: página, cursor y completitud
La fixture siguiente usa una lista fija para que la verificación sea reproducible. En producción, sustituye orders por una consulta con orden estable y define cómo conservarás el snapshot. El cursor sigue siendo un detalle del servidor.
import assert from "node:assert/strict";

const orders = [
  { id: "ord-101", status: "late" },
  { id: "ord-102", status: "paid" },
  { id: "ord-103", status: "late" },
  { id: "ord-104", status: "open" },
  { id: "ord-105", status: "late" },
];

const SNAPSHOT = "orders-v1";
const MAX_PAGE_SIZE = 2;

function encodeCursor(cursor) {
  return Buffer.from(JSON.stringify(cursor)).toString("base64url");
}

function decodeCursor(value) {
  try {
    const cursor = JSON.parse(Buffer.from(value, "base64url").toString("utf8"));
    if (cursor.snapshot !== SNAPSHOT || typeof cursor.afterId !== "string") {
      throw new Error("cursor does not belong to this result set");
    }
    return cursor;
  } catch (error) {
    throw new Error(`invalid cursor: ${error.message}`);
  }
}

function listLateOrders({ cursor, limit = MAX_PAGE_SIZE } = {}) {
  const pageSize = Math.min(Math.max(limit, 1), MAX_PAGE_SIZE);
  const filtered = orders
    .filter((order) => order.status === "late")
    .sort((a, b) => a.id.localeCompare(b.id));

  const start = cursor
    ? filtered.findIndex((order) => order.id === decodeCursor(cursor).afterId) + 1
    : 0;
  if (cursor && start === 0) throw new Error("cursor points outside the snapshot");

  const items = filtered.slice(start, start + pageSize);
  const last = items.at(-1);
  const nextCursor = last && start + items.length < filtered.length
    ? encodeCursor({ snapshot: SNAPSHOT, afterId: last.id })
    : undefined;

  return {
    items,
    nextCursor,
    complete: nextCursor === undefined,
    snapshot: SNAPSHOT,
    notice: nextCursor
      ? "More matching orders exist. Continue only if the task needs all of them."
      : "This result is complete for the current snapshot.",
  };
}

const first = listLateOrders();
assert.deepEqual(first.items.map((item) => item.id), ["ord-101", "ord-103"]);
assert.equal(first.complete, false);
assert.equal(typeof first.nextCursor, "string");

const second = listLateOrders({ cursor: first.nextCursor });
assert.deepEqual(second.items.map((item) => item.id), ["ord-105"]);
assert.equal(second.complete, true);
assert.equal(second.nextCursor, undefined);

assert.deepEqual(
  [...first.items, ...second.items].map((item) => item.id),
  ["ord-101", "ord-103", "ord-105"],
);
assert.throws(() => listLateOrders({ cursor: "not-a-cursor" }), /invalid cursor/);

console.log("pagination fixture passed");
Guárdala como mcp-pagination-fixture.mjs y ejecútala:
node mcp-pagination-fixture.mjsLa prueba demuestra cuatro propiedades locales: el orden es estable, la primera página declara que está incompleta, la segunda no repite registros y un cursor inválido se rechaza. No demuestra que todos los clientes MCP sigan la página siguiente ni que un snapshot de producción siga disponible durante el tiempo necesario.
¿Cómo debe exponer la tool este envelope?
El adaptador MCP debe devolver el envelope como datos estructurados y una explicación breve para el modelo. Los detalles exactos dependen de la generación del SDK, así que el ejemplo siguiente es deliberadamente ilustrativo:
const result = listLateOrders(args);

return {
  content: [{
    type: "text",
    text: result.complete
      ? "The result is complete for this snapshot."
      : "The result is partial. Use nextCursor only when more records are needed.",
  }],
  structuredContent: result,
};
La guía de pruebas de contrato para servidores MCP en TypeScript es el lugar adecuado para añadir las comprobaciones de descubrimiento, schema y llamada. Incluye al menos un caso que compruebe complete: false, otro que use el cursor recibido y otro que demuestre que una respuesta incompleta no se describe como una lista final.
Si la tool declara outputSchema, el schema debe representar también los estados de continuación y error que el cliente necesita manejar. No uses una instrucción de texto escondida como única fuente de verdad. El texto ayuda al modelo; la estructura permite que el host, la prueba y el log tomen decisiones sin analizar prosa.
¿La paginación siempre es la mejor interfaz?
No. La decisión depende de lo que el agente necesite hacer con los datos:
| Necesidad | Interfaz preferible | Motivo |
|---|---|---|
| Encontrar pocos candidatos | Búsqueda filtrada con un límite pequeño | El servidor reduce el conjunto antes de usar el contexto. |
| Comparar todos los registros | Agregación en el servidor | El modelo recibe el resultado de la operación, no miles de filas. |
| Exportar o reconciliar todo | Archivo o handle de exportación | Los datos completos pueden procesarse fuera de la conversación. |
| Explorar un conjunto moderado | Paginación con cursor | El agente puede continuar de forma explícita y limitada. |
| Esperar un cambio externo | Polling con scheduler y deadline | El siguiente momento no queda bajo el control libre del modelo. |
Esta elección aparece en discusiones de practicantes sobre tratar una página como el conjunto completo y paginar una tool que devuelve muchos registros. Usa esos relatos para reconocer síntomas y vocabulario, no como prueba de que una estrategia sea siempre mejor.
La guía sobre RAG de codebase con MCP para agentes que no deben leerlo todo parte de una premisa parecida: recuperar solo el contexto relevante suele ser mejor que volcar todo el repositorio en el modelo. Para datos transaccionales, la forma concreta puede ser filtro, orden, agregación o exportación, pero el principio es el mismo: el agente no debe usar el contexto como una base de datos accidental.
¿Qué debe observar el runtime?
Registra lo suficiente para explicar una respuesta incompleta sin conservar datos innecesarios:
- identificadores del run y de la consulta;
- nombre de la tool y versión del contrato;
- snapshot o ámbito lógico usado por la página;
- cantidad de elementos devueltos y límite aplicado;
- si había
nextCursor, sin registrar el cursor en texto claro cuando contiene información sensible; - motivo de parada:
complete,page_limit,cursor_expired,invalid_cursoroexport_required.
La guía para rastrear tool calls de un agente con OpenTelemetry cubre la correlación entre run, tool, intento y resultado resumido. La telemetría ayuda a explicar por qué se detuvo el agente, pero no sustituye la guarda del dispatcher. El control de página debe bloquear la siguiente llamada antes de que llegue al backend.
Método y límites
Consulté la documentación actual del cliente y del servidor MCP para TypeScript el 20 de noviembre de 2026. Esa documentación permite separar la paginación de listas del protocolo de los datos estructurados que devuelve una tool. También revisé discusiones públicas de practicantes para encontrar dudas sobre completitud, filtros y exportación. Esas discusiones no se usaron como prueba técnica.
Escribí y ejecuté la fixture de este artículo con Node.js. Usa una lista fija y un snapshot artificial, así que no es un benchmark, no mide tokens y no demuestra el comportamiento de un modelo. La asistencia de IA ayudó a organizar la investigación, revisar el texto y producir las versiones localizadas. No ejecutó un agente en producción ni aportó una medición de calidad. Cuando necesito prolongar una sesión de depuración con menos contexto repetido, uso RemoteCode, una herramienta que construí.
Conclusión
La paginación de una tool es una promesa sobre la completitud. Declara la diferencia entre "estos son los registros que encontré en esta página" y "esta consulta terminó". Un cursor opaco, un orden estable, un límite por ejecución y un campo de completitud dan al runtime una decisión que no depende de adivinar la intención del modelo.
Cuando el agente necesita pocos candidatos, filtra en el servidor. Cuando necesita todo, considera la agregación o la exportación. Usa páginas navegables para una exploración controlada y deja que la prueba demuestre que una respuesta incompleta no puede pasar por completa.