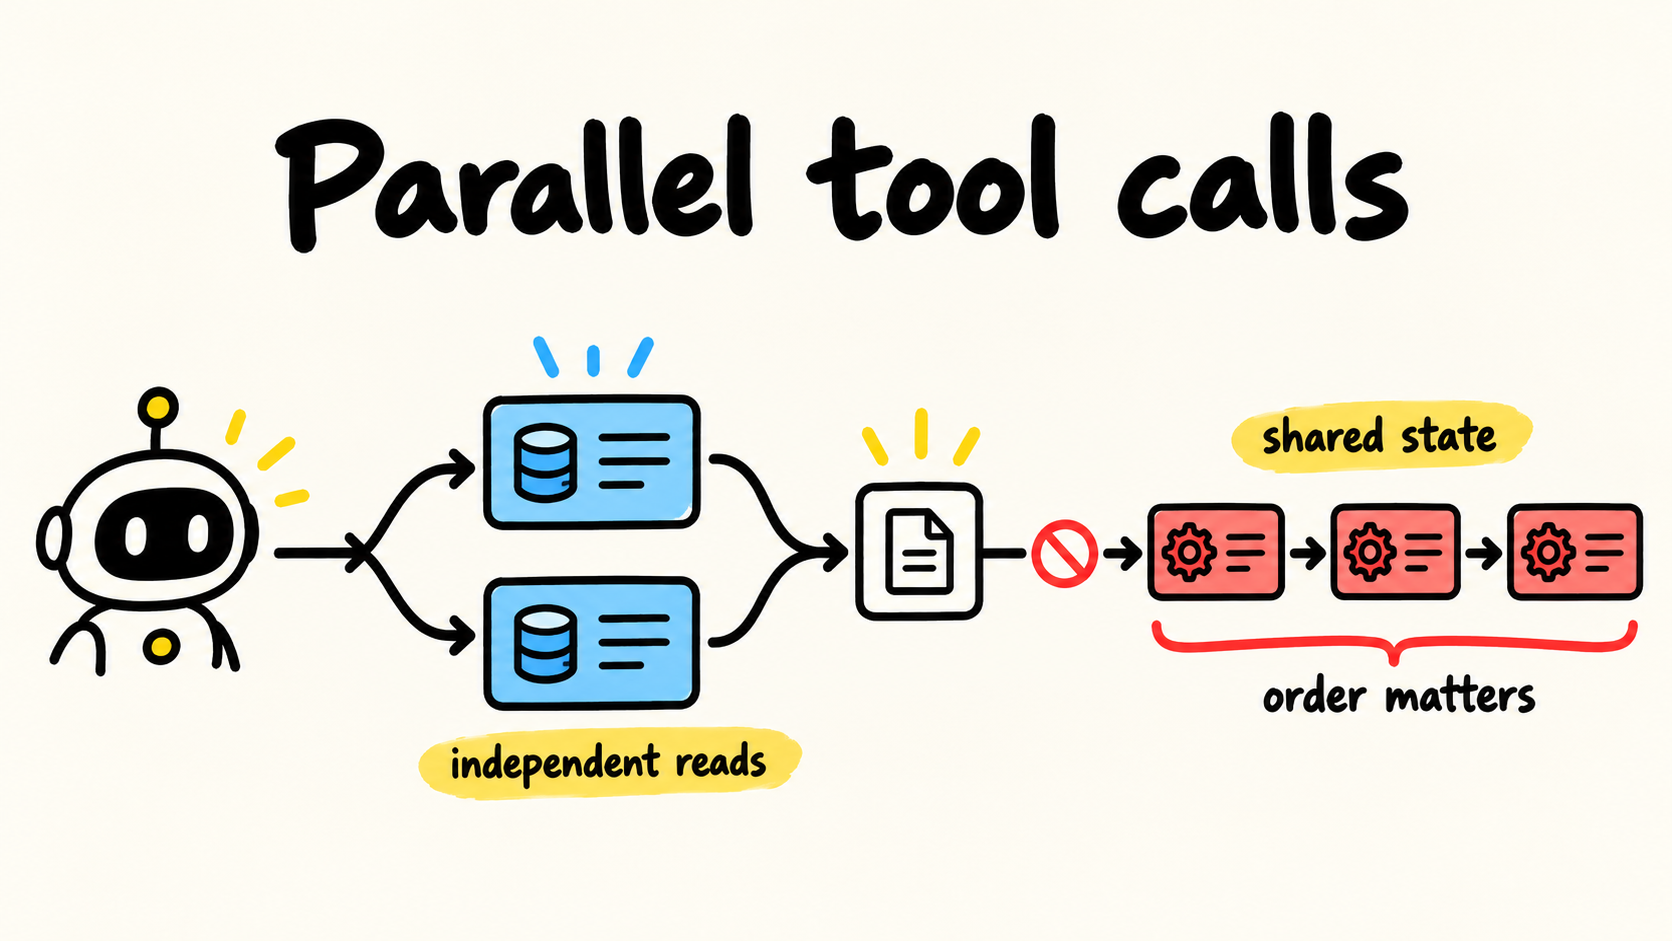
Una respuesta del modelo puede contener varias tool calls, pero eso no significa que tu servicio pueda ejecutarlas todas a la vez. Una API externa puede tener pocas conexiones disponibles, una consulta puede competir por el mismo recurso o un agente en segundo plano puede consumir los workers que necesita una solicitud interactiva.
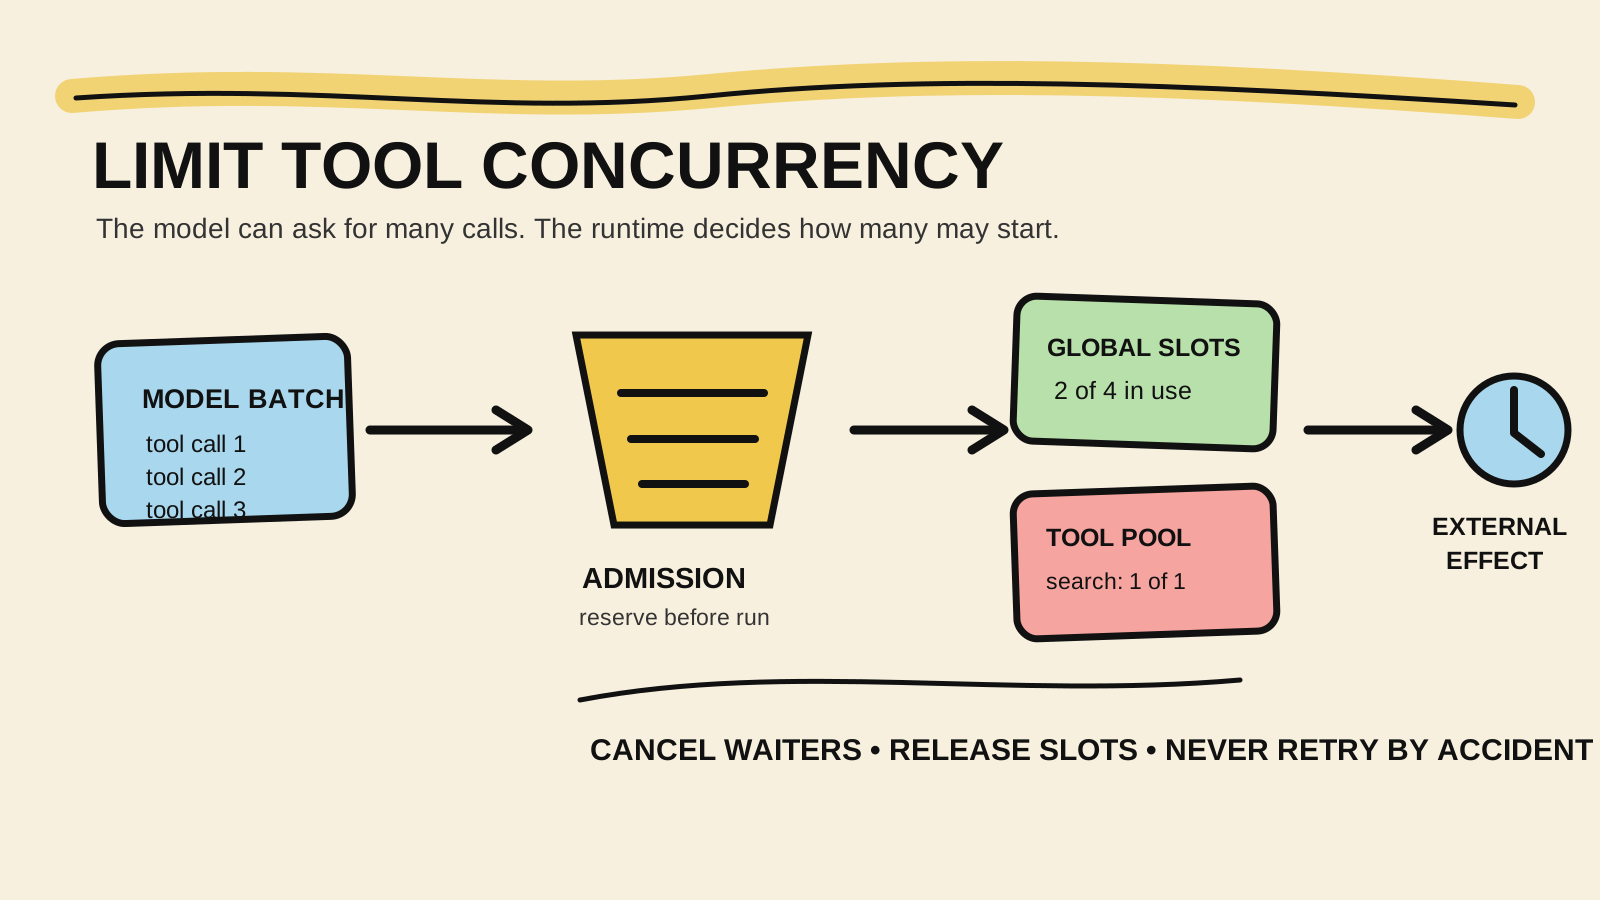
El límite debe estar en el runtime, antes de que empiece el handler de la tool. La guía para decidir cuándo permitir o bloquear parallel tool calls responde a la pregunta anterior: ¿las llamadas son independientes? Este artículo responde a la siguiente: después de considerar seguro el lote, ¿cuántas ejecuciones pueden consumir capacidad ahora?
El código usa un semáforo en TypeScript para limitar las ejecuciones globales y pools por tool. Es una implementación local e ilustrativa. No coordina réplicas distintas, no sustituye el rate limiting ni hace idempotente una escritura.
Respuesta corta
- Separa el permiso para que el modelo emita varias llamadas del límite de ejecución de tu proceso.
- Reserva un slot antes de llamar a la tool y libéralo en
finally, también cuando hay errores o cancelación.- Usa un límite global para la capacidad de los workers y pools más pequeños para dependencias sensibles.
- Haz que la espera observe un
AbortSignal; un agente cancelado no debe dejar un waiter atrapado en la cola.- Prueba el número máximo de ejecuciones activas y la cancelación. Contar solo los resultados finales no demuestra que el límite funcionó.
La concurrencia no es el paralelismo del modelo
parallel_tool_calls y opciones parecidas indican si el proveedor puede devolver varias llamadas en una respuesta. El OpenAI Agents SDK para JavaScript también documenta toolExecution.maxFunctionToolConcurrency como un límite de ejecución local por turno. Son capas distintas: una controla la emisión del modelo y la otra controla el dispatcher del SDK.
El OpenAI Agents SDK para Python deja clara la diferencia: parallel_tool_calls controla lo que puede emitir el modelo, mientras max_function_tool_concurrency limita cuántas function tools locales se ejecutan a la vez. Aun así, una configuración del SDK puede quedarse corta cuando varios runs comparten un cliente HTTP, una cola, una API o una base de datos fuera de esa instancia.
Piensa en cuatro límites diferentes:
| Límite | Pregunta que responde | Ejemplo |
|---|---|---|
| Emisión | ¿El modelo puede pedir varias tools en un turno? | parallel_tool_calls |
| Concurrencia | ¿Cuántas ejecuciones están activas ahora? | semáforo con 4 slots |
| Frecuencia | ¿Cuántas llamadas pueden empezar durante un intervalo? | 10 por segundo |
| Presupuesto | ¿Cuántas llamadas o tokens puede consumir el run en total? | 20 llamadas por run |
Desactivar la emisión paralela puede ser válido para tools con estado compartido, pero no limita dos runs separados. Un presupuesto total tampoco evita que cinco llamadas empiecen en el mismo milisegundo. Usa el control que corresponda al recurso que puede saturarse.
Reserva capacidad antes del handler
El semáforo mantiene tres invariantes: el contador nunca supera el límite, cada adquisición tiene una liberación correspondiente y un waiter cancelado sale de la cola sin consumir un slot.
type Waiter = {
  resolve: (release: () => void) => void;
  reject: (error: unknown) => void;
  onAbort?: () => void;
};

export class Semaphore {
  private active = 0;
  private readonly waiters: Waiter[] = [];

  constructor(private readonly limit: number) {
    if (!Number.isInteger(limit) || limit < 1) {
      throw new Error("limit must be a positive integer");
    }
  }

  acquire(signal?: AbortSignal): Promise<() => void> {
    if (signal?.aborted) {
      return Promise.reject(signal.reason ?? new Error("aborted"));
    }

    if (this.active < this.limit) {
      this.active += 1;
      return Promise.resolve(() => this.release());
    }

    return new Promise((resolve, reject) => {
      const waiter: Waiter = {
        resolve: (release) => {
          signal?.removeEventListener("abort", waiter.onAbort!);
          this.active += 1;
          resolve(release);
        },
        reject,
      };

      waiter.onAbort = () => {
        const index = this.waiters.indexOf(waiter);
        if (index === -1) return;
        this.waiters.splice(index, 1);
        reject(signal?.reason ?? new Error("aborted"));
      };

      signal?.addEventListener("abort", waiter.onAbort, { once: true });
      this.waiters.push(waiter);
    });
  }

  private release(): void {
    const next = this.waiters.shift();
    if (next) {
      next.resolve(() => this.release());
      return;
    }
    this.active -= 1;
  }
}
El contador aumenta cuando se entrega la adquisición, no cuando la Promise entra en la cola. Cuando se cancela un waiter, la cola pierde la referencia y el contador no cambia. El finally del llamador debe ser el único lugar que libera el slot. Liberarlo también desde un callback de error crea contadores negativos o capacidad fantasma.
Combina un límite global con pools por tool
Un límite global protege la capacidad del proceso. Un pool por tool evita que una dependencia consuma todos los slots. La documentación de trpc-agent-go describe grupos globales y por tool y también advierte que los límites por invocación no protegen la capacidad compartida entre runs o réplicas.
type ToolCall<T> = {
  name: string;
  run: (signal: AbortSignal) => Promise<T>;
};

const globalPool = new Semaphore(4);
const toolPools = new Map([
  ["search", new Semaphore(1)],
  ["read_customer", new Semaphore(2)],
]);

export async function executeTool<T>(
  call: ToolCall<T>,
  signal: AbortSignal,
): Promise<T> {
  const releaseGlobal = await globalPool.acquire(signal);
  const specificPool = toolPools.get(call.name);
  let releaseSpecific: (() => void) | undefined;

  try {
    releaseSpecific = specificPool
      ? await specificPool.acquire(signal)
      : undefined;
    return await call.run(signal);
  } finally {
    releaseSpecific?.();
    releaseGlobal();
  }
}
Este orden evita una clase de deadlock: cada ejecución toma primero el límite global y después el pool específico. El coste es que un slot global puede quedar reservado mientras una llamada espera por el pool de su tool. Si eso importa, usa un scheduler que admita el par de recursos de forma atómica o define un límite por grupo, en vez de apilar semáforos sin medir la cola.
No dejes que el nombre de la tool sea la única configuración. El registro también debe indicar si una llamada lee o escribe, qué recurso comparte y si necesita orden. La clasificación de independencia sigue siendo la decisión del artículo sobre parallel tool calls; el pool controla la capacidad después de esa decisión.
Elige entre esperar y fallar rápido
Cuando no hay un slot disponible, el runtime puede poner la llamada en cola o devolver un error estructurado al agente. La decisión depende del recurso:
| Situación | Política | Motivo |
|---|---|---|
| Consulta corta e idempotente | Esperar con deadline | La cola absorbe un pico pequeño sin repetir la decisión del modelo. |
| Mutación con aprobación vencida | Fallar rápido | Esperar podría ejecutar una aprobación que ya no coincide con el estado actual. |
| Tool de baja prioridad | Cola acotada | Un run en segundo plano no debe retener memoria indefinidamente. |
| Servicio externo con cuota por ventana | Rate limiter separado | Un semáforo controla la ejecución simultánea, no la frecuencia. |
| Solicitud cancelada | Quitar el waiter | El cliente no quiere que la ejecución empiece más tarde. |
El Microsoft Agent Framework explica que los límites de llamadas y duración son best effort y pueden comprobarse después de un lote pedido por el modelo. Eso es distinto de rechazar una ejecución antes del handler. Si la protección debe ser exacta, aplica la admisión en tu runtime o en el componente que posee la capacidad.
No conviertas un rechazo en un retry automático. Un error concurrency_limit puede volver al modelo como resultado de una tool, terminar el turno o entrar en una cola duradera. El runtime debe registrar runId, nombre de la tool, política, tiempo de espera y motivo del rechazo sin copiar argumentos sensibles. La decisión de intentarlo otra vez pertenece a la política del run y a la idempotencia del efecto.
Prueba la capacidad, no solo la respuesta
Una prueba útil controla la duración de las tools para observar cuántas ejecuciones están activas. El ejemplo puede ejecutarse con tsx o adaptarse a JavaScript. No llama a un modelo ni a una API externa.
import assert from "node:assert/strict";

const gate = new Semaphore(2);
let active = 0;
let maximum = 0;

async function fakeTool(signal: AbortSignal): Promise<void> {
  const release = await gate.acquire(signal);
  active += 1;
  maximum = Math.max(maximum, active);

  try {
    await new Promise((resolve) => setTimeout(resolve, 20));
  } finally {
    active -= 1;
    release();
  }
}

await Promise.all(
  Array.from({ length: 6 }, () => fakeTool(new AbortController().signal)),
);

assert.equal(maximum, 2);
Añade un segundo caso con AbortController: ocupa el único slot, pone otra llamada en cola, aborta el signal y confirma que la segunda tool nunca entró en el handler. Después haz que una llamada falle y verifica que el slot vuelve a estar disponible. Por último, ejecuta dos runs a la vez. Un semáforo creado dentro del run prueba solo ese run; un pool creado fuera prueba la capacidad compartida del proceso.
La prueba aún no demuestra una política distribuida. Con dos réplicas, cada proceso puede aceptar cuatro llamadas mientras el servicio externo ve ocho. Para esa frontera, mueve la admisión a un gateway, una cola o el propio recurso compartido. El artículo sobre probar un worker de cola sin efectos duplicados ayuda a probar el comportamiento cuando la ejecución sale del proceso local.
Fallos que el límite no corrige
Confundir concurrencia con rate limiting. Cuatro slots pueden iniciar cuatro solicitudes en un instante y aun así incumplir una cuota de dos por segundo. Usa un token bucket o una política equivalente cuando el límite sea temporal.
Aplicar el límite solo al modelo. El proveedor puede emitir una llamada, un retry puede emitir otra o un worker puede iniciar una más tarde. La frontera debe envolver al ejecutor que llama a la dependencia.
Usar un contador sin reserva. El patrón "leer activos, comparar, iniciar" permite que varias Promises pasen el mismo control antes de que alguna incremente el contador. La adquisición del semáforo debe ser una operación indivisible dentro del event loop o de un coordinador compartido.
Retener slots en una tool que ignora la cancelación. El AbortSignal debe llegar a la operación que espera I/O. El timeout del llamador puede liberar el slot local mientras el upstream sigue trabajando, así que clasifica ese efecto como desconocido cuando incluya una escritura.
Crear un pool por run y llamarlo protección global. Eso limita una ejecución, no todas. Documenta el alcance de cada pool y prueba el escenario que realmente compite por el recurso.
Checklist antes de habilitar tools concurrentes
- ¿Se clasificó la independencia antes de ejecutar el scheduler?
- ¿Existe un límite global para la capacidad de los workers?
- ¿Alguna dependencia necesita un pool menor o serialización por recurso?
- ¿La adquisición ocurre antes del handler y la liberación está en
finally? - ¿Cancelar un waiter lo quita de la cola sin consumir capacidad?
- ¿La espera tiene deadline y una política de rechazo?
- ¿Rate limiting, presupuesto total e idempotencia se tratan por separado?
- ¿La prueba mide ejecuciones activas máximas, fallo, cancelación y dos runs concurrentes?
- ¿El trace identifica admisión, rechazo, espera y efecto sin filtrar argumentos?
Conclusión
El modelo puede pedir varias tools, pero el runtime debe decidir cuántas empiezan. Primero clasifica dependencias y estado compartido. Después coloca la admisión en el ejecutor, combina un límite global con pools específicos, propaga la cancelación y prueba el número máximo de ejecuciones activas.
Este límite controla capacidad. No sustituye el rate limiting, la aprobación, la idempotencia, los timeouts ni la coordinación entre réplicas. Trata cada protección como una pregunta diferente y deja que la prueba muestre qué frontera está realmente cubierta.
Para conservar el contexto entre sesiones largas de desarrollo, uso RemoteCode como herramienta del autor. No coordina slots de producción, no sustituye al scheduler ni aporta pruebas de throughput.
Cómo se produjo este artículo
Samuel Fajreldines es el autor responsable de este artículo. La investigación comparó referencias actuales del OpenAI Agents SDK, Microsoft Agent Framework y trpc-agent-go con discusiones públicas recientes y el cluster existente del sitio. El semáforo y la prueba son una implementación local de referencia. El código se verificó en Node.js v25.5.0 sin llamar a un proveedor de modelos, una API externa o un entorno con varias réplicas. La asistencia de IA apoyó el descubrimiento, la organización, la redacción, la localización y la revisión de consistencia; no aportó experiencia de producción ni midió latencia, coste o throughput.
Fuentes consultadas
- OpenAI Agents SDK for JavaScript, “Running agents”, consultado el 13 de noviembre de 2026.
- OpenAI Agents SDK for Python, “Running agents”, consultado el 13 de noviembre de 2026.
- Microsoft Agent Framework, “Function tools”, consultado el 13 de noviembre de 2026.
- trpc-agent-go, “Tool documentation”, consultado el 13 de noviembre de 2026.