Un agente recibe la petición "actualiza el registro del cliente" y llama a una tool de escritura. El revisor solo ve un resumen, aprueba la operación y descubre después que el objetivo cambió mientras la ejecución esperaba. El problema no es que falte un botón. Falta una frontera que muestre el efecto propuesto antes de permitir la mutación.
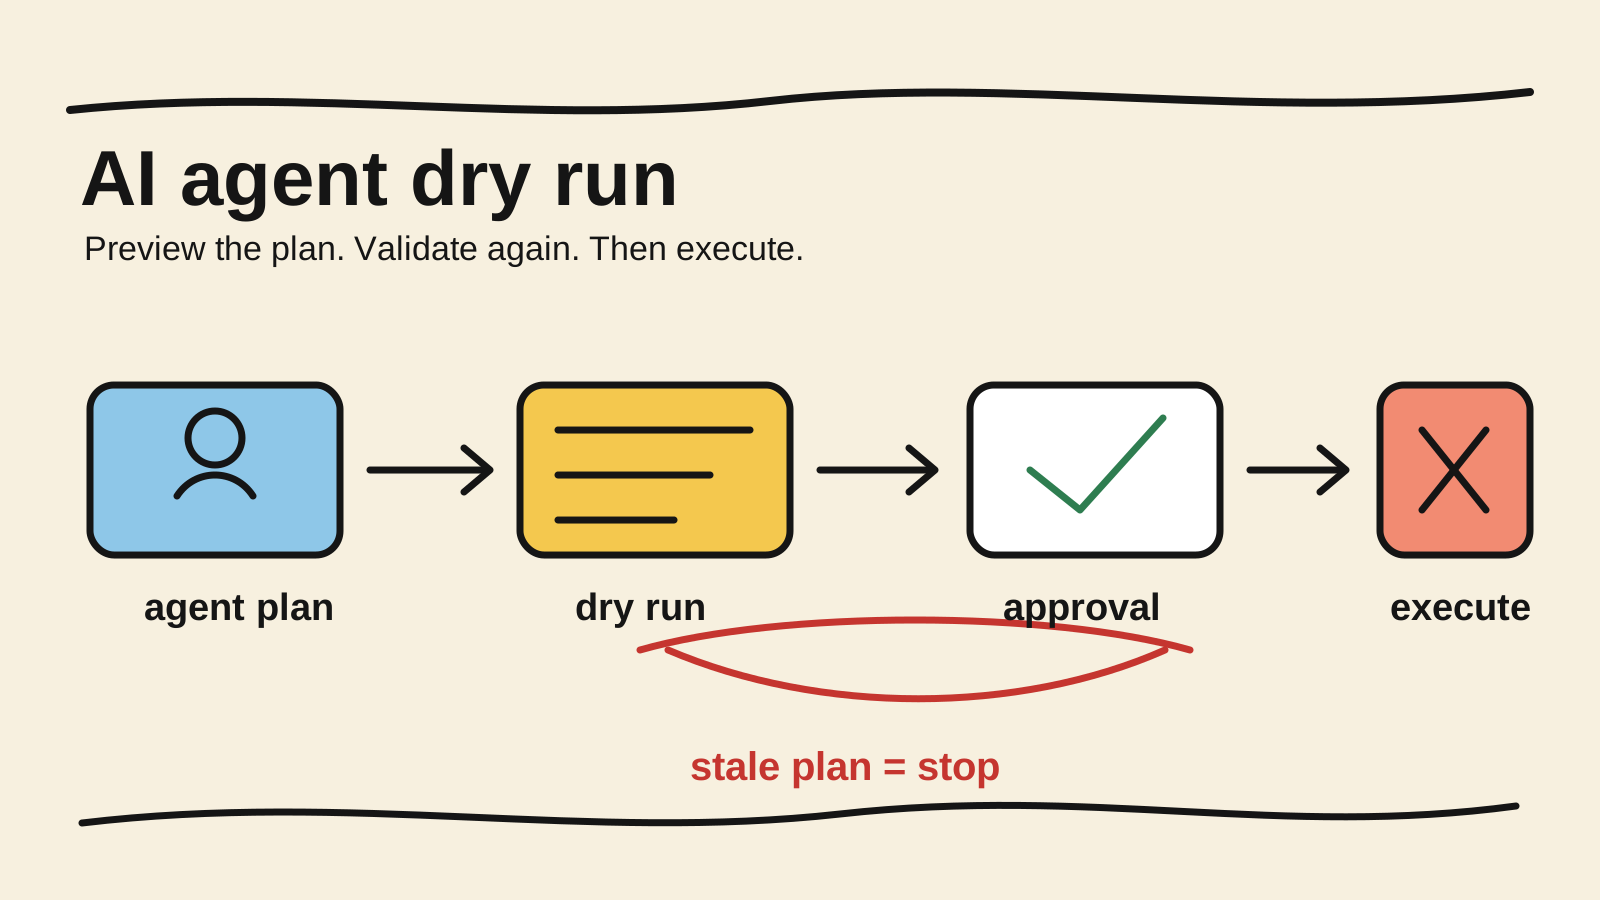
Para crear un dry run de un agente de IA, separa cuatro pasos: producir un plan tipado, calcular una previsualización sin efectos, aprobar exactamente ese plan y volver a validar el estado justo antes de ejecutar. El modelo puede proponer la acción, pero solo el ejecutor autorizado toca el sistema externo.
Este artículo es un spoke de la guía sobre cuándo debe un agente de IA pedir aprobación humana. El owner explica cuándo detener una ejecución para tomar una decisión. Este post responde cómo construir la previsualización y evitar que una aprobación se ligue a argumentos diferentes. La validación de tool calls en TypeScript cubre el schema de la llamada; este artículo añade el contrato del efecto y la comprobación del recurso.
Respuesta corta
- Crea un plan con objetivo, argumentos, precondiciones y efecto esperado.
- Calcula la previsualización en una función o tool que no tenga credenciales ni permiso de escritura.
- Liga la aprobación al fingerprint del plan, no a un "sí" genérico.
- Vuelve a leer la versión del recurso antes de ejecutar y detente si cambió.
- Mantén la ejecución en un adapter separado, con autorización propia y una prueba de cero efectos para el camino de previsualización.
¿Qué debe demostrar un dry run?
Un dry run útil responde dos preguntas distintas. Primero, ¿el runtime entendió los argumentos, el objetivo y la política de la acción? Segundo, ¿el sistema puede mostrar qué cambiaría sin modificar el objetivo? Si solo imprime la intención del modelo, no es una previsualización del efecto.
La documentación de Kubernetes describe un dry run con una propiedad útil como referencia de diseño: la solicitud pasa por la validación y las etapas aplicables, pero no se persiste y no produce efectos secundarios (Kubernetes, "API Concepts"). Un agente no obtiene esa garantía automáticamente. El ejecutor de la aplicación tiene que construirla.
Usa estos criterios antes de llamar dry run a una respuesta:
| Criterio | Pregunta de verificación |
|---|---|
| Sin mutación | ¿Puede funcionar el camino sin credencial ni permiso de escritura? |
| Plan explícito | ¿La respuesta identifica la tool, el objetivo, los argumentos y el efecto esperado? |
| Precondiciones | ¿La previsualización conserva la versión o el estado que debe seguir siendo válido? |
| Política | ¿El runtime valida autorización y riesgo antes de crear la aprobación? |
| Ejecución separada | ¿Existe otro camino que sea el único capaz de cambiar el sistema? |
La previsualización también puede fallar. Un registro inexistente, un schema inválido o una política que deniega la acción deben producir un resultado explícito. No conviertas un fallo de previsualización en permiso para intentar la escritura de todos modos.
¿Por qué dryRun: true en la misma tool es una frontera débil?
Un parámetro dryRun puede ser útil dentro de un adapter confiable, pero no debería ser la única barrera. La misma función recibe la intención, decide si está simulando y conserva el acceso potencial al efecto. Una rama olvidada, una prueba que usa la flag equivocada o un nuevo llamador que omite el campo puede cruzar la frontera.
Prefiere dos capacidades con contratos diferentes:
preview_update_contact(input) -> Plan
execute_update_contact(plan, approval) -> Result
La primera puede leer el estado actual y calcular una propuesta. La segunda recibe un plan validado, comprueba la autorización y vuelve a validar el estado antes de escribir. Si el modelo solo puede ver preview_update_contact, no puede elegir la tool de escritura para saltarse la revisión.
El OpenAI Agents SDK documenta las tools como funciones ejecutadas por la aplicación y permite configurar needsApproval para pausar una llamada antes de ejecutarla. Esa función resuelve la interrupción del run. No crea por sí sola una previsualización del efecto ni impide que el payload se reconstruya de otra manera después de la aprobación. Separar las capacidades sigue siendo responsabilidad del runtime.
¿Cómo modelar un plan que se pueda aprobar?
El plan debe ser un objeto de datos, no el texto que el agente utilizó para explicar lo que piensa hacer. Incluye solo campos que el ejecutor pueda volver a validar:
type ContactUpdatePlan = {
  planId: string;
  action: "update_contact";
  targetId: string;
  patch: { email?: string; name?: string };
  before: { email: string; name: string };
  after: { email: string; name: string };
  expectedVersion: number;
  requiresApproval: true;
};
before y expectedVersion importan por razones distintas. La versión detecta un cambio concurrente aunque el valor final parezca parecido. El estado anterior ayuda a mostrar al revisor qué pretende reemplazar la operación. planId debe ser un fingerprint estable del plan normalizado, con el objetivo, los argumentos, la versión y la política aplicada.
No incluyas un campo como approved: true producido por el propio modelo. La aprobación es una decisión fuera del plan. El ejecutor debe recibir un token o registro que la aplicación haya emitido después de comprobar planId, la persona responsable, la expiración y la política.
¿Cómo implementar la previsualización y la ejecución sin compartir el permiso?
La fixture siguiente usa un Map local para representar el sistema externo. Se ejecuta con Node.js y no mide un proveedor real. El objetivo es hacer imposible que previewContactUpdate cambie el mapa y hacer que executeContactUpdate rechace un plan obsoleto.
Guárdala como agent-dry-run.mjs:
import assert from "node:assert/strict";

const contacts = new Map([
  ["contact-1", { version: 3, name: "Ana", email: "ana@old.example" }],
]);

function stableId(value) {
  return JSON.stringify(value);
}

function previewContactUpdate({ targetId, patch }) {
  const current = contacts.get(targetId);
  if (!current) throw new Error("contact not found");

  const allowed = new Set(["name", "email"]);
  for (const field of Object.keys(patch)) {
    if (!allowed.has(field)) throw new Error(`field not allowed: ${field}`);
  }

  const before = { name: current.name, email: current.email };
  const after = { ...before, ...patch };
  const identity = { targetId, patch, before, version: current.version };

  return {
    planId: `plan:${stableId(identity)}`,
    action: "update_contact",
    targetId,
    patch,
    before,
    after,
    expectedVersion: current.version,
    requiresApproval: true,
  };
}

function executeContactUpdate(plan, approval) {
  if (!approval || approval.planId !== plan.planId) {
    throw new Error("approval does not match the plan");
  }

  const current = contacts.get(plan.targetId);
  if (!current || current.version !== plan.expectedVersion) {
    throw new Error("stale plan: preview again");
  }

  contacts.set(plan.targetId, {
    version: current.version + 1,
    ...plan.after,
  });

  return { status: "applied", planId: plan.planId };
}

const plan = previewContactUpdate({
  targetId: "contact-1",
  patch: { email: "ana@new.example" },
});

assert.equal(contacts.get("contact-1").email, "ana@old.example");
assert.equal(plan.after.email, "ana@new.example");

assert.throws(
  () => executeContactUpdate(plan, { planId: "plan:wrong" }),
  /approval does not match/,
);
assert.equal(contacts.get("contact-1").email, "ana@old.example");

const result = executeContactUpdate(plan, { planId: plan.planId });
assert.equal(result.status, "applied");
assert.equal(contacts.get("contact-1").version, 4);
assert.equal(contacts.get("contact-1").email, "ana@new.example");

assert.throws(
  () => executeContactUpdate(plan, { planId: plan.planId }),
  /stale plan/,
);

console.log("preview did not mutate; matching plan applied once");
Ejecuta la fixture limpia con:
node agent-dry-run.mjsEl assert antes de ejecutar demuestra que la previsualización no cambió el email. El token incorrecto se rechaza sin efecto. Después de aplicar, no se puede reutilizar la misma aprobación porque cambió la versión del contacto. En un servicio real, sustituye el Map por una lectura transaccional o por una API que ofrezca If-Match, una versión esperada u otro mecanismo de precondición.
Esta prueba demuestra el contrato local. No demuestra que un adapter de producción no haga llamadas externas durante la previsualización, que una API concurrente respete la versión o que el token de aprobación esté protegido. Esos puntos necesitan pruebas de integración y controles en el sistema real.
¿Cómo ligar la aprobación al plan y no a otra acción?
El flujo debe persistir el plan completo o un fingerprint que permita recuperarlo. Después, la aprobación debe apuntar a la misma identidad:
model -> normalized plan -> preview -> decision -> revalidation -> executionSi el agente recalcula after después de la aprobación, la persona puede aprobar un cambio mientras el ejecutor aplica otro. El runtime debe comparar planId, objetivo, argumentos relevantes, versión del recurso y política. Una diferencia exige una nueva previsualización o un rechazo seguro.
La guía de human-in-the-loop del OpenAI Agents SDK describe un run que se pausa, devuelve interruptions y se reanuda mediante el mismo RunState después de una decisión (OpenAI Agents SDK, "Human-in-the-loop"). Usa ese tipo de estado para transportar la acción pendiente, pero mantén la autorización y el fingerprint en tu propio contrato. Un snapshot serializado no es una prueba de identidad por sí solo.
Lo mismo se aplica a MCP. El SDK de TypeScript expone readOnlyHint, destructiveHint, idempotentHint y openWorldHint como anotaciones de tools (MCP TypeScript SDK, "server/mcp"). Estas anotaciones ayudan al cliente a entender el riesgo, pero son pistas. No sustituyen una autorización determinista, un dry run real ni un sandbox cuando el servidor no es confiable.
¿Cuándo no es un dry run la respuesta correcta?
No todas las acciones necesitan una previsualización detallada. Las lecturas, los cálculos puros y los cambios locales desechables pueden ejecutarse en un entorno de prueba más sencillo. Una previsualización también puede engañar cuando el efecto depende de un sistema que cambia rápido, de un envío irreversible o de un tercero que no ofrece una API de simulación.
En esos casos, elige la barrera adecuada:
- usa un sandbox o una cuenta de prueba cuando la integración permita una ejecución real sin datos de producción;
- usa aprobación explícita cuando la consecuencia sea externa y no exista una previsualización fiel;
- rechaza cuando el ejecutor no pueda identificar el objetivo, la autoridad o la precondición;
- usa idempotencia y reconciliación cuando la llamada pueda fallar después de comenzar el efecto.
No llames preview a una respuesta textual si no se derivó del estado que la ejecución comprobará. Un resumen puede explicar la intención. La previsualización debe representar el cambio y llevar las condiciones que hacen válida la aplicación.
Cómo se produjo este artículo
Samuel Fajreldines es el autor responsable de este texto. La investigación combinó documentación actual del OpenAI Agents SDK, el MCP TypeScript SDK y Kubernetes, inspección de resultados de búsqueda, lectura de conversaciones públicas recientes y comparación con los artículos existentes sobre aprobación y validación de tools. La fixture se ejecutó localmente con Node.js usando solo un Map en memoria. No modificó ningún contacto, email, permiso ni API externa.
Uso RemoteCode como herramienta propia para conservar contexto entre sesiones de Codex y Claude Code. La asistencia de IA ayudó a descubrir fuentes, comparar páginas, organizar el borrador, crear la ilustración SVG y revisar los tres idiomas. No ejecutó un agente real, no probó un proveedor en producción y no sustituye la verificación de los contratos de tu sistema.
Fuentes consultadas
- OpenAI Agents SDK, "Tools", consultado el 6 de noviembre de 2026.
- OpenAI Agents SDK, "Human-in-the-loop", consultado el 6 de noviembre de 2026.
- MCP TypeScript SDK, "server/mcp", consultado el 6 de noviembre de 2026.
- Kubernetes, "API Concepts: Dry-run", consultado el 6 de noviembre de 2026.