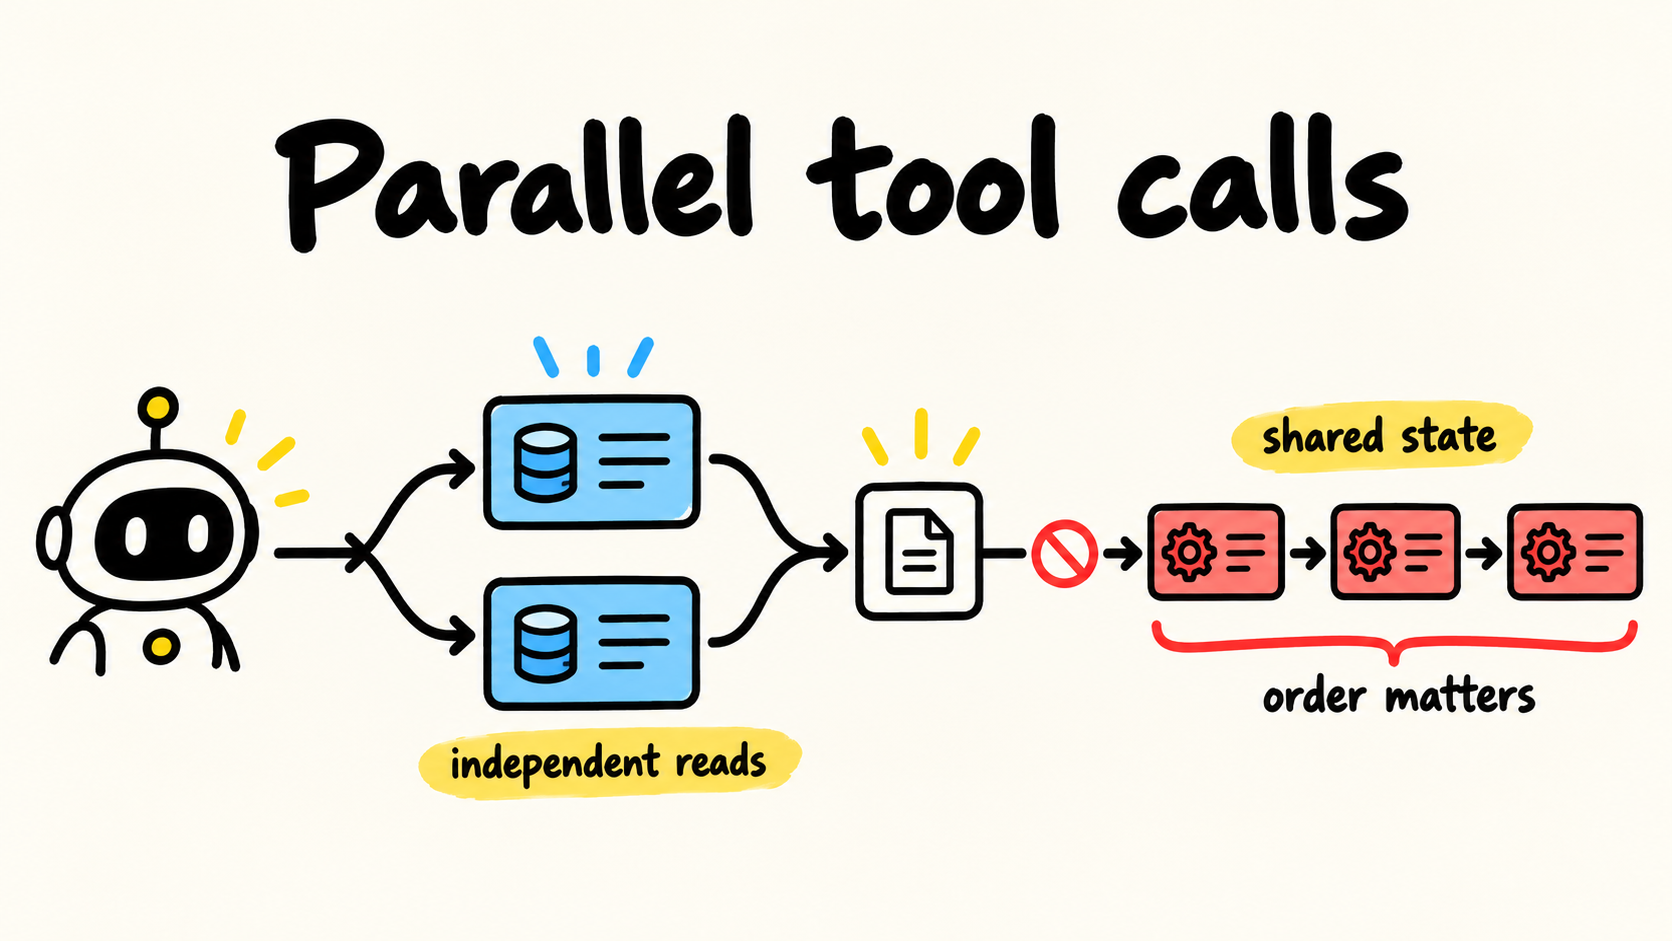
Un agente no debería reanudarse cargando la conversación y pidiendo al modelo que continúe. La conversación registra lo que se dijo. No demuestra que una tool terminó, que un sistema externo aplicó el efecto ni que la respuesta sobrevivió al proceso que hizo la llamada.
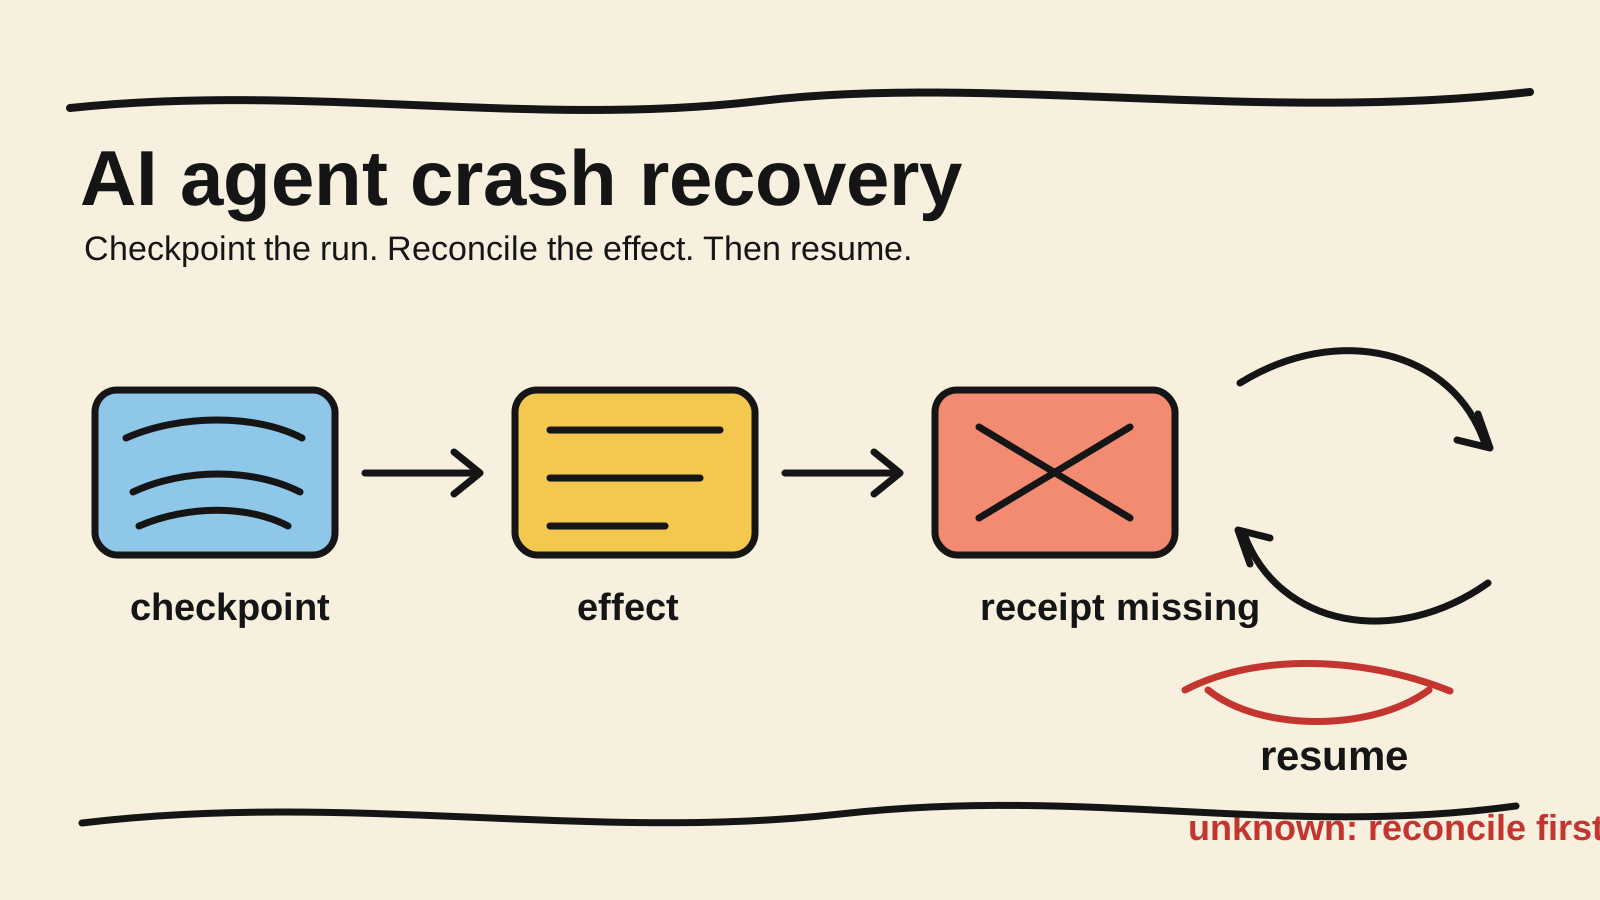
Después de un crash, carga el último checkpoint confirmado, recupera la intención y el resultado de cada paso, y trata la primera llamada sin recibo como una decisión de recuperación. Si el proveedor acepta una clave de idempotencia, consulta o repite la operación con la misma clave. Si no existe una forma fiable de saber qué ocurrió, marca el resultado como desconocido y detente antes de producir otro cambio.
Este artículo es un spoke de ejecución durable para agentes de IA. El owner explica cuándo encajan una cola, un checkpoint o un workflow. Aquí el foco está en el fallo entre un efecto externo y el registro local, con una fixture de Node.js que puedes interrumpir y reiniciar.
Conclusiones clave
- Guarda la decisión del modelo antes de ejecutar tools.
- Guarda el resultado de cada tool antes de iniciar el siguiente paso.
- Genera una clave estable por efecto y reutilízala al repetir.
- Después de un crash, comprueba el sistema externo antes de decidir si debes ejecutar de nuevo la operación.
- Si el resultado sigue siendo desconocido y repetir puede causar daño, pausa para una reconciliación humana u operativa.
Por qué el historial de la conversación no recupera la ejecución
Imagina que un agente recibe una solicitud, pide ejecutar create_ticket y el proceso muere justo después de que el sistema de tickets acepta la operación. El historial puede contener la llamada a la tool, pero puede no contener el ID del ticket ni una confirmación que sobreviva al proceso.
Si el worker reiniciado envía toda la conversación al modelo, el modelo puede elegir otra acción. Aunque elija la misma tool, una nueva petición puede crear un segundo ticket. El problema no es solo perder contexto. Es tratar una intención registrada como un efecto confirmado.
La guía de AWS sobre ejecución durable para agentes describe el mecanismo como step, checkpoint y replay: el resultado de cada paso vive fuera del proceso y la recuperación continúa desde esos registros. La documentación de tareas de Cloudflare Agents añade un límite importante: un paso interrumpido puede ejecutarse otra vez, así que un efecto externo necesita una clave estable o una lectura duradera del progreso.
Por eso un trace no es un recibo. Un trace ayuda a investigar el camino. Un recibo, el ID devuelto por el proveedor o una consulta al sistema que cambió ayuda a decidir qué puede ocurrir después.
Qué estado debe sobrevivir al proceso
El registro de recuperación no necesita guardar toda la conversación en un solo documento. Necesita suficiente información para que el runtime elija el siguiente paso sin depender de la memoria del worker:
| Registro | Propósito |
|---|---|
runId y versión del flujo |
Encuentra la ejecución y evita continuar con una definición incompatible |
| turno y llamadas del modelo | Reproduce la intención elegida sin pedir al modelo que elija otra vez |
| ID de llamada y argumentos | Identifica la operación lógica que puede repetirse |
| clave de idempotencia | Conecta los intentos de la misma operación en el sistema externo |
| resultado o recibo | Permite saltar un paso completado |
estado unknown |
Evita tratar un fallo de comunicación como prueba de que no hubo efecto |
| lease o fencing token | Impide que dos workers avancen la misma ejecución a la vez |
Escribe el registro en un almacenamiento que sobreviva a la muerte del proceso. Un archivo atómico basta para una fixture local. En producción, usa una base de datos, un volumen durable o el almacenamiento de un motor de workflows, con control de concurrencia y una política de retención.
La documentación de checkpoints de Microsoft Agent Framework describe snapshots que incluyen el estado de los executors, mensajes pendientes, solicitudes y respuestas. La misma página exige que el workflow reconstruido conserve su topología y las identidades de los executors. La idea se aplica fuera de ese framework: el checkpoint debe seguir siendo compatible con el código que lo interpreta después de un despliegue.
Qué hacer en cada ventana de crash
El punto del fallo cambia la recuperación. No uses un único camino de retry para todas las situaciones.
| Punto del fallo | Lo que sabes | Siguiente acción |
|---|---|---|
| Antes de enviar la tool | El efecto no fue solicitado | Envíala con la clave de operación persistida |
| Después de enviar, sin respuesta | El efecto puede haber ocurrido | Busca la clave o lee el estado del destino |
| Después del efecto, antes del checkpoint | El efecto existe, pero el registro local no lo sabe | Búscalo o repite con la misma clave, nunca con una nueva |
| Después de guardar el recibo | El efecto y el paso están confirmados | Reutiliza el resultado y avanza |
| Sin consulta fiable y con riesgo de duplicación | El estado sigue siendo ambiguo | Marca unknown, pausa y reconcilia |
Un retry es otro intento de una operación. Reanudar es continuar una ejecución desde el último estado confirmado. Un retry puede formar parte de la reanudación, pero solo después de que el runtime clasifique el efecto.
Cómo implementar un journal pequeño en Node.js
El ejemplo usa dos archivos para hacer visibles las fronteras. agent-run.json es el journal del runtime. effects.json representa al proveedor externo, que reconoce la misma clave de operación. El modelo se sustituye por un plan fijo para que la prueba no dependa de red, tokens ni una decisión no determinista.
Guárdalo como agent-recovery.mjs:
import { existsSync, readFileSync, renameSync, writeFileSync } from "node:fs";

const RUN_FILE = "agent-run.json";
const EFFECTS_FILE = "effects.json";
const runId = "ticket-77";

const plan = [
  [{ id: "c1", tool: "create_ticket", args: { title: "Login falla" } }],
  [{ id: "c2", tool: "send_email", args: { to: "dana@example.com" } }],
  [],
];

function load(file, fallback) {
  return existsSync(file) ? JSON.parse(readFileSync(file, "utf8")) : fallback;
}

function saveAtomically(file, value) {
  const temporary = `${file}.tmp`;
  writeFileSync(temporary, JSON.stringify(value, null, 2));
  renameSync(temporary, file);
}

function model(turns) {
  return plan[turns] ?? [];
}

function providerLookup(key) {
  const effects = load(EFFECTS_FILE, {});
  return effects[key] ?? null;
}

function providerExecute(tool, args, key) {
  const effects = load(EFFECTS_FILE, {});
  if (effects[key]) return effects[key];

  const result = {
    providerId: `${tool}-1`,
    tool,
    args,
    confirmedAt: "fixture",
  };

  // Un proveedor real debe guardar esta clave junto con el efecto.
  effects[key] = result;
  saveAtomically(EFFECTS_FILE, effects);
  return result;
}

async function run() {
  const state = load(RUN_FILE, { runId, turns: [] });

  for (let turnIndex = 0; ; turnIndex += 1) {
    if (!state.turns[turnIndex]) {
      state.turns[turnIndex] = {
        calls: model(turnIndex),
        results: {},
      };
      // Persiste la decisión del modelo antes de cualquier efecto.
      saveAtomically(RUN_FILE, state);
    }

    const turn = state.turns[turnIndex];
    for (const call of turn.calls) {
      if (turn.results[call.id]) {
        console.log(`skip ${call.tool}: resultado ya guardado`);
        continue;
      }

      const key = `${runId}:${turnIndex}:${call.id}`;
      const known = providerLookup(key);
      const result = known ?? providerExecute(call.tool, call.args, key);

      if (process.env.CRASH_AFTER_EFFECT === "1" && !known) {
        console.log(`crash después del efecto: ${call.tool}`);
        process.kill(process.pid, "SIGKILL");
      }

      turn.results[call.id] = result;
      saveAtomically(RUN_FILE, state);
      console.log(`${call.tool}: ${known ? "recibo encontrado" : "efecto aplicado"}`);
    }

    if (turn.calls.length === 0) {
      console.log("ejecución completada");
      return;
    }
  }
}

run().catch((error) => {
  console.error(error);
  process.exitCode = 1;
});
El ejemplo tiene dos propiedades importantes. Primero, guarda la salida del modelo antes de la primera tool. Un reinicio no llama al modelo para redescubrir el plan. Segundo, providerLookup comprueba el sistema externo antes de providerExecute. Cuando el proceso muere después de providerExecute y antes de guardar agent-run.json, la siguiente ejecución encuentra el recibo en effects.json y lo registra en el journal sin crear un segundo efecto.
effects.json es una simulación. Representa una garantía que tu proveedor debe ofrecer, como idempotencia por clave, una consulta de estado o una tabla de operaciones. Un archivo local controlado por el mismo proceso no demuestra atomicidad en un sistema distribuido.
Cómo provocar el crash y verificar la reanudación
Ejecuta el primer proceso con el fallo inyectado:
rm -f agent-run.json effects.json
CRASH_AFTER_EFFECT=1 node agent-recovery.mjs || true
La primera ejecución escribe el efecto del ticket y se detiene antes de escribir el recibo en el journal. Reinicia la misma ejecución:
node agent-recovery.mjs
node agent-recovery.mjs
En la segunda ejecución, create_ticket debe mostrar recibo encontrado, y send_email debe aplicarse una vez. En la tercera, ambas llamadas ya tienen resultados en el journal. La salida final debe contener ejecución completada, y effects.json debe contener una entrada por cada clave.
Esta prueba demuestra tres decisiones del harness: el plan no se recalculó después del crash, el efecto incierto se reconcilió con una clave estable y el resultado recuperado se guardó antes de continuar. No demuestra que un proveedor real trate la clave de forma idempotente, que dos workers no puedan ejecutarse juntos ni que una transacción externa sea atómica.
Cuándo necesitas un lease y una versión del flujo
El ejemplo supone un proceso por ejecución. En producción, un despliegue puede iniciar un worker nuevo mientras el anterior sigue bloqueado en una llamada de red. Una clave de idempotencia reduce el riesgo, pero no sustituye el control de quién posee la ejecución.
Usa un lease con expiración y un fencing token cuando más de un worker pueda competir por la misma ejecución. El worker debe renovar el lease, validar el token antes de avanzar el checkpoint y perder la capacidad de escribir cuando el lease expire. La actualización también debe comprobar la versión esperada del estado para rechazar una escritura retrasada.
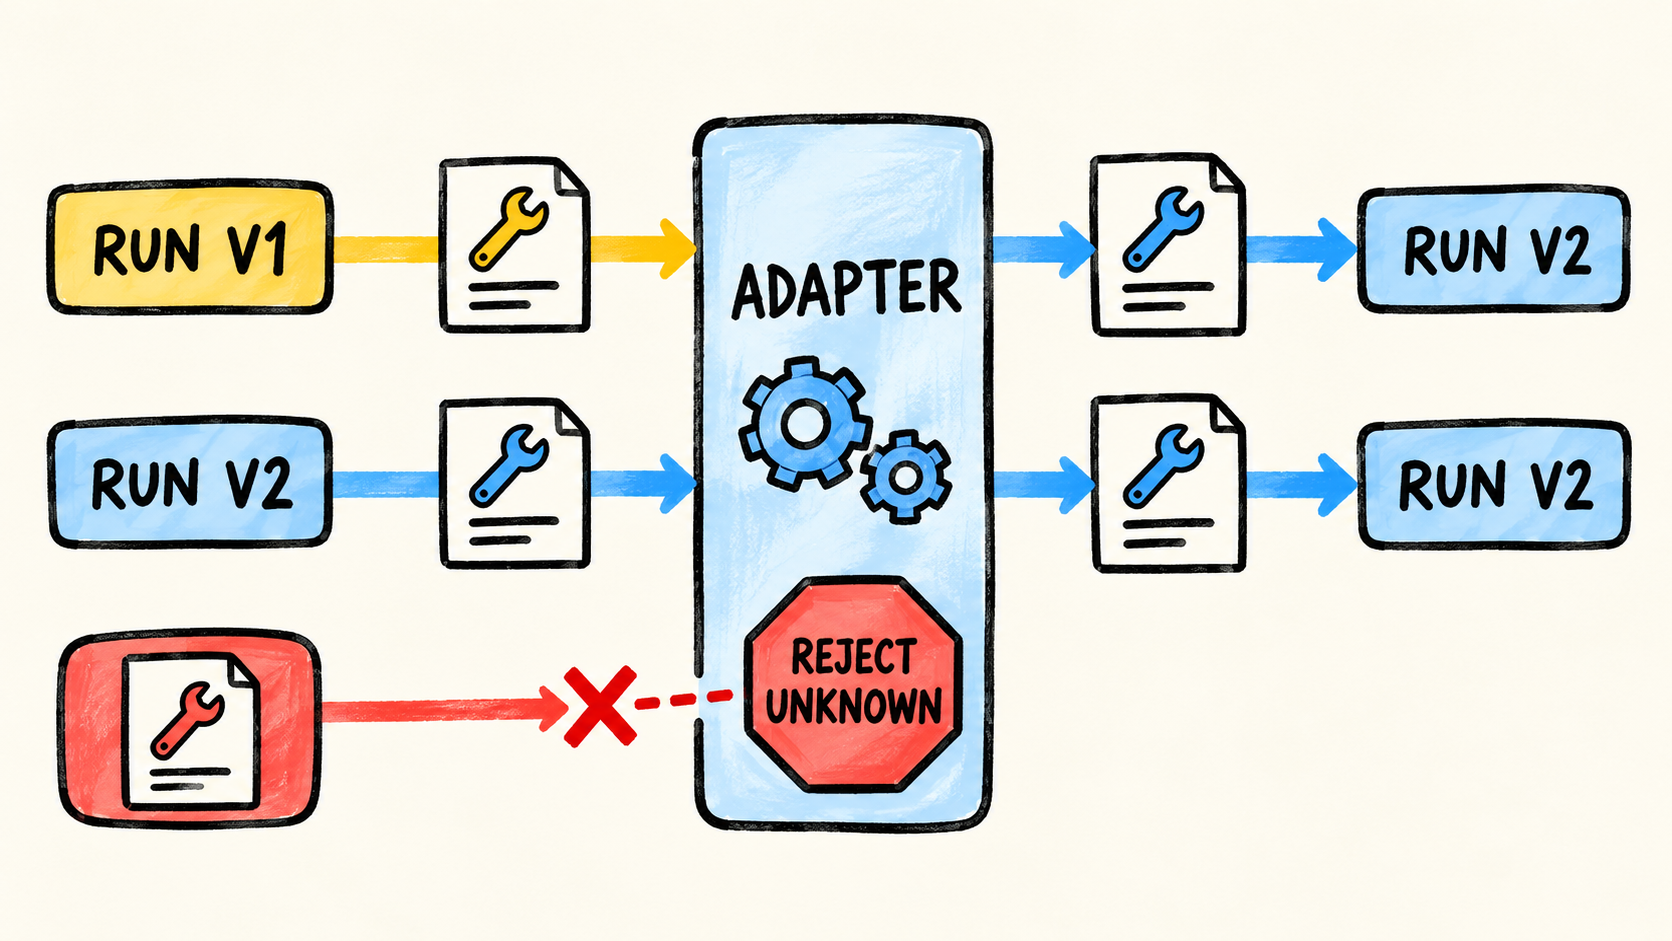
Fija la versión del flujo por ejecución. Una ejecución iniciada con otra descripción de tool, otro formato de argumentos o otra regla de transición puede no ser compatible con un journal antiguo. El recorrido de Microsoft Foundry para un agente resistente a crashes muestra el mismo principio: el servidor guarda la respuesta, crea checkpoints por etapa y omite la etapa checkpointed después del reinicio. En ese ejemplo, la opción de resiliencia debe activarse explícitamente.
Uso RemoteCode como herramienta propia cuando necesito continuidad entre sesiones de Codex y Claude Code. Puede reducir el contexto repetido, pero no sustituye el journal, el lease, la idempotencia ni la consulta del efecto externo.
Cuándo detenerse en vez de repetir
Detente cuando no puedas responder una de estas preguntas:
- ¿Qué operación lógica se está recuperando?
- ¿El sistema externo ofrece una clave de idempotencia o una consulta fiable?
- ¿Puedes observar el efecto sin producir otro cambio?
- ¿El worker antiguo perdió el lease y su capacidad de escribir?
- ¿Siguen vigentes la aprobación, el presupuesto y la versión del flujo?
Si la respuesta es no y la operación puede enviar un mensaje, crear un registro, cambiar un permiso o mover dinero, unknown es mejor que failed. failed sugiere que no ocurrió nada. unknown mantiene la obligación de reconciliar antes de volver a intentarlo.
Esta regla complementa cómo verificar una tool call antes de reintentarla. Ese artículo se centra en comprobar una llamada. Aquí la comprobación forma parte del protocolo completo de reinicio, que empieza en el checkpoint y termina con un resultado recuperado o una pausa explícita. Para una tarea que depende de un broker y redelivery, consulta cómo probar un worker de cola sin duplicar efectos.
Un workflow como Temporal, Step Functions, LangGraph u otro runtime durable puede asumir parte del journal y del replay. Eso reduce el código de infraestructura, pero no convierte una API externa en una operación exactamente una vez. Comprueba la semántica de retry, el almacenamiento, el comportamiento del paso interrumpido y la forma de pasar una clave al proveedor antes de confiar en el nombre del producto.
Cómo se produjo este artículo
Samuel Fajreldines es responsable de este artículo. La investigación combinó documentación actual de AWS, Microsoft y Cloudflare, inspección de resultados actuales, discusiones públicas recientes y comparación con el cluster de ejecución durable existente en el sitio. La fixture se ejecutó localmente con Node.js y usa solo archivos temporales y un proveedor falso. No llamó a un pago, email, ticket ni API externa real.
Usé asistencia de IA para descubrir fuentes, comparar páginas, organizar un primer borrador, crear la ilustración SVG y revisar la consistencia entre idiomas. La asistencia no ejecutó un agente real, no midió un sistema de producción ni sustituyó la verificación de las garantías del proveedor que uses.
Fuentes consultadas
- AWS, "From Agent Loop to Durable Execution: An Architecture Guide for Production Agents", consultado el 5 de noviembre de 2026.
- Microsoft Learn, "Deploy a crash-resilient long-running agent", actualizado el 14 de octubre de 2026 y consultado el 5 de noviembre de 2026.
- Microsoft Learn, "Microsoft Agent Framework Workflows: Checkpoints", consultado el 5 de noviembre de 2026.
- Cloudflare Agents, "Tasks", consultado el 5 de noviembre de 2026.