El agente devolvió una respuesta plausible, pero nadie puede explicar por qué consultó una herramienta, repitió otra o se detuvo antes de terminar. El log contiene el texto final. El fallo está en el camino que desapareció.
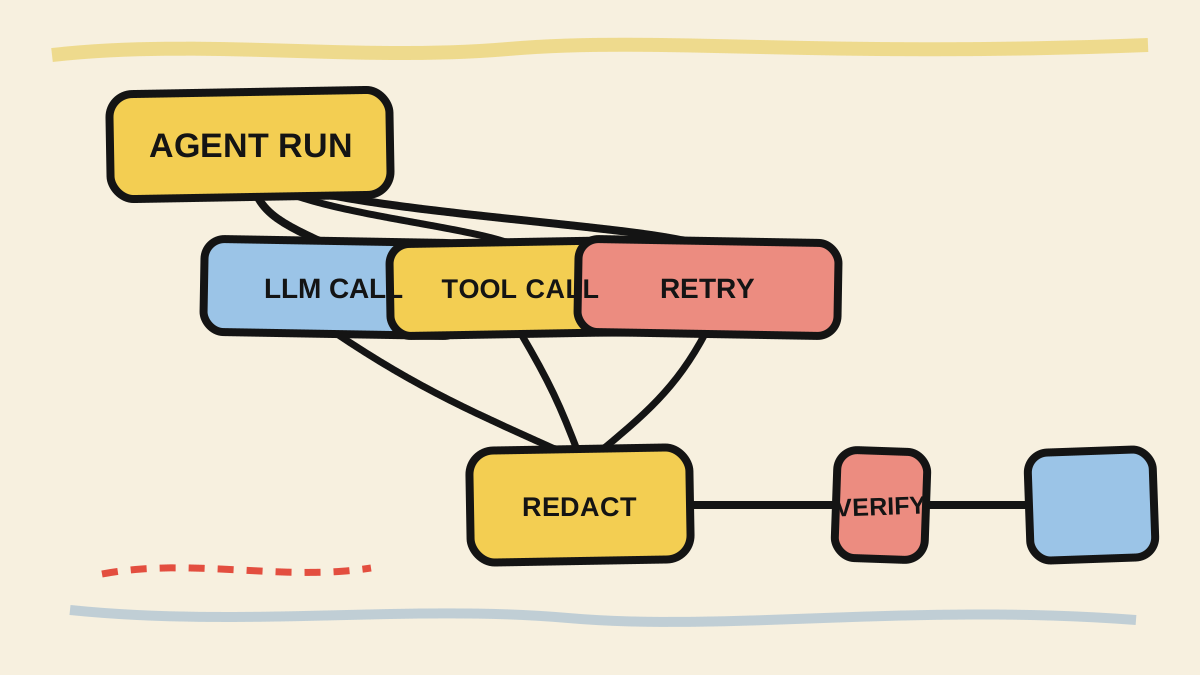
Una traza útil trata la ejecución del agente como un árbol. Un span raíz representa la ejecución. Los spans hijos representan llamadas al modelo, retrieval, tool calls, retries y comprobaciones. Así puedes encontrar qué paso fue lento, falló o cambió el estado sin convertir toda la conversación en un log.
Este artículo muestra una frontera pequeña en TypeScript para registrar ese camino. El ejemplo es ilustrativo: no se ejecutó contra un agente ni contra un backend de observabilidad. La documentación actual de OpenTelemetry describe una traza de GenAI con spans invoke_agent, chat y execute_tool, mientras OpenInference define categorías como AGENT, LLM y TOOL sobre el transporte de OpenTelemetry (OpenInference, "Traces").

Respuesta corta
- Crea un span raíz para cada ejecución del agente y un span hijo para cada operación que necesites diagnosticar.
- Propaga el contexto del span activo hasta la función que ejecuta la herramienta.
- Registra nombre, ID, duración, intento y resultado resumido. No copies argumentos, prompts ni respuestas por defecto.
- Trata validación, trazas y checkpoints como trabajos distintos: la telemetría explica el camino, pero no reanuda una ejecución.
¿Por qué el log del modelo no explica al agente?
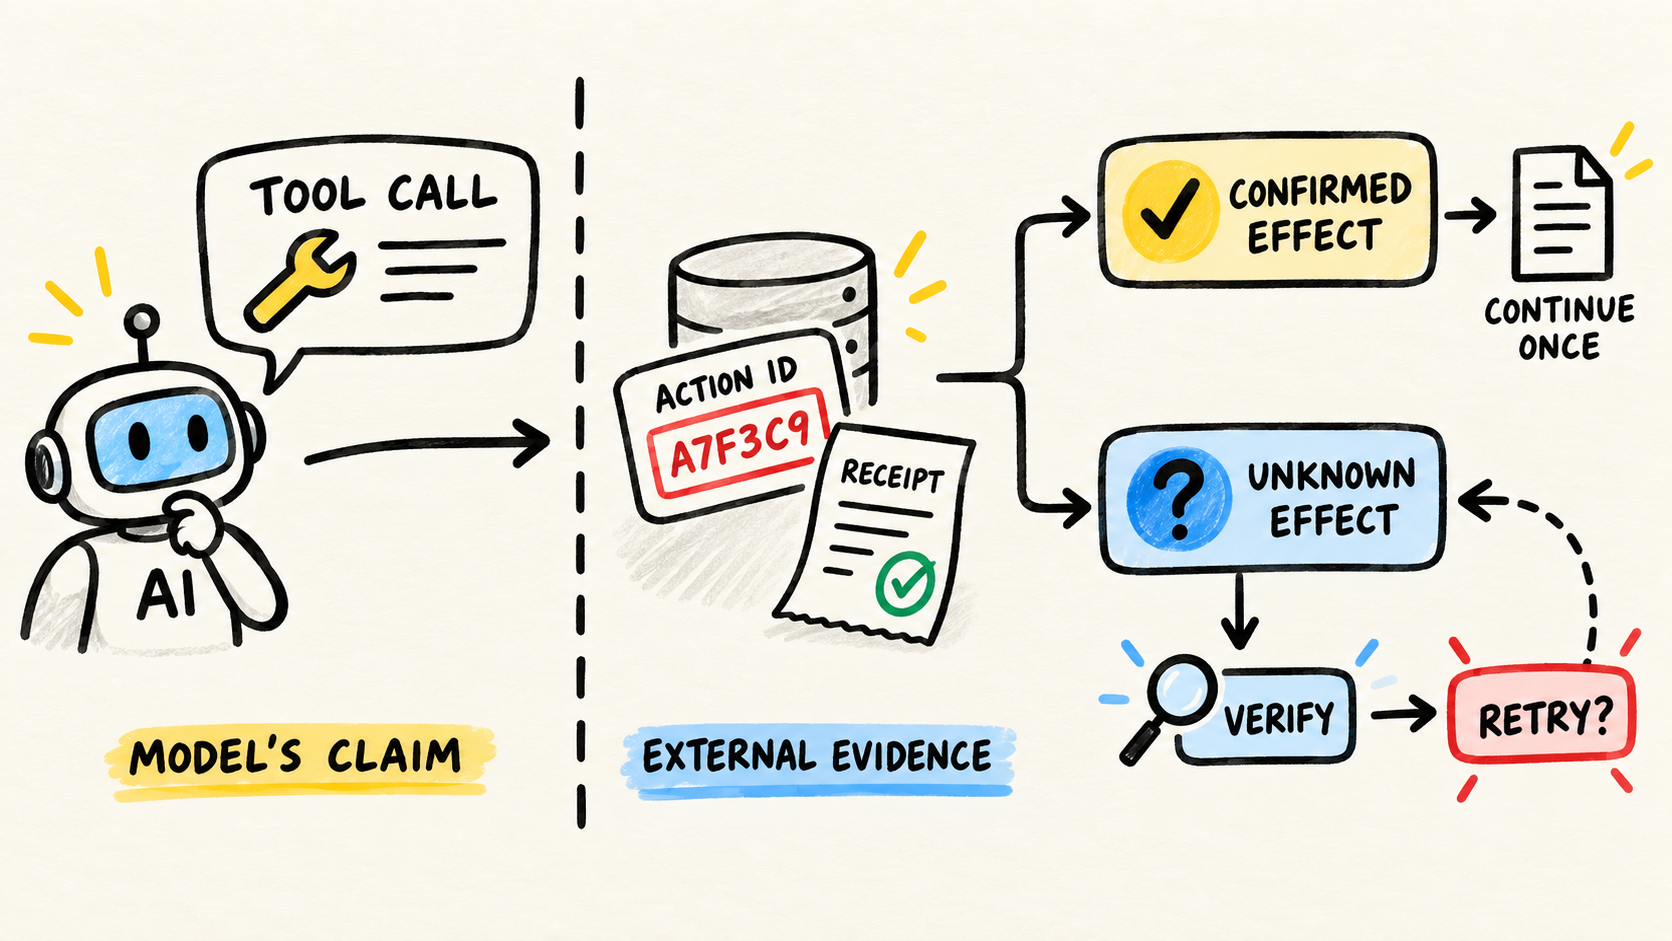
Una llamada al modelo es solo una parte de la ejecución. El modelo puede pedir una herramienta, recibir un resultado, elegir otra y reintentar después de un timeout. Si cada paso termina en un log separado, el revisor tiene que reconstruir el orden por hora y todavía puede perder la relación entre la decisión y el efecto.
OpenTelemetry describe las trazas como una forma de registrar operaciones relacionadas. Las relaciones padre-hijo llevan la estructura de la ejecución. Para un agente, eso significa que el run puede ser padre de una llamada al modelo, mientras una tool call aparece dentro del mismo ciclo.
Este modelo también mantiene claro el alcance. La conversación que vio el usuario es un registro del producto. La traza es un registro operativo. Pueden compartir un runId sin guardar el mismo contenido. Una discusión reciente de profesionales recomienda separar la conversación de la traza de ejecución, y mantener en la traza IDs, latencia, coste, errores y resultados resumidos (r/AI_Agents). Es lenguaje de la comunidad, no un requisito de OpenTelemetry, pero marca una frontera útil.
Empieza por nombrar las preguntas que el revisor debe contestar. ¿Qué ejecución falló? ¿Qué tool call ocurrió? ¿Qué intento se repitió? ¿Qué paso seguía activo? Si la respuesta no necesita el texto completo, no metas el texto completo en el span.
¿Cómo debe verse el árbol de spans de un agente?
Empieza con un span que represente la ejecución del agente. Dentro, crea spans para las operaciones que cambian el diagnóstico: llamadas al modelo, selección de herramienta, ejecución de herramienta, acceso a datos, retries y validaciones. No todos los helpers necesitan un span. Instrumentar cada función crea ruido y vuelve más difícil encontrar el fallo importante.
Un árbol mínimo puede tener esta forma:
agent.run
├── model.chat
├── tool.execute: search_orders
│   └── http.client
├── model.chat
└── tool.execute: update_order
    └── database.client
Los nombres pueden seguir el vocabulario de tu runtime. Lo importante es conservar una jerarquía y unos atributos consistentes. La página de GenAI de OpenTelemetry lista atributos para el modelo, tokens, mensajes, nombre de herramienta e ID de tool call. También indica que esos atributos se movieron a un repositorio dedicado y aparecen como development o deprecated en la vista anterior (OpenTelemetry, "Gen AI attributes"). Trata los nombres de GenAI como un contrato versionado, no como strings permanentes.
OpenInference aporta otra taxonomía útil cuando el backend entiende sus convenciones. Una operación de herramienta es TOOL, una llamada al modelo es LLM y el span que agrupa ambas puede ser AGENT (OpenInference, "Traces"). Puedes adoptar esa taxonomía sin abandonar OTLP. No mezcles nombres de un proveedor con atributos sin documentar la traducción.
¿Cómo instrumentar una tool call en TypeScript?
El wrapper debe abrir el span dentro del contexto de la ejecución, marcar el error si falla la función y cerrar el span en finally. El código siguiente es una ilustración breve. Usa atributos locales para resultado e intento, y registra el ID de la tool call sin guardar todo el payload.
import {
  SpanStatusCode,
  trace,
} from "@opentelemetry/api";

const tracer = trace.getTracer("agent-runtime");

type ToolInput = {
  name: string;
  callId: string;
  attempt: number;
};

export async function executeTool<T>(
  input: ToolInput,
  run: () => Promise<T>,
): Promise<T> {
  return tracer.startActiveSpan(
    `tool.execute:${input.name}`,
    {
      attributes: {
        "gen_ai.tool.name": input.name,
        "gen_ai.tool.call.id": input.callId,
        "agent.tool.attempt": input.attempt,
      },
    },
    async (span) => {
      try {
        const result = await run();
        span.setAttribute("agent.tool.outcome", "success");
        return result;
      } catch (error) {
        span.setAttribute("agent.tool.outcome", "error");
        span.recordException(error as Error);
        span.setStatus({
          code: SpanStatusCode.ERROR,
          message: error instanceof Error ? error.message : "unknown error",
        });
        throw error;
      } finally {
        span.end();
      }
    },
  );
}
Lo importante no es el nombre executeTool. Es el contexto activo. startActiveSpan hace que el span actual esté disponible mientras run() espera una respuesta. Si run() crea un cliente HTTP instrumentado, el span de red puede quedar como hijo. Si el runtime pierde el contexto al entrar en una cola, callback o worker, la traza se rompe en árboles separados.
La guía de Node.js de OpenTelemetry muestra cómo inicializar el SDK y avisa que la instrumentación debe cargarse antes del código que se observará. En ESM y TypeScript compilado a ESM, la inicialización también debe seguir la guía de loaders de la documentación. Un wrapper correcto no compensa un SDK que nunca se inicializó.
Este ejemplo no valida argumentos, no decide si una herramienta es segura y no implementa retries. El contrato para validar tool calls en TypeScript sigue siendo la frontera que decide si una acción puede comenzar. La traza registra lo que ocurrió después de esa decisión.
¿Qué atributos deben entrar en la traza?
Registra atributos que te ayuden a filtrar y comparar ejecuciones. El conjunto exacto depende del backend, pero estos campos son un buen inicio:
| Campo | Ejemplo | Por qué guardarlo |
|---|---|---|
agent.run.id |
run_8f2 |
conecta spans con el registro de ejecución |
gen_ai.agent.name |
order-assistant |
separa agentes del mismo servicio |
gen_ai.tool.name |
search_orders |
filtra la herramienta que falló |
gen_ai.tool.call.id |
call_42 |
conecta petición y resultado |
agent.tool.attempt |
2 |
muestra retries y loops |
agent.tool.outcome |
success |
cuenta fallos sin leer payloads |
error.type |
TimeoutError |
agrupa una causa operativa |
OpenTelemetry define los atributos como pares tipados de clave y valor. Prefiere valores de baja cardinalidad para los filtros habituales. Un ID de ejecución puede ayudar a investigar un caso, pero puede ser caro como dimensión de métrica. No conviertas cada argumento del cliente en una etiqueta de métrica.
El tamaño también importa. Una traza debe responder a una pregunta de diagnóstico, no reflejar el prompt. Guarda el nombre de la herramienta y un identificador del recurso cuando la política lo permita. Para payloads grandes, guarda un artefacto redactado aparte y pon en el span solo una referencia con acceso controlado. Esa referencia no debe permitir que cualquier lector de la traza descubra datos del cliente.
¿Cómo evitar que la telemetría filtre secretos?
Empieza con una política de exclusión. System prompts, mensajes del usuario, argumentos de herramientas, respuestas externas y headers pueden contener secretos o datos personales. Que una convención ofrezca un atributo para mensajes no obliga a tu aplicación a rellenarlo.
Una política sencilla tiene tres capas:
- Siempre permitido: nombre del servicio, versión, entorno, nombre de herramienta, tipo de error, duración y resultado categorizado.
- Permitido después de reducir: IDs internos, tamaño del payload, código de estado, hash irreversible y muestra redactada.
- Bloqueado por defecto: tokens, cookies, prompts completos, datos personales, argumentos financieros y respuestas de herramientas sin clasificar.
Redacta antes del exporter. Redactar solo en la interfaz del backend deja el dato expuesto durante el transporte, la retención y el acceso administrativo. Prueba también las excepciones: un mensaje de error puede contener el argumento original, y recordException puede llevar texto sensible si la aplicación no lo normaliza.
OpenInference explica que las aplicaciones de IA tienen requisitos de privacidad y admiten el enmascarado de campos. Usa ese riesgo como entrada de diseño, no como promesa de que una biblioteca resolverá tu política. El backend recibe lo que tu instrumentación decide enviar.
¿Cómo comprobar que la traza cuenta la historia correcta?
No te detengas en un span verde del dashboard. Crea un escenario controlado en el que el agente ejecute una herramienta conocida, fuerza un error y realiza un segundo intento. Comprueba que el árbol mantiene la misma traza, que el segundo intento sigue siendo hijo de la ejecución y que el error aparece en la herramienta correcta.
Un checklist corto ayuda:
- ¿La ejecución tiene un span raíz que empieza antes de la primera llamada al modelo?
- ¿Cada tool call tiene nombre, ID y número de intento?
- ¿La ejecución de la herramienta sigue siendo hija del run después de un
await? - ¿El error incluye estado y excepción sin un secreto?
- ¿Un retry crea un span nuevo en vez de sobrescribir el primer intento?
- ¿Una herramienta lenta muestra el cliente HTTP o la base de datos que la retrasó?
- ¿La traza contiene solo la referencia mínima para investigar?
Prueba también lo que debe faltar. Ejecuta una herramienta con un argumento sensible y comprueba que el exporter recibe una versión redactada o ningún payload. Interrumpe la llamada antes de su retorno y confirma que el span termina con error o cancelación. Si la traza solo es correcta en el camino feliz, todavía no es una prueba de observabilidad útil.
El owner de observabilidad de agentes de código explica cómo convertir eventos del agente en evidencia que un revisor pueda consumir. Aquí la unidad es menor: el span debe ubicar el paso que conviene investigar antes de decidir qué evidencia entra en CI.
Cuando la pregunta cambia de "¿qué ocurrió?" a "¿la trayectoria respetó el contrato?", usa los spans como entrada para probar la trayectoria de un agente de IA. La traza aporta eventos; la prueba decide cuáles estaban permitidos.
¿Traza, log, métrica o checkpoint?
Responden preguntas distintas. Una traza explica el orden y las relaciones. Un log guarda el detalle textual de un evento. Una métrica agrega conteos y latencia para alertas. Un checkpoint guarda el estado suficiente para reanudar una ejecución. Un sistema de agentes puede necesitar los cuatro.
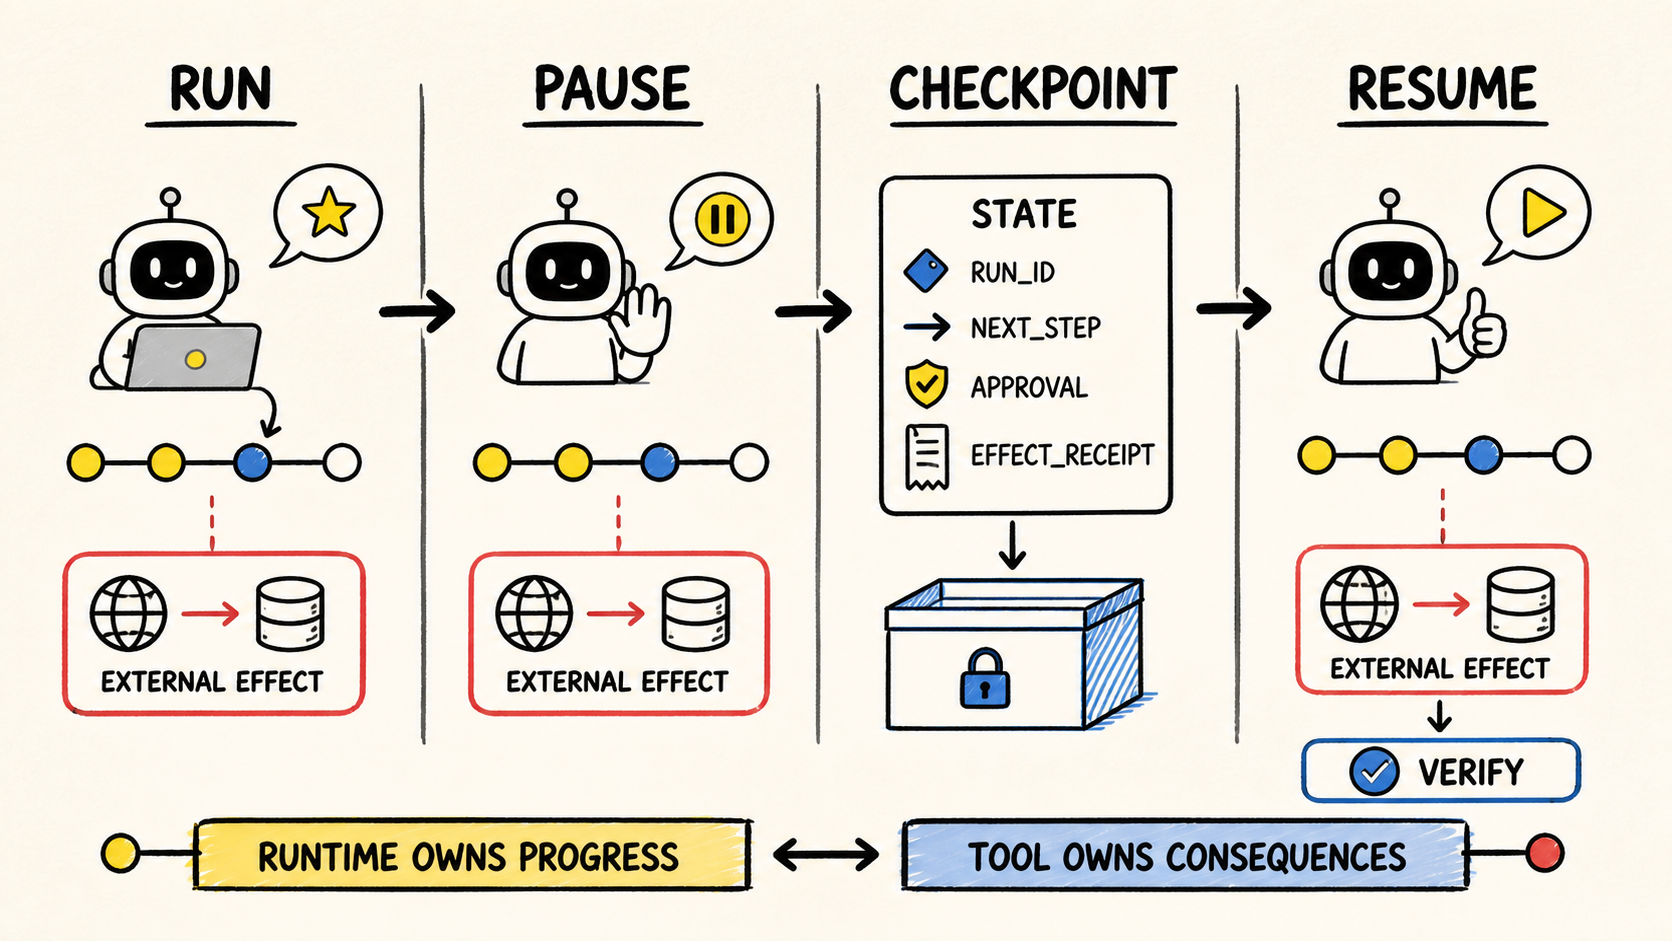
No uses una traza como base de datos de estado. Un exporter puede retrasar, muestrear, descartar o retener datos por poco tiempo. Si el agente debe continuar después de morir el proceso, persiste el estado y el contrato de cada paso fuera de la telemetría. El artículo sobre ejecución durable para agentes de IA cubre esa decisión.
Tampoco uses logs de texto como sustituto de la jerarquía. Un JSONL con todos los eventos ayuda en una auditoría, pero sin contexto padre, IDs estables y duración se convierte en una lista que alguien debe ordenar a mano. La traza aporta la estructura. Logs y artefactos pueden completar la historia.
Preguntas frecuentes
¿Tengo que registrar el prompt completo para depurar un agente?
No. Empieza con nombre del agente, modelo, tool call, IDs, intento, duración, error y resultado categorizado. OpenTelemetry ofrece atributos para mensajes y llamadas de herramientas, pero la aplicación decide qué exportar. Usa muestras redactadas o referencias protegidas solo cuando la política de datos lo permita.
¿Cada tool call necesita un span?
Cada llamada que necesites investigar merece una operación observable, pero no todos los helpers internos necesitan un span. Empieza con la ejecución, el modelo, la herramienta, retrieval, retry y dependencia externa. Si el árbol se vuelve ruidoso, elimina spans mecánicos después de conservar la frontera que explica la decisión.
¿OpenTelemetry sustituye a una herramienta de observabilidad de agentes?
No. OpenTelemetry proporciona APIs, SDKs, contexto y transporte para telemetría. Un backend puede añadir búsquedas, visualización y alertas específicas para agentes. OpenInference añade convenciones para spans de agente, modelo y herramienta. La elección del backend no elimina la necesidad de definir qué es seguro registrar.
¿Una traza permite reanudar un agente después de un fallo?
No por sí sola. La traza muestra lo que se observó y puede ayudar a ubicar el último paso. Reanudar exige estado persistido, idempotencia, una política de retry y una decisión sobre qué paso puede repetirse. Trata la traza como evidencia de ejecución, no como un checkpoint confiable.
Conclusión
Un agente observable no es el que produce más logs. Es el que deja una ruta corta para responder qué paso ocurrió, qué herramienta se llamó, qué intento falló y qué se puede compartir con seguridad.
Empieza con un span raíz de ejecución. Anida llamadas al modelo y herramientas. Propaga el contexto entre tareas asíncronas. Registra IDs, duración, intento, estado y error. Después prueba fallos, retries y argumentos sensibles. OpenTelemetry puede transportar la estructura, pero la calidad de la traza depende del contrato que escribas a su alrededor.
Cómo se hizo este análisis
Samuel Fajreldines es el autor responsable. La investigación comparó la documentación actual de OpenTelemetry y OpenInference, el cluster existente de observabilidad y discusiones públicas recientes de profesionales. El árbol de spans y el checklist de redacción son síntesis editorial original. El wrapper de TypeScript es ilustrativo y no se ejecutó contra un agente ni un backend. La asistencia de IA apoyó el descubrimiento, la redacción, la generación de la imagen, la localización y la revisión de consistencia. No aportó experiencia de producción ni sustituyó la verificación de fuentes. El autor también mantiene RemoteCode como herramienta de trabajo.
Fuentes consultadas
- OpenTelemetry, "Inside the LLM Call: GenAI Observability with OpenTelemetry", consultado el 2026-09-24
- OpenTelemetry, "Gen AI attributes", consultado el 2026-09-24
- OpenTelemetry, "Node.js getting started", consultado el 2026-09-24
- OpenTelemetry, "Traces", consultado el 2026-09-24
- OpenTelemetry, "Semantic conventions", consultado el 2026-09-24
- OpenInference, "Traces", consultado el 2026-09-24
- OpenInference, "OpenInference specification", consultado el 2026-09-24
- OpenInference, "OpenInference JS", consultado el 2026-09-24