El servicio puede estar sano y aun así hacer esperar al primer usuario después de un periodo sin tráfico. La solicitud espera a que se prepare la imagen, arranque el proceso y el contenedor esté listo para recibir tráfico. Después, la misma ruta puede responder con normalidad.
Llamamos cold start a este retraso, pero el nombre no indica qué ajuste lo resolverá. La introducción a Cloud Run explica la plataforma en general. Este artículo plantea una pregunta más concreta: ¿conviene mantener una instancia caliente, darle más CPU mientras arranca o aceptar la espera después de medirla?
No ejecuté un servicio de Cloud Run ni medí una aplicación concreta para este artículo. La comparación usa la documentación actual de Google Cloud y separa configuración, medición y decisión. Los comandos son referencias de configuración, no una prueba de resultados en tu proyecto.
Respuesta breve
- Usa
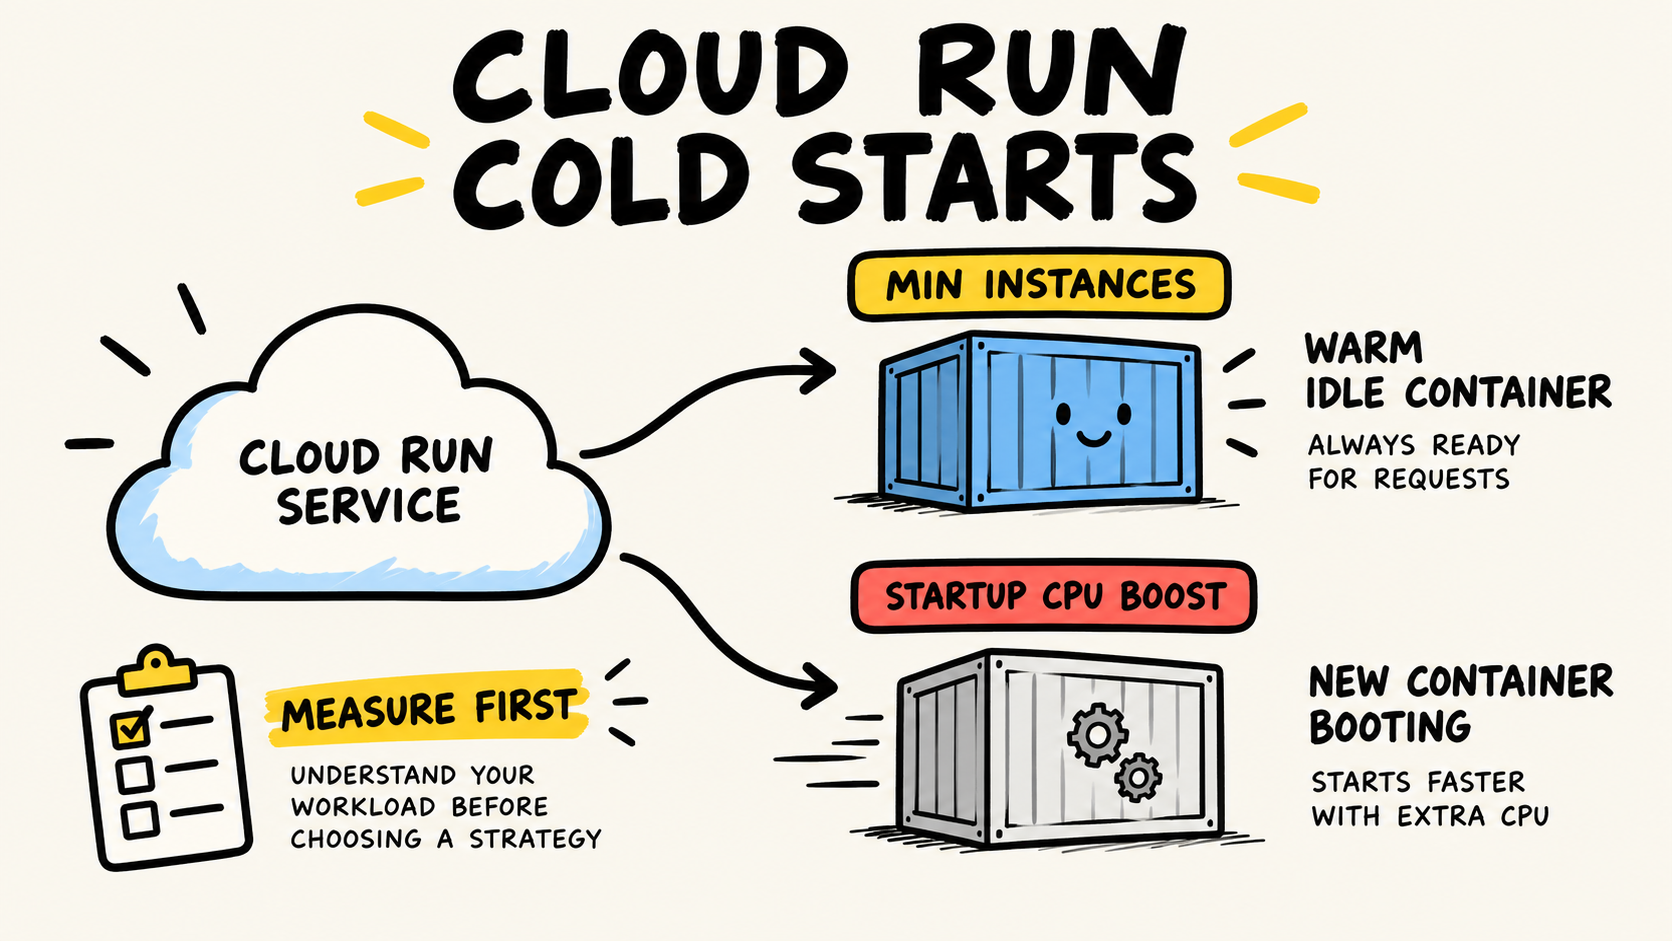
min-instancescuando el coste de la primera espera justifique mantener capacidad lista.- Usa startup CPU boost cuando una instancia nueva necesite arrancar más rápido, incluso durante el escalado.
- Reduce la imagen, los imports y la inicialización cuando el contenedor hace demasiado antes de escuchar en su puerto.
- Mide por separado la espera, el startup y la ejecución de la aplicación antes de elegir.
¿Cómo saber si el retraso es realmente un cold start?
En 2026, Google Cloud, “General development tips”, consultado el 23/09/2026, explica que Cloud Run separa el arranque de la instancia del procesamiento de la solicitud. Cuando un servicio escala desde cero, una solicitud puede esperar a que la imagen, el proceso y el puerto estén listos. Por eso, una latencia alta en la primera solicitud no demuestra que el handler o la base de datos sean lentos.
Empieza comparando tres medidas. La latencia pendiente muestra cuánto espera la solicitud antes de llegar a una instancia. La latencia de startup muestra cuánto tarda el contenedor en arrancar. La ejecución del usuario muestra cuánto tarda tu código después de recibir la solicitud. Sin esta separación, es fácil añadir CPU para corregir una consulta lenta o mantener una instancia activa para ocultar una imagen pesada.
Cloud Run expone la latencia de arranque del contenedor, el número de instancias y la latencia de las solicitudes mediante Cloud Monitoring. Google Cloud, “Monitor health and performance”, consultado el 23/09/2026, también indica dónde consultar las métricas del servicio. Si hay que investigar una solicitud concreta, usa logs y traces para saber si la espera provino del contenedor o de una dependencia.
¿Qué resuelve min-instances?
min-instances mantiene un número mínimo de instancias listas aunque no estén procesando solicitudes. En 2026, Google Cloud, “Set minimum instances for services”, consultado el 23/09/2026, documenta el valor predeterminado 0 y el uso de un mínimo mayor para reducir la latencia al escalar desde cero. Este ajuste ataca la espera por una primera instancia, no una ejecución lenta dentro de ella.
Tiene un coste directo: las instancias mantenidas por el mínimo generan cargos aunque no estén procesando solicitudes. El objetivo también es de mejor esfuerzo. La documentación menciona la capacidad de la zona o región, el rebalanceo de infraestructura, los fallos durante el arranque, los límites de cuota y la facturación desactivada como motivos por los que el servicio puede quedar temporalmente por debajo del número configurado. min-instances: 1 elimina una fuente de espera, pero no garantiza que cada solicitud encuentre una instancia caliente.
Una instancia caliente tampoco cubre automáticamente cada expansión. Si el tráfico supera la capacidad disponible, el servicio puede iniciar más instancias. La comparación sobre cómo elegir la concurrencia en Cloud Run ayuda a decidir cuántas solicitudes debe atender una instancia. No uses una concurrencia alta para ocultar un arranque lento ni fijes un mínimo alto antes de saber cuántas instancias crea tu tráfico.
El caso típico para min-instances es una API interactiva con un objetivo estricto de latencia para la primera solicitud después de estar inactiva. Si una ruta recibe pocas llamadas al día y los usuarios aceptan esperar, escalar desde cero puede ser la opción más sencilla.
¿Qué resuelve startup CPU boost?
Startup CPU boost proporciona CPU adicional durante el arranque de la instancia y durante 10 segundos después de que la instancia empieza. En 2026, Google Cloud, “Configure CPU limits for services”, consultado el 23/09/2026, documenta que un límite de 0 a 1 vCPU recibe un boost hasta 2, mientras que los demás límites siguen sus propias reglas. La misma página indica que la CPU adicional se cobra durante el arranque.
Esta función acelera el camino de una instancia que tiene que crearse. No mantiene una instancia encendida ni elimina la descarga de la imagen, la inicialización de dependencias o una base de datos lenta. Si el retraso procede del trabajo que el proceso hace antes de escuchar en su puerto, más CPU puede ayudar. Si empieza después del handler, revisa la latencia de ejecución y la dependencia involucrada.
Puedes activar la función en una revisión con el comando documentado por Google Cloud:
gcloud run services update SERVICE --cpu-boostUsa --no-cpu-boost para quitarla. El cambio crea una nueva revisión, así que compara la revisión anterior y la nueva bajo el mismo escenario de tráfico. No conviertas la palabra “boost” en una promesa de latencia fija. El beneficio depende del runtime, la imagen y el trabajo realizado durante el arranque.
Min instances o CPU boost: ¿cuál conviene?
La decisión se entiende mejor cuando nombras dónde ocurre la espera. min-instances compra disponibilidad. Startup CPU boost compra capacidad temporal para arrancar. Optimizar el contenedor reduce el trabajo que ambos caminos deben hacer.
| Síntoma observado | Primera hipótesis | Ajuste para probar | Qué falta verificar |
|---|---|---|---|
| La primera solicitud después de escalar a cero tarda | No hay una instancia lista | Configurar min-instances por encima de 0 |
coste, revisiones y fallos que eliminen la instancia |
| Una instancia nueva tarda en arrancar | El startup usa CPU o hace una inicialización pesada | Activar startup CPU boost | latencia de startup y facturación de CPU adicional |
| Todas las revisiones arrancan despacio | La imagen o los imports hacen demasiado trabajo | Reducir imagen e inicialización | tamaño, dependencias, puerto y startup probe |
| La solicitud llega, pero el handler tarda | Problema de ejecución o dependencia | Revisar código, base de datos y traces | latencia de ejecución del usuario |
| La espera aparece solo durante picos | Falta capacidad durante el escalado | Revisar concurrencia, CPU y límites | número de instancias y latencia pendiente |
Como regla práctica, prueba primero la opción más específica. Confirma que la espera está en el startup. Después reduce el trabajo del contenedor. Solo entonces elige entre mantener capacidad lista y acelerar cada arranque nuevo. Este orden evita convertir un problema de código en gasto permanente.
¿Cómo medir el cambio sin engañarte?
En 2026, Google Cloud, “About instance autoscaling in Cloud Run services”, consultado el 23/09/2026, describe el equilibrio entre la latencia del cold start y el tiempo que una solicitud queda pendiente esperando un espacio o una instancia nueva. La documentación indica que una solicitud puede permanecer pendiente hasta 3,5 veces el startup medio o 10 segundos, lo que sea mayor. Ese es un comportamiento de la plataforma, no el SLO de tu aplicación.
Haz una comparación que cambie una variable cada vez:
- Registra revisión, región, CPU, memoria, imagen, concurrencia e instancias mínimas.
- Observa latencia pendiente, latencia de startup, ejecución del usuario, errores y número de instancias.
- Compara el tráfico después de escalar a cero con el tráfico que crea instancias adicionales.
- Revisa los logs de creación de instancias. Cloud Logging para Cloud Run registra razones como
MANUAL_OR_CUSTOMER_MIN_INSTANCE,AUTOSCALINGyDEPLOYMENT_ROLLOUT. - Quita el ajuste si la métrica que motivó el cambio no mejora o si el coste sube sin beneficio dentro del objetivo de latencia.
Un despliegue correcto demuestra que la revisión arrancó. No demuestra que la primera solicitud cumpla tu objetivo. Google Cloud, “Introduction to Cloud Run troubleshooting”, consultado el 23/09/2026, recomienda observar la latencia del servicio y filtrar instancias concretas en los logs cuando aparecen picos.
¿Cómo configurar y verificar min-instances?
El siguiente comando actualiza el servicio para mantener una instancia mínima, según la configuración elegida:
gcloud run services update SERVICE --min 1
gcloud run services describe SERVICE
Usa el segundo comando para revisar la configuración devuelta antes de atribuir una mejora al ajuste. La documentación también distingue las instancias mínimas a nivel de servicio y a nivel de revisión. Cuando el tráfico se divide entre revisiones, esa diferencia cambia dónde se mantiene la capacidad caliente.
Prueba al menos tres momentos: después de un periodo sin tráfico, durante el escalado y después de un despliegue. Un mínimo configurado puede perder efecto si el contenedor falla durante el arranque o no supera un health check. La guía sobre health checks en Google Cloud y AWS ayuda a separar disponibilidad, reinicio y latencia de la aplicación.
No añadas un keep-alive artificial solo para impedir el scale-to-zero. Una llamada periódica cambia el patrón de tráfico, genera coste y puede ocultar el comportamiento que querías medir. Si la aplicación necesita procesamiento continuo, consumo de una cola o tareas largas, compárala con Cloud Run Jobs y sus reintentos en vez de convertir una API en un worker improvisado.
¿Cuándo no conviene pagar por una instancia caliente?
Las instancias mínimas no son una solución universal. Puede no compensar usarlas cuando el tráfico es escaso, la ruta tolera unos segundos de espera, el problema está en la base de datos o la aplicación todavía no separa startup y ejecución. En ese caso, escalar desde cero conserva la sencillez mientras mejoras el contenedor y recoges datos.
No uses min-instances para compensar un crash, un health check incorrecto, una cuota agotada o una imagen que tarda demasiado en arrancar. Cloud Run intentará alcanzar el mínimo, pero una instancia que nunca está sana no atiende a nadie. Corrige la causa y vuelve a medir.
El objetivo no es mantener una instancia encendida para siempre. Es saber qué espera encontró el usuario y qué ajuste la reduce. A veces la mejor optimización es una imagen más pequeña. Otras veces es CPU durante el startup. Otras, una instancia caliente. Si la primera solicitud no tiene un objetivo estricto de latencia, quizá no necesites ninguno de estos cambios.
Preguntas frecuentes
¿min-instances: 1 elimina todos los cold starts?
No. Mantiene al menos una instancia como objetivo de disponibilidad, pero no evita cada expansión, reinicio, crash, límite de cuota o evento de capacidad. La documentación de Google Cloud sobre instancias mínimas también describe la función como un objetivo de mejor esfuerzo. Mide la latencia de startup y el número de instancias antes y después.
¿Startup CPU boost mantiene el contenedor encendido?
No. La función proporciona CPU adicional durante el startup y durante 10 segundos después. Hace que una instancia nueva arranque más rápido, pero no sustituye a min-instances. Tampoco corrige el trabajo del handler después de que el contenedor está listo. Usa las métricas de startup y ejecución para separar ambos caminos.
¿Debo activar los dos ajustes a la vez?
Puede tener sentido, pero no como primer paso automático. min-instances reduce la posibilidad de empezar desde cero, mientras CPU boost ayuda cuando todavía hay que crear una instancia nueva. Activa un ajuste cada vez, compara la revisión bajo tráfico controlado y revisa facturación, startup, latencia pendiente y ejecución.
¿Cómo diferencio un cold start de una base de datos lenta?
Compara la latencia pendiente, el startup del contenedor y la ejecución del usuario. Si el startup es normal, pero la ejecución crece cuando la aplicación abre una conexión o ejecuta una consulta, las instancias mínimas no atacan la causa. Usa Cloud Logging o Cloud Trace para atribuir la espera a la dependencia correcta.
Conclusión
Cold start es una pregunta de medición antes de ser una pregunta de configuración. min-instances mantiene capacidad caliente. Startup CPU boost hace que una instancia nueva arranque más rápido. Optimizar la imagen y la inicialización reduce el trabajo de ambos caminos.
Empieza con una revisión observable. Registra startup, espera pendiente, ejecución, errores, número de instancias y coste. Cambia una variable. Si la primera solicitud no tiene un objetivo estricto de latencia, acepta el scale-to-zero y dedica el esfuerzo al cuello de botella que muestren los datos.
Cómo se hizo este análisis
Samuel Fajreldines es el autor responsable. La investigación comparó la documentación actual de Google Cloud Run, la estructura de los artículos recientes y señales públicas de practicantes. La matriz de decisión es una síntesis editorial original. Los comandos no se ejecutaron contra un proyecto de Cloud Run para este artículo, y no hay benchmark, caso de cliente ni precio calculado. La asistencia de IA apoyó la búsqueda, la redacción, la generación de la imagen, la localización y la revisión de consistencia; no aportó experiencia de producción ni sustituyó la verificación de las fuentes.
Fuentes consultadas
- Google Cloud, “General development tips”, consultado el 23/09/2026
- Google Cloud, “Set minimum instances for services”, consultado el 23/09/2026
- Google Cloud, “Configure CPU limits for services”, consultado el 23/09/2026
- Google Cloud, “About instance autoscaling in Cloud Run services”, consultado el 23/09/2026
- Google Cloud, “Monitor health and performance”, consultado el 23/09/2026
- Google Cloud, “Logging and viewing logs in Cloud Run”, consultado el 23/09/2026
- Google Cloud, “Introduction to Cloud Run troubleshooting”, consultado el 23/09/2026