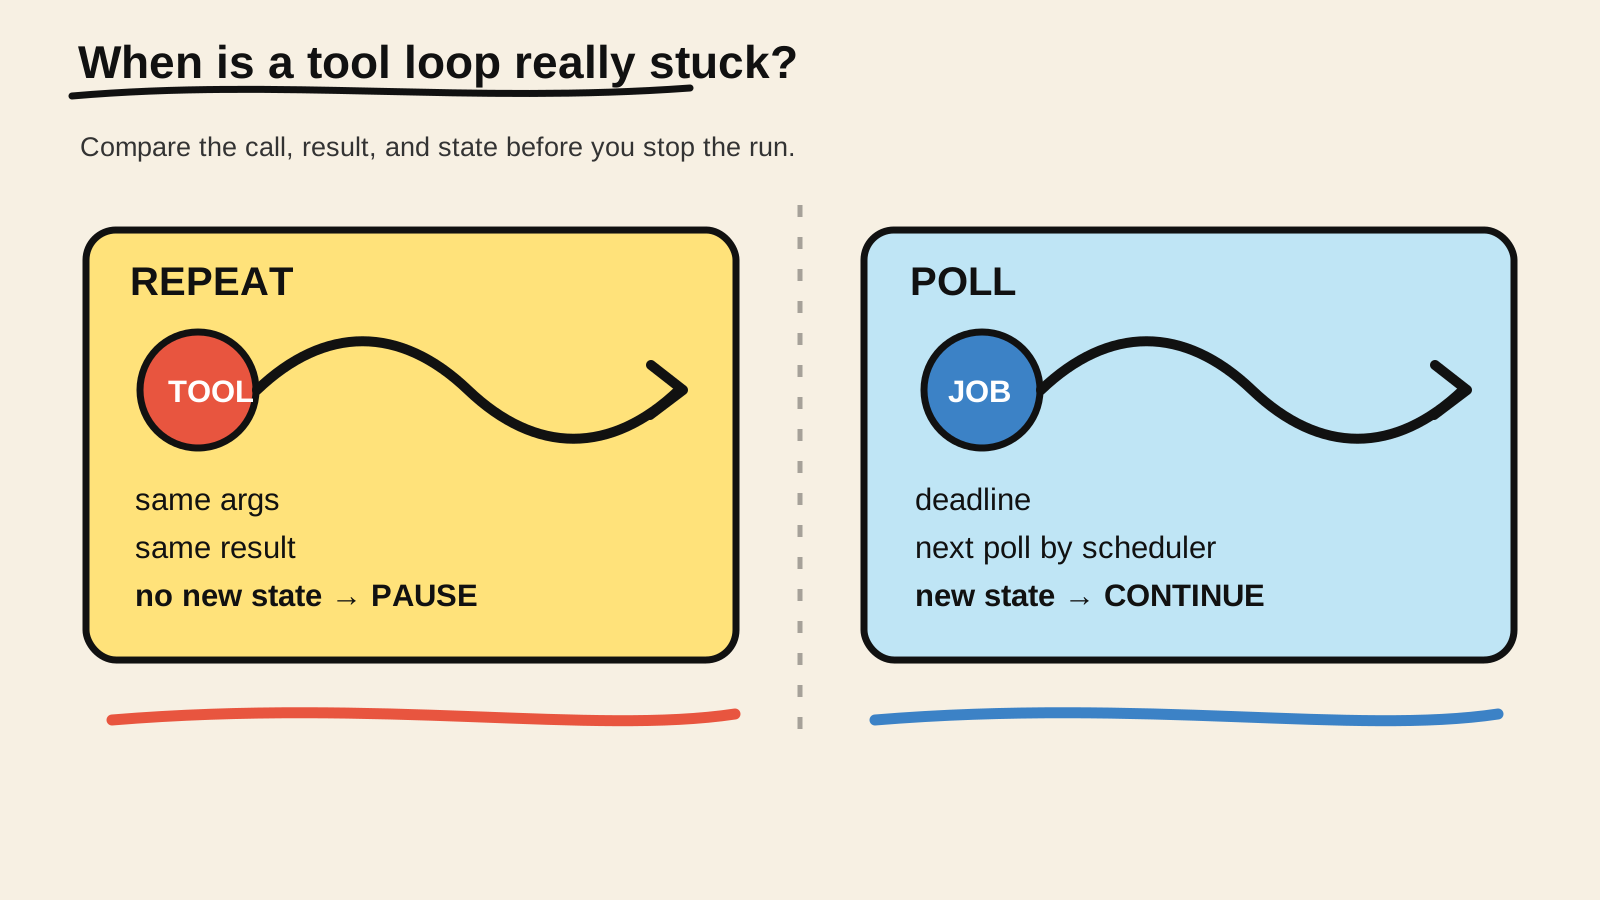
Repetir una tool no significa automáticamente que haya un loop. Un agente puede llamar varias veces a get_job_status porque el job todavía está ejecutándose. La señal de problema aparece cuando la llamada, el resultado útil y el estado de la tarea siguen iguales, sin un plazo ni un cambio esperado que justifique otra petición.
La regla práctica es poner un detector en el runtime, antes de ejecutar la siguiente tool. Normaliza el nombre y los argumentos, compara el resultado que importa y registra alguna evidencia de progreso. Cuando vuelve la misma combinación sin progreso, pausa el run con un motivo explícito. Cuando es polling, el scheduler debe controlar el intervalo, el plazo y el estado terminal, en vez de dejar que el modelo decida por sí solo.
Este artículo es un spoke de cómo evitar que un agente de IA entre en un loop infinito. Ese artículo cubre la política general de parada. Aquí la pregunta es más concreta: ¿cómo reconocer una repetición antes de gastar todo el presupuesto y cómo no bloquear un job que todavía puede avanzar?

Respuesta corta
- Compara el nombre de la tool y los argumentos normalizados, no solo el nombre.
- Compara el resultado o la versión de estado que puede cambiar la siguiente decisión.
- Pausa cuando la misma llamada devuelve la misma evidencia sin progreso observable.
- Trata el polling como un contrato separado, con plazo, próxima consulta y estado terminal controlados por el runtime.
- Devuelve
no_progressopoll_deadline_exceededal llamador. No escondas la parada en un prompt.
¿Por qué no basta con contar llamadas?
Un contador sencillo marca casi cualquier agente que está trabajando. Buscar tres documentos, leer dos archivos o consultar cinco pedidos puede repetir la misma tool con argumentos distintos. El nombre search aparece varias veces, pero la tarea avanzó.
El Agents SDK para JavaScript documenta el loop del runner: el runtime llama al modelo, ejecuta las tools cuando aparecen y vuelve al modelo hasta recibir una salida final o alcanzar maxTurns. La página también documenta un valor predeterminado de 10 turnos y MaxTurnsExceededError cuando se alcanza el techo, salvo que se cambie el límite. Ese techo es una barrera de seguridad, no un detector de progreso.
El Microsoft Agent Framework recomienda limitar los loops autónomos porque una condición de finalización puede fallar, el modelo puede atascarse y un evaluador puede ser probabilístico. Eso respalda el límite duro. No indica qué repetición es inútil en tu dominio. Esa parte necesita evidencia de la ejecución.
Un detector local debe responder a tres preguntas:
- ¿La llamada es estructuralmente igual?
- ¿El resultado útil es igual?
- ¿Cambió alguna parte del estado de la tarea desde el intento anterior?
Si la respuesta es “sí, sí y no” varias veces seguidas, tienes una señal mejor que un contador global. Aun así, no es una prueba universal. Una lectura repetida puede ser una verificación deliberada y una API puede devolver el mismo resultado antes de cambiar. Por eso, el detector debe pausar o pedir una decisión, no fingir que conoce la intención del modelo.
¿Cómo crear una huella estable de la tool?
Compara la estructura de la llamada, no la representación textual del transcript. El orden de las claves de un objeto JSON no debería hacer que dos llamadas iguales parezcan distintas. Los campos volátiles, como requestId y las marcas de tiempo, tampoco representan un cambio de intención.
Una huella mínima contiene el nombre de la tool y los argumentos normalizados. Para aumentar la confianza, guarda también una huella del resultado que afecta al siguiente paso. No pongas todo el prompt en la clave. Es innecesario y puede filtrar datos sensibles a logs o métricas.
La siguiente es una fixture offline. No llama a un LLM ni a una tool real. progressKey debe venir del dominio: una versión del job, la cantidad de elementos procesados, un hash del diff u otro hecho que la aplicación pueda observar.
import assert from "node:assert/strict";

function stableJson(value) {
  if (Array.isArray(value)) {
    return `[${value.map(stableJson).join(",")}]`;
  }
  if (value && typeof value === "object") {
    return `{${Object.keys(value).sort().map((key) =>
      `${JSON.stringify(key)}:${stableJson(value[key])}`,
    ).join(",")}}`;
  }
  return JSON.stringify(value);
}

function fingerprint(step) {
  return stableJson({ tool: step.tool, args: step.args });
}

function resultFingerprint(step) {
  return stableJson({ tool: step.tool, result: step.result });
}

function inspectStep(step, previous, options = { repeatLimit: 3 }) {
  const call = fingerprint(step);
  const result = resultFingerprint(step);
  const sameObservation = call === previous.call && result === previous.result;
  const stateChanged = step.progressKey !== undefined
    && step.progressKey !== previous.progressKey;
  const repeats = sameObservation && !stateChanged
    ? previous.repeats + 1
    : 0;

  if (stateChanged) {
    return { action: "continue", reason: "progress", call, result, repeats: 0 };
  }
  if (repeats >= options.repeatLimit) {
    return { action: "pause", reason: "no_progress", call, result, repeats };
  }
  return { action: "continue", reason: "observe", call, result, repeats };
}

const first = {
  tool: "read_status",
  args: { jobId: "job-7", verbose: false },
  result: { status: "running" },
  progressKey: "version-4",
};

let state = {
  call: fingerprint(first),
  result: resultFingerprint(first),
  progressKey: first.progressKey,
  repeats: 0,
};

for (let i = 0; i < 3; i += 1) {
  const decision = inspectStep(first, state);
  assert.equal(decision.action, i === 2 ? "pause" : "continue");
  state = { ...state, ...decision, progressKey: first.progressKey };
}

const changed = inspectStep({ ...first, progressKey: "version-5" }, state);
assert.deepEqual(changed, {
  action: "continue",
  reason: "progress",
  call: state.call,
  result: state.result,
  repeats: 0,
});

console.log("no-progress detector fixture passed");
Ejecútala con Node.js:
node repeated-tool-guard.mjsEn la fixture, repeatLimit: 3 es un parámetro de prueba. No lo trates como una recomendación universal. Una lectura puede ser barata y segura; una escritura puede tener que pausarse en la primera repetición. La política debe conocer el riesgo y el contrato de la operación.
¿Cuándo es polling legítimo una repetición?
El polling es una forma esperada de repetir una consulta cuando el estado externo puede cambiar con el tiempo. El problema empieza cuando el modelo controla la repetición sin límite. La misma respuesta running puede consumir muchos turnos y el runtime quizá no sepa si la siguiente petición va a esperar, cambiar el intervalo o llamar otra vez sin más.
Separa el polling de un loop libre del agente. La tool o el runtime debería declarar algo parecido a esto:
| Campo | Responsabilidad |
|---|---|
jobId |
identifica el trabajo que se consulta |
status |
distingue running, completed y failed |
nextPollAt |
indica cuándo puede ocurrir la siguiente consulta |
deadline |
termina el presupuesto de espera compartido |
progressKey |
muestra si cambió un hecho observable |
Mientras status sea running, el scheduler puede programar otra consulta hasta deadline. El modelo no tiene que emitir la misma tool en cada turno. Si llega el plazo sin un estado terminal, devuelve poll_deadline_exceeded y deja que el llamador decida si espera más, vuelve a poner el job en una cola o pide intervención.
No uses el nombre get_status como permiso permanente. Una lectura puede ser legítima durante algunos ciclos y convertirse en desperdicio después. El límite pertenece al run y al job, con un reloj compartido. Un retry creado dentro de la tool no debe reiniciar el contador del run.
La implementación de detección de loops de Gemini CLI es una referencia pública útil para una distinción importante: compara los argumentos y contempla la equivalencia semántica en lugar de comparar solo el nombre de la tool. Tu producto puede necesitar reglas distintas. Trátalo como código para inspeccionar, no como una política universal.
¿Qué debe hacer el runtime cuando se activa el detector?
No vuelvas a llamar a la misma tool antes de cambiar la condición que causó la repetición. El runtime tiene tres caminos posibles:
- Pausar: registra
no_progress, la huella, la última evidencia y la siguiente decisión permitida. - Pedir un cambio de estrategia: devuelve un mensaje corto con la llamada repetida y exige otra tool, otros argumentos o una explicación del bloqueo. Es un intento nuevo y controlado, no permiso para repetir automáticamente.
- Escalar: si la tool tiene efectos externos, el estado es desconocido o el detector no puede decidir con seguridad, envía el run a una persona o a una cola de reconciliación.
El artículo sobre rastrear tool calls de un agente con OpenTelemetry explica dónde registrar el run, la tool, el intento y el resultado resumido. El trace ayuda a investigar el primer paso repetido. No debería ser el único control: la guarda debe estar en el dispatcher antes de la siguiente ejecución.
No conviertas cualquier error en no_progress. Un 401 puede exigir renovar credenciales, un 400 puede exigir corregir argumentos y un timeout después de una escritura puede exigir verificar si la tool call tuvo efecto antes de repetir. El motivo de parada debe decir qué decisión está bloqueada.
Si el fallo es solo un timeout de prueba, usa un reloj inyectable y una fixture que separe espera y efectos, como en cómo probar el timeout de una tool de agente sin esperar ni duplicar efectos. Timeout, repetición sin progreso y efecto desconocido son diagnósticos diferentes aunque aparezcan en el mismo run.
¿Cómo probarlo sin depender del modelo?
Construye trayectorias pequeñas y deterministas. La prueba no necesita demostrar que un modelo elegiría una tool. Necesita demostrar que el runtime reconoce el patrón y no ejecuta una llamada prohibida.
| Escenario | Evidencia | Decisión esperada |
|---|---|---|
| Mismo nombre, argumentos distintos | cambió la intención | continuar |
| Mismo nombre y argumentos, resultado distinto | existe evidencia nueva | continuar y actualizar el estado |
| Mismo nombre, argumentos y resultado, estado igual | no hay progreso observable | pausar después del límite |
get_status con running |
el job todavía puede avanzar | programar desde el scheduler hasta el plazo |
get_status después del plazo |
se agotó el presupuesto de espera | devolver poll_deadline_exceeded |
| misma escritura después de un timeout | el efecto externo es ambiguo | verificar el efecto antes de repetir |
| ciclo A, B, A, B | las llamadas oscilan | pausar o pedir intervención |
Prueba también la normalización. Dos cargas con las claves en distinto orden deben producir la misma huella. Elimina un campo volátil antes de comparar si no representa un cambio de intención. No elimines el campo que identifica el recurso o la versión que puede cambiar realmente el resultado.
En producción, cuenta el intento cuando el dispatcher admite la llamada, no después de que termina. Si muere el proceso, un contador en memoria desaparece. En un run durable, persiste el estado de la guarda junto al run, sin confundir ese registro con un recibo del sistema externo.
Método y límites
Consulté la documentación actual del OpenAI Agents SDK, la documentación de Microsoft Agent Framework y una implementación pública de detección de loops de Gemini CLI el 19/11/2026. También comparé resultados públicos y discusiones de practicantes, pero usé esas discusiones solo para el lenguaje y los síntomas. No ejecuté el detector contra un proveedor de modelos ni una tool de producción; la fixture es local y determinista.
La asistencia de IA ayudó a organizar la investigación, revisar la prosa, crear las versiones localizadas y comprobar la coherencia de los ejemplos. No proporcionó una medición de falsos positivos. Cuando necesito prolongar una sesión de depuración con menos contexto repetido, uso RemoteCode, una herramienta mía; la mención es editorial y no demuestra el comportamiento del detector.
Conclusión
Un agente está atascado cuando sigue consumiendo pasos sin añadir evidencia útil, no simplemente porque llamó una tool más de una vez. Compara la llamada normalizada, el resultado útil y el estado observable. Si los tres permanecen iguales, pausa con un motivo que el runtime pueda registrar.
El polling merece otro contrato. El scheduler controla la próxima consulta, el plazo y el estado terminal. Así, un job lento todavía puede terminar, mientras que una repetición sin progreso no consume silenciosamente el resto del presupuesto detrás de un transcript que solo parece activo.
Fuentes consultadas
- OpenAI Agents SDK, Running Agents, consultado el 19/11/2026.
- Microsoft Agent Framework, Agent looping, consultado el 19/11/2026.
- Google Gemini CLI, loopDetectionService.ts, consultado el 19/11/2026.