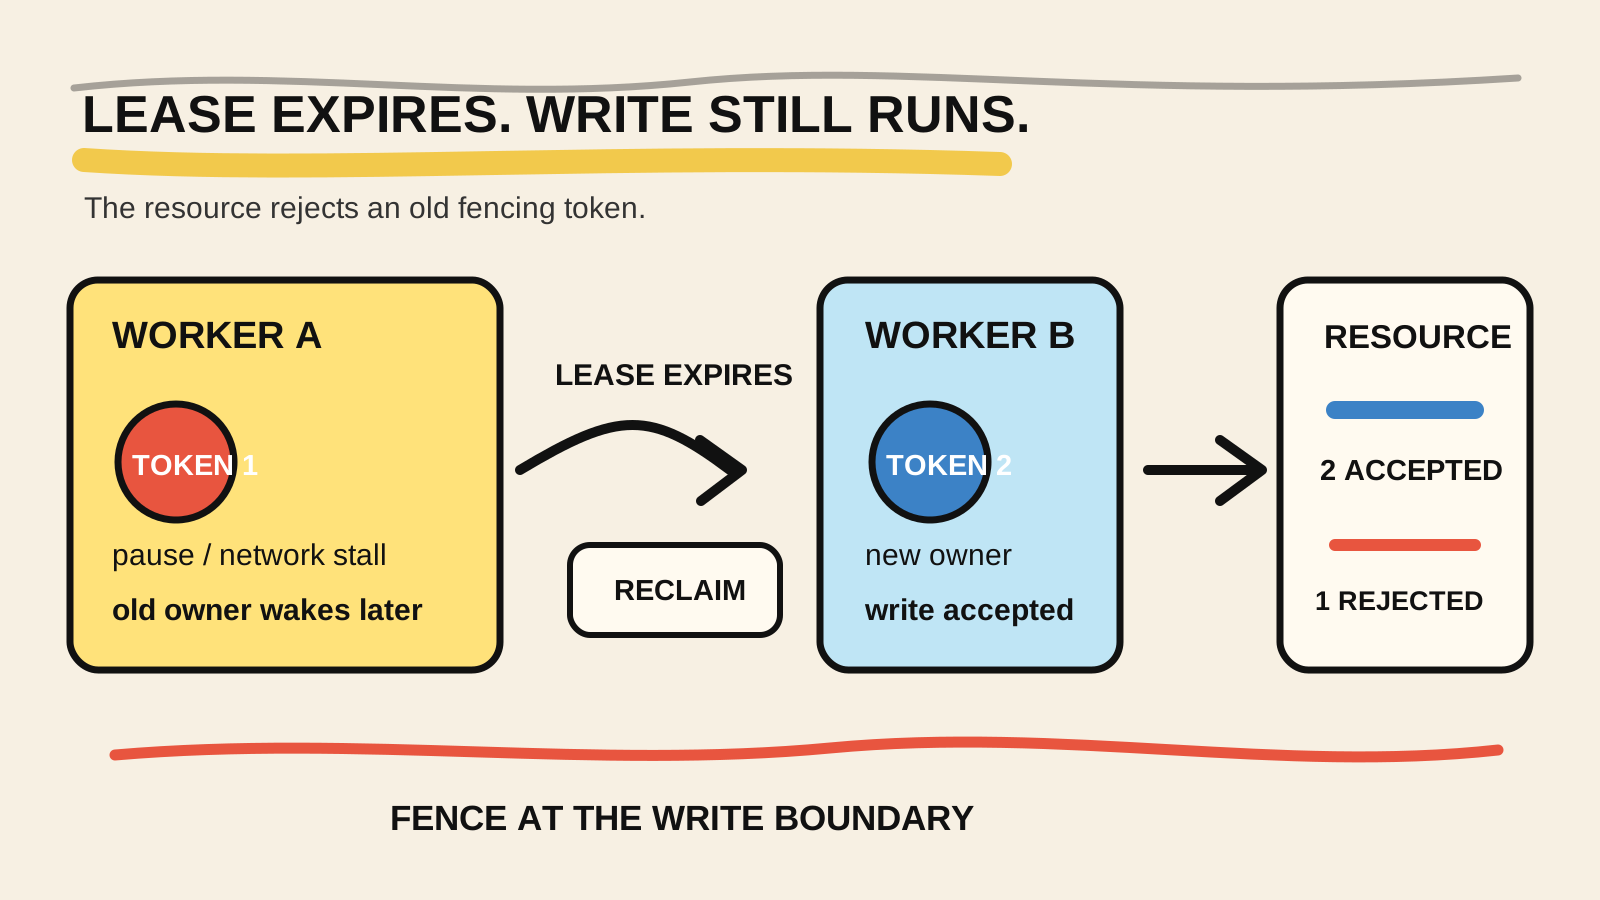
Un lease puede expirar mientras el worker que lo recibió está pausado. Cuando otro worker toma la tarea, el proceso antiguo todavía puede despertarse e intentar guardar el resultado que calculó antes del cambio de propiedad. Si el recurso acepta esa escritura porque el worker comprobó el lease un momento antes, la protección todavía tiene una carrera.
Los fencing tokens cierran esa carrera en la frontera correcta: la que acepta la mutación. Cada adquisición recibe una generación mayor. El worker lleva esa generación con la escritura, y la base de datos o el proxy de escritura rechaza cualquier token menor que el mayor token que ya aceptó. La guía para retomar un agente después de un crash cubre la recuperación más amplia. Aquí el foco está en impedir que un dueño antiguo escriba después de la recuperación.
Este artículo usa una fixture pequeña de Node.js para reproducir el orden de los eventos. Demuestra la regla del recurso en memoria. No es un lock distribuido, no mide latencia y no demuestra el comportamiento de un broker o una base de datos concreta.

Respuesta corta
- El lease decide quién debería trabajar ahora, pero no puede detener un proceso que ya está ejecutándose.
- La autoridad de propiedad debe emitir un token mayor en cada adquisición nueva.
- El recurso protegido debe comparar el token y la mutación de forma atómica.
- Un rechazo por token antiguo no debe convertirse en un retry automático con el mismo token.
¿Por qué no basta con comprobar el lease antes de escribir?
Imagina que el worker A recibe el lease de job-7 y empieza a calcular. Se pausa el tiempo suficiente para perder la renovación y el lease expira. El worker B toma la misma tarea y escribe un resultado nuevo. A vuelve a ejecutarse y consulta una variable local que todavía dice que es el dueño. Entre esa comprobación y la escritura, nada impide que el resultado antiguo sustituya al nuevo.
El problema no se limita al garbage collection. Un proceso puede suspenderse, perder CPU, perder la red o enviar una petición que llega tarde. El análisis de Martin Kleppmann sobre los locks distribuidos explica por qué comprobar la expiración antes de escribir no cierra la carrera y por qué el servicio que recibe la escritura debe rechazar los tokens antiguos.
La secuencia importante es esta:
| Momento | Worker | Token | Resultado |
|---|---|---|---|
| Empieza la tarea | A | 1 |
Puede trabajar mientras su propiedad sea válida |
| La pausa supera el lease | A | 1 |
El proceso puede seguir sin saber que perdió la propiedad |
| Se recupera la tarea | B | 2 |
B se convierte en el dueño más reciente |
| B escribe | B | 2 |
El recurso acepta la mutación |
| A despierta y escribe | A | 1 |
El recurso rechaza la mutación antigua |
Ese último paso separa "el worker debería detenerse" de "el recurso no aceptará una escritura antigua". Lo primero es una política de liveness. Lo segundo es la guarda de safety que sigue activa cuando un proceso no se detiene.
Separa lease, heartbeat y fencing token
Estos mecanismos suelen aparecer juntos, pero hacen trabajos distintos:
| Mecanismo | Pregunta que responde | Límite |
|---|---|---|
| Lease | ¿Quién puede intentar trabajar durante este intervalo? | Un proceso pausado puede no enterarse de que perdió la propiedad. |
| Heartbeat | ¿El worker todavía puede demostrar que está vivo? | Una renovación fallida no deshace una escritura ya enviada. |
| Fencing token | ¿Esta generación de propiedad todavía puede cambiar el recurso? | Solo protege la frontera que compara el token. |
El ejemplo de lock distribuido global de Microsoft para Azure Cosmos DB combina adquisición atómica, renovación con ETag, TTL para limpiar un lock abandonado y un token que aumenta de forma monótona y que otro sistema puede usar para rechazar a un dueño antiguo. La combinación es útil porque el TTL ayuda a recuperar la tarea y el token protege las escrituras posteriores.
No trates el heartbeat como autorización permanente. Ayuda al worker a detectar pronto que perdió la propiedad y a detener llamadas que cooperan con la cancelación. El recurso todavía tiene que comprobar la generación en una mutación que un worker antiguo no debe sobrescribir.
El recurso debe aplicar la regla del token
El token no sirve si aparece solo en los logs o en el contexto del worker. El destino de la escritura debe guardar la generación más alta aceptada y comparar el valor recibido en la misma operación que cambia el estado.
Una actualización SQL ilustrativa podría tener esta forma:
UPDATE job_results
SET result = $1,
    accepted_fence = $2,
    updated_at = now()
WHERE job_id = $3
  AND accepted_fence < $2;
Si la actualización afecta a cero filas, el executor debe tratarlo como stale_fencing_token, no como un error transitorio que merezca repetir la misma escritura. La columna necesita un valor inicial definido y todos los caminos que cambian el resultado necesitan la misma condición. Un script administrativo que ignore la comparación puede volver a abrir el fallo.
Cuando una secuencia de PostgreSQL crea el token, nextval devuelve valores distintos de forma atómica entre sesiones concurrentes, según la documentación de funciones de secuencia. La secuencia no es gapless, y eso no importa para fencing. Lo importante es que la generación nunca retroceda.
Para un servicio externo que no entiende el token, coloca la comprobación en un proxy o en un almacenamiento que registre la generación más alta antes de llamar al servicio. Si la llamada externa ya ocurrió, fencing no deshace el efecto. Todavía necesitas idempotencia, una consulta de estado o reconciliación.
Fixture de Node.js: el worker antiguo es rechazado
La fixture representa dos adquisiciones de la misma tarea. La segunda adquisición representa la recuperación del lease. El store acepta el token nuevo y rechaza el antiguo aunque el worker A todavía esté ejecutando código.
import assert from "node:assert/strict";

class FencingAuthority {
  #next = 0;

  acquire(resource) {
    this.#next += 1;
    return { resource, fence: this.#next };
  }
}

class FencedStore {
  #highestFence = new Map();
  #values = new Map();

  write(resource, value, fence) {
    const highest = this.#highestFence.get(resource) ?? 0;
    if (fence < highest) {
      throw new Error("stale_fencing_token");
    }

    this.#highestFence.set(resource, fence);
    this.#values.set(resource, value);
  }

  read(resource) {
    return this.#values.get(resource);
  }
}

const authority = new FencingAuthority();
const store = new FencedStore();

const workerA = authority.acquire("job-7");
const workerB = authority.acquire("job-7");

store.write(workerB.resource, "result-from-B", workerB.fence);

assert.throws(
  () => store.write(workerA.resource, "late-result-from-A", workerA.fence),
  /stale_fencing_token/,
);
assert.equal(store.read("job-7"), "result-from-B");

console.log("stale worker write rejected");
Guárdala como fencing-token-fixture.mjs y ejecútala con Node.js:
node fencing-token-fixture.mjsLa prueba comprueba la invariante local: después de que el recurso acepta el token 2, una escritura con token 1 no puede sustituir el valor. No comprueba la atomicidad de una base de datos, la emisión del token por un coordinador real, la renovación del lease ni ningún efecto fuera de este store. Esas fronteras necesitan pruebas de integración separadas.
¿Dónde encaja una cola de PostgreSQL?
Si las tareas ya viven en PostgreSQL, una transacción puede seleccionar una tarea disponible, registrar la propiedad y devolver la generación al worker. La documentación de SELECT de PostgreSQL describe SKIP LOCKED como una opción que puede reducir la contención en tablas usadas como colas, pero advierte que produce una vista inconsistente y no sirve para consultas generales.
Eso resuelve la competencia para reclamar un elemento de la cola. No resuelve por sí solo que un worker calcule durante mucho tiempo y vuelva después de perder la propiedad. El resultado final todavía tiene que llevar la generación y usar una actualización condicional. Si varios procesos pueden competir por el mismo run, el artículo sobre ejecución durable con colas y workflows ayuda a separar colas, checkpoints y workflows.
Ordena la reclamación de forma explícita cuando importen la prioridad o la equidad. SKIP LOCKED no convierte una tabla en un scheduler justo, y un lock de fila no permite que la aplicación ignore la versión de la tarea.
¿Cómo debe reaccionar el runtime a stale_fencing_token?
El rechazo del recurso informa sobre la propiedad, no invita a repetir la misma operación. El executor puede seguir este camino:
- Detén el paso actual y no repitas la escritura con el token antiguo.
- Registra
runId,jobId, el token presentado, el token aceptado y la frontera que rechazó la mutación. - Si hubo una llamada externa antes del rechazo, consulta el efecto por una clave estable o marca el resultado como desconocido.
- Deja que el worker nuevo vuelva a leer el estado y decida si continúa, reconcilia o se detiene.
- Emite una señal operativa que diferencie la pérdida de propiedad de un fallo de la dependencia.
La prueba de un worker de cola después de perder el ack cubre otra ventana: el efecto se aplicó, pero falló la confirmación de entrega. Aquí la ventana es la propiedad de la tarea. En ambos casos hay que observar el efecto real, no solo el número de llamadas.
Errores que dejan el fencing como decoración
Comprobar y escribir en operaciones separadas
Un if (token === currentToken) seguido de otro comando todavía permite que la propiedad cambie entre las dos operaciones. La comparación y la mutación deben compartir una transacción o la operación condicional que el recurso realmente garantiza.
Guardar el token solo en memoria
Si el proceso que protege el recurso se reinicia y olvida la generación más alta aceptada, un worker antiguo puede parecer válido otra vez. Persiste el high-water mark o usa un mecanismo cuyo orden sobreviva al reinicio.
Reiniciar la secuencia de tokens
Un token es una generación de propiedad, no un contador de intentos que puede volver a cero después de una limpieza. Si necesitas reiniciar el orden, trátalo como un cambio de protocolo y conserva una barrera que impida que los tokens antiguos vuelvan a ser válidos.
Confundir cancelación con fencing
Un AbortSignal puede interrumpir una operación que coopera con él. No cancela una petición que ya llegó al servidor ni evita que una respuesta retrasada llegue a su destino. Fencing sigue siendo necesario en la frontera que acepta el estado.
Prometer exactly-once para varios sistemas
Fencing puede impedir que una generación antigua actualice un recurso protegido. No convierte en atómicas las transacciones entre una base de datos, un broker y una API externa. Para esas fronteras, combina idempotencia, outbox, compensación o reconciliación según el efecto que necesites proteger.
Checklist antes de liberar el worker
- [ ] Cada adquisición recibe una generación nueva que nunca retrocede.
- [ ] El token viaja con la mutación hasta el recurso que puede aceptar o rechazar la escritura.
- [ ] La comparación del token y el cambio de estado son atómicos en la frontera protegida.
- [ ] El camino del token antiguo termina sin retry automático con la misma generación.
- [ ] Heartbeats y cancelación ayudan a la liveness, pero no son la única defensa de safety.
- [ ] El sistema registra la pérdida de propiedad y permite investigar la generación ganadora.
- [ ] Los efectos externos tienen una clave de idempotencia, una consulta de estado o un camino explícito de reconciliación.
- [ ] La fixture fuerza un cambio de propiedad y confirma el rechazo de la escritura antigua.
Método y límites
Samuel Fajreldines es el autor responsable de este texto. La investigación combinó el análisis de locks distribuidos de Martin Kleppmann, el ejemplo actual de lock distribuido de Microsoft y la documentación de PostgreSQL sobre locks de fila, SKIP LOCKED y secuencias. Las discusiones públicas solo sirvieron para reconocer términos y fallos que describen los practicantes. Escribí la fixture para este artículo y la ejecuté localmente con Node.js v25.5.0. Usa estado en memoria, por lo que no mide recuperación distribuida, no prueba un broker y no demuestra exactly-once en producción.
Usé asistencia de IA para organizar las fuentes, revisar el texto y producir las localizaciones. No ejecutó un worker de producción ni aportó experiencia operativa. Cuando necesito continuidad entre sesiones largas de Codex y Claude Code, uso RemoteCode, una herramienta mía. Eso no sustituye un journal, un lease, fencing ni la reconciliación.
Conclusión
Los leases y los heartbeats ayudan a recuperar una tarea y apartar a un worker detenido. No garantizan que el proceso antiguo se haya detenido. La protección decisiva está en el recurso: acepta la mutación con un token de propiedad y rechaza cualquier generación menor que la última aceptada.
Este diseño no promete exactly-once para todo el sistema. Responde una pregunta más concreta y útil: ¿un worker que perdió la propiedad todavía puede sobrescribir el estado protegido? Si la respuesta es sí, el lease es solo una convención. Si la respuesta es no, la frontera de escritura está aplicando fencing.
Fuentes consultadas
- Martin Kleppmann, "How to do distributed locking", consultado el 21/11/2026.
- Microsoft Learn, "Azure Cosmos DB design pattern: Global Distributed Lock", consultado el 21/11/2026.
- PostgreSQL, "SELECT", consultado el 21/11/2026.
- PostgreSQL, "Sequence Manipulation Functions", consultado el 21/11/2026.