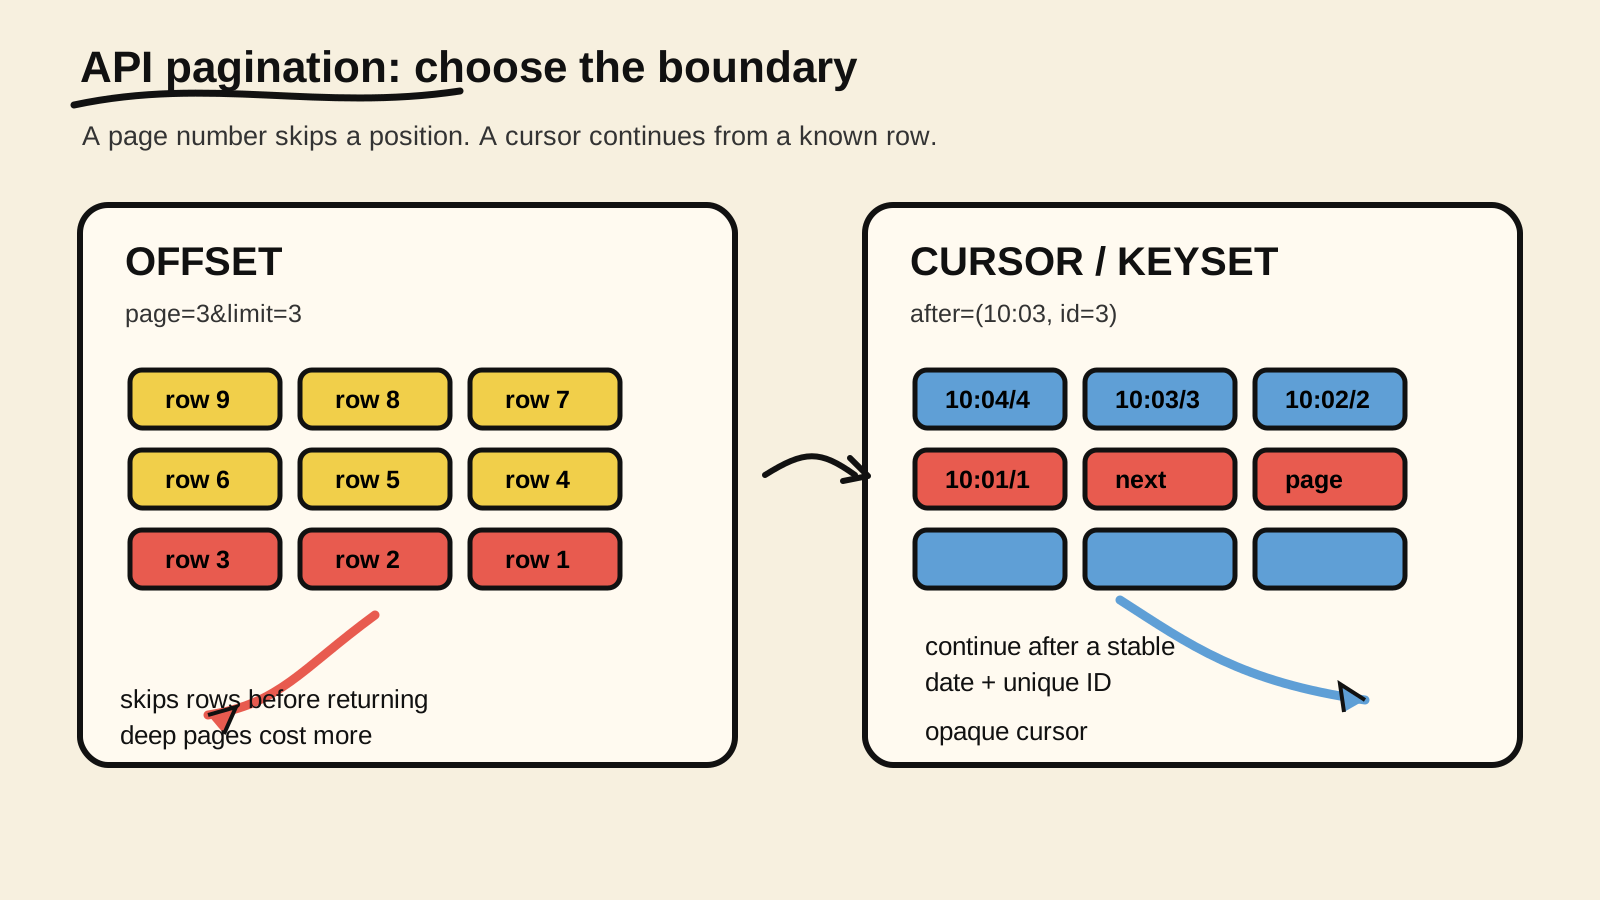
La elección entre OFFSET y un cursor depende de cómo recorre la lista el cliente. Si necesita abrir la página 37, offset es sencillo y directo. Si necesita obtener la siguiente parte de un feed, exportar registros o sincronizar una tabla que sigue cambiando, un cursor basado en la ordenación suele proteger mejor la continuidad.
No existe una opción universalmente mejor. OFFSET expresa una posición numérica. Un cursor, también llamado keyset o seek pagination, expresa una posición relativa al último registro recibido. La decisión es segura cuando la API mantiene la misma ordenación, usa un desempate único y trata el cursor como un contrato opaco.
Esta página completa la guía de una API GraphQL escalable con Node.js. Esa guía menciona la paginación por cursor como una decisión de rendimiento, pero no cubre el contrato entre endpoint, base de datos y cliente. Aquí la pregunta es más concreta: ¿qué modelo debes elegir y cómo evitas que una lista cambiante repita o se salte registros?
Respuesta breve
- Usa
OFFSETpara listas pequeñas o estables y para interfaces que necesitan saltar a una página concreta.- Usa un cursor para feeds, exportaciones, sincronizaciones y listas que cambian mientras se leen.
- Ordena por una clave única, como
(created_at, id), no solo por una fecha que puede empatar.- Genera cursores opacos en el servidor y vincúlalos al filtro, la ordenación y la versión del contrato.
- Prueba la paginación con inserciones y borrados entre solicitudes. Una página corta no demuestra que la lista terminó.
La diferencia práctica entre offset y cursor
Con paginación por offset, el cliente pide algo como page=3&limit=20 y el servidor lo convierte en OFFSET 40 LIMIT 20. La base de datos tiene que considerar los primeros 40 registros antes de devolver los siguientes 20. PostgreSQL documenta que las filas que OFFSET omite todavía tienen que calcularse y que un offset grande puede ser ineficiente (PostgreSQL, "LIMIT and OFFSET").
Con paginación por cursor, el cliente envía la posición recibida en la página anterior:
GET /posts?limit=20&after=eyJ2IjoxLCJjcmVhdGVkQXQiOiIyMDI2LTExLTA3VDEwOjAwOjAwWiIsImlkIjo0MjF9El servidor traduce ese cursor a una condición de ordenación. Para una lista ordenada por fecha e ID de forma descendente, la consulta puede ser:
CREATE INDEX posts_feed_order_idx
  ON posts (created_at DESC, id DESC);

SELECT id, title, created_at
FROM posts
WHERE (created_at, id) < ($1::timestamptz, $2::bigint)
ORDER BY created_at DESC, id DESC
LIMIT $3;
El operador < no es una regla universal. Corresponde a esta ordenación descendente. Si la consulta es ascendente, la condición y el índice deben seguir esa dirección. La idea es sustituir "salta N filas" por "continúa después de esta posición ordenada".
¿Cuándo es correcta la opción offset?
Offset sigue siendo una buena opción cuando el caso de uso necesita acceso aleatorio y la colección es pequeña o cambia poco. Una tabla administrativa que permite ir directamente a la página 10 puede preferir page y limit, porque el número de página forma parte de la interfaz y el total puede ser útil.
Usa offset cuando se cumplan estas condiciones:
| Señal del producto | Por qué puede encajar offset |
|---|---|
| Las personas necesitan saltar a una página concreta | La posición numérica forma parte de la navegación |
| La lista es pequeña o es un informe cerrado | El coste de saltar filas es limitado |
| El resultado se mantiene estable durante la lectura | Los cambios entre páginas no desplazan la ventana |
Ya hay clientes que dependen de page |
La compatibilidad puede valer más que migrar de inmediato |
Incluso en este caso, define ORDER BY con una ordenación única. PostgreSQL advierte que LIMIT sin un orden predecible puede devolver subconjuntos inconsistentes, porque SQL no promete un orden implícito. Offset no crea una ordenación: solo salta una parte del resultado ordenado.
¿Cuándo es mejor un cursor?
Un cursor es más fuerte cuando el cliente recorre la lista hacia delante o hacia atrás y no necesita acceso aleatorio por número de página. Microsoft Learn describe keyset pagination como una alternativa que usa los valores del último registro en una cláusula WHERE. La misma documentación señala dos límites importantes: keyset no permite saltos arbitrarios y necesita una ordenación completamente única.
Los casos habituales son feeds, historiales de eventos, exportaciones, sincronizaciones incrementales y workers que reanudan una lectura. La pregunta no es "¿cuál es la página 37?". Es "¿qué registro viene después del último que confirmé?". Si la tabla recibe una inserción mientras el cliente trabaja, el cursor continúa comparando con la posición recibida, mientras que un offset puede desplazar la ventana.
El cursor también permite que una API cambie la implementación de su base de datos sin exponer detalles internos a los clientes. La guía de paginación de GraphQL recomienda cursores opacos y señala que un cursor puede ocultar si la implementación usa un ID, un offset u otra representación. La opacidad no resuelve la consistencia por sí sola, pero evita que el cliente dependa del formato interno.
La ordenación debe ser única
El error más común en un cursor es ordenar solo por created_at. Dos registros pueden compartir el mismo timestamp. Si el cursor guarda únicamente ese valor, la siguiente consulta no puede separar con fiabilidad el registro ya visto del que todavía debe aparecer.
Usa una clave compuesta que termine en un campo único:
SELECT id, created_at, title
FROM posts
WHERE (created_at, id) < ($1::timestamptz, $2::bigint)
ORDER BY created_at DESC, id DESC
LIMIT 20;
El par (created_at, id) define un orden total para el conjunto. La documentación de paginación de EF Core usa la misma idea al combinar fecha e ID, y el perfil de cursor de JSON:API exige que el servidor añada restricciones hasta producir un orden único (JSON:API, "Cursor Pagination").
El índice debe seguir la consulta. Si no, cambiar offset por una cláusula WHERE más compleja puede limitarse a mover el coste. Comprueba con EXPLAIN (ANALYZE, BUFFERS) contra la base de datos y el volumen real del endpoint. Esta página no ofrece un benchmark de una base de datos concreta.
Un cursor es un contrato de la API, no un ID expuesto
Un cursor puede contener la versión del contrato, los valores de ordenación y una huella de los filtros usados en la primera solicitud:
type PostCursor = {
  v: 1;
  sort: "created_at_desc_id_desc";
  createdAt: string;
  id: number;
  filterHash: string;
};

export function encodeCursor(cursor: PostCursor): string {
  return Buffer.from(JSON.stringify(cursor)).toString("base64url");
}

export function decodeCursor(value: string): PostCursor {
  let parsed: unknown;

  try {
    parsed = JSON.parse(Buffer.from(value, "base64url").toString("utf8"));
  } catch {
    throw new Error("cursor no válido");
  }

  if (
    !parsed ||
    typeof parsed !== "object" ||
    (parsed as Record<string, unknown>).v !== 1 ||
    (parsed as Record<string, unknown>).sort !== "created_at_desc_id_desc" ||
    typeof (parsed as Record<string, unknown>).createdAt !== "string" ||
    !Number.isSafeInteger((parsed as Record<string, unknown>).id) ||
    typeof (parsed as Record<string, unknown>).filterHash !== "string"
  ) {
    throw new Error("cursor incompatible");
  }

  return parsed as PostCursor;
}
El ejemplo es ilustrativo. Todavía necesita validación de fecha, tamaño máximo, firma u otra protección adecuada al riesgo del endpoint. No trates el id del cursor como autorización. Es solo una posición; la consulta debe aplicar también tenant, permisos y filtros actuales.
El hash de filtros evita que un cliente use el cursor de status=published en una solicitud para status=draft. Otra opción es rechazar de forma explícita los filtros incompatibles. Cuando cambie la ordenación, incrementa la versión del cursor en vez de interpretar en silencio el formato anterior.
Prueba la ventana entre dos páginas
Una implementación no está validada porque dos solicitudes consecutivas devolvieron los registros esperados. Inserta y borra registros entre solicitudes, y comprueba la propiedad que necesita el producto: ningún duplicado, ningún salto o, como mínimo, ningún efecto repetido en una exportación.
Esta fixture de JavaScript ejecuta la regla central sin depender de una base de datos. Usa la misma ordenación (createdAt, id) que el SQL:
import test from "node:test";
import assert from "node:assert/strict";

function compareDesc(a, b) {
  return b.createdAt.localeCompare(a.createdAt) || b.id - a.id;
}

function pageAfter(rows, cursor, limit) {
  const ordered = [...rows].sort(compareDesc);
  const start = cursor
    ? ordered.findIndex(
        (row) =>
          row.createdAt === cursor.createdAt && row.id === cursor.id,
      ) + 1
    : 0;
  const items = ordered.slice(start, start + limit);
  const last = items.at(-1);

  return {
    items,
    nextCursor: last
      ? { createdAt: last.createdAt, id: last.id }
      : null,
  };
}

test("does not repeat a row when a newer row arrives", () => {
  const rows = [
    { id: 4, createdAt: "2026-11-07T10:04:00.000Z" },
    { id: 3, createdAt: "2026-11-07T10:03:00.000Z" },
    { id: 2, createdAt: "2026-11-07T10:02:00.000Z" },
    { id: 1, createdAt: "2026-11-07T10:01:00.000Z" },
  ];

  const first = pageAfter(rows, null, 2);
  const second = pageAfter(
    [...rows, { id: 5, createdAt: "2026-11-07T10:05:00.000Z" }],
    first.nextCursor,
    2,
  );

  assert.deepEqual(first.items.map((row) => row.id), [4, 3]);
  assert.deepEqual(second.items.map((row) => row.id), [2, 1]);
});
Guarda el bloque como pagination.test.mjs y ejecuta node --test pagination.test.mjs. La prueba demuestra la propiedad de ordenación en memoria, no la ejecución de PostgreSQL, la concurrencia de transacciones ni la garantía de un proveedor. Para una prueba de integración, ejecuta la misma matriz contra la base de datos y el endpoint reales.
Fallos que aparecen después del primer despliegue
Algunos problemas sobreviven a una demo feliz:
- Timestamp sin desempate: dos filas con la misma precisión visible pueden caer alrededor del cursor de forma ambigua. Guarda también una clave única y conserva su precisión en el cursor.
- Filtro u ordenación cambiados: un cursor solo es válido para la consulta que lo produjo. Rechaza la incompatibilidad en vez de devolver una página que parece correcta.
- Cursor creado por el cliente: base64 no es una firma. Si el cursor contiene tenant, filtro o permisos, valida su integridad y vuelve a comprobar la autorización en el servidor.
- Inferir el final por una página corta: filtros, límites del proveedor y lecturas concurrentes pueden devolver menos registros sin que la lista haya terminado. Prefiere un
hasMoreonextCursor: nulldefinido por el servidor. - Contar cada respuesta:
COUNT(*)puede costar más que leer la página. Inclúyelo solo si la interfaz lo necesita. - Borrado entre páginas: el cursor debe seguir representando una posición aunque se haya borrado el registro que lo originó. No dependas de consultar esa fila antes de continuar.
Si el producto necesita una instantánea consistente de una colección, un cursor normal no basta. Necesitas una estrategia de snapshot, una ventana versionada o un mecanismo de exportación propio. El perfil de cursor de JSON:API permite que el servidor codifique una identidad de sesión cuando la lista no puede cambiar entre solicitudes, pero eso añade su propio coste de retención y operación.
Checklist para decidir
Antes de publicar el endpoint, responde:
- ¿El cliente necesita saltar a cualquier página o solo avanzar y retroceder?
- ¿La colección cambia mientras el cliente la lee?
- ¿La ordenación termina en una clave única e indexada?
- ¿El cursor conserva versión, filtro y dirección sin exponer detalles que el cliente pueda editar?
- ¿La respuesta indica de forma fiable si existe otra página?
- ¿El fixture fuerza inserciones, borrados, empates de timestamp, cursores inválidos y filtros cambiados?
Si las respuestas apuntan a una navegación secuencial sobre una lista cambiante, empieza con cursor/keyset pagination. Si el requisito principal es el acceso aleatorio a una lista pequeña y estable, offset puede ser la interfaz más sencilla. En ambos casos, la ordenación única y las pruebas de cambios entre páginas importan más que el nombre del parámetro.
Esta página es una síntesis técnica con ejemplos locales, no un benchmark. La prueba de JavaScript se ejecutó con node --test; el SQL debe comprobarse contra la versión de tu base de datos, el plan de índices y la política de consistencia del servicio. Para una prueba relacionada sobre datos que llegan fuera de orden, consulta las pruebas de consistencia eventual sin sleeps fijos. Para una API que debe reanudar una exportación después de un fallo, la ejecución durable con colas y checkpoints ayuda a separar la posición confirmada del trabajo pendiente.
Fuentes consultadas
- PostgreSQL, "LIMIT and OFFSET", consultado el 2026-11-07.
- Microsoft Learn, "Pagination", consultado el 2026-11-07.
- GraphQL, "Pagination", consultado el 2026-11-07.
- JSON:API, "Cursor Pagination Profile", consultado el 2026-11-07.
- Zendesk Developer Docs, "Comparing cursor pagination and offset pagination", consultado el 2026-11-07.