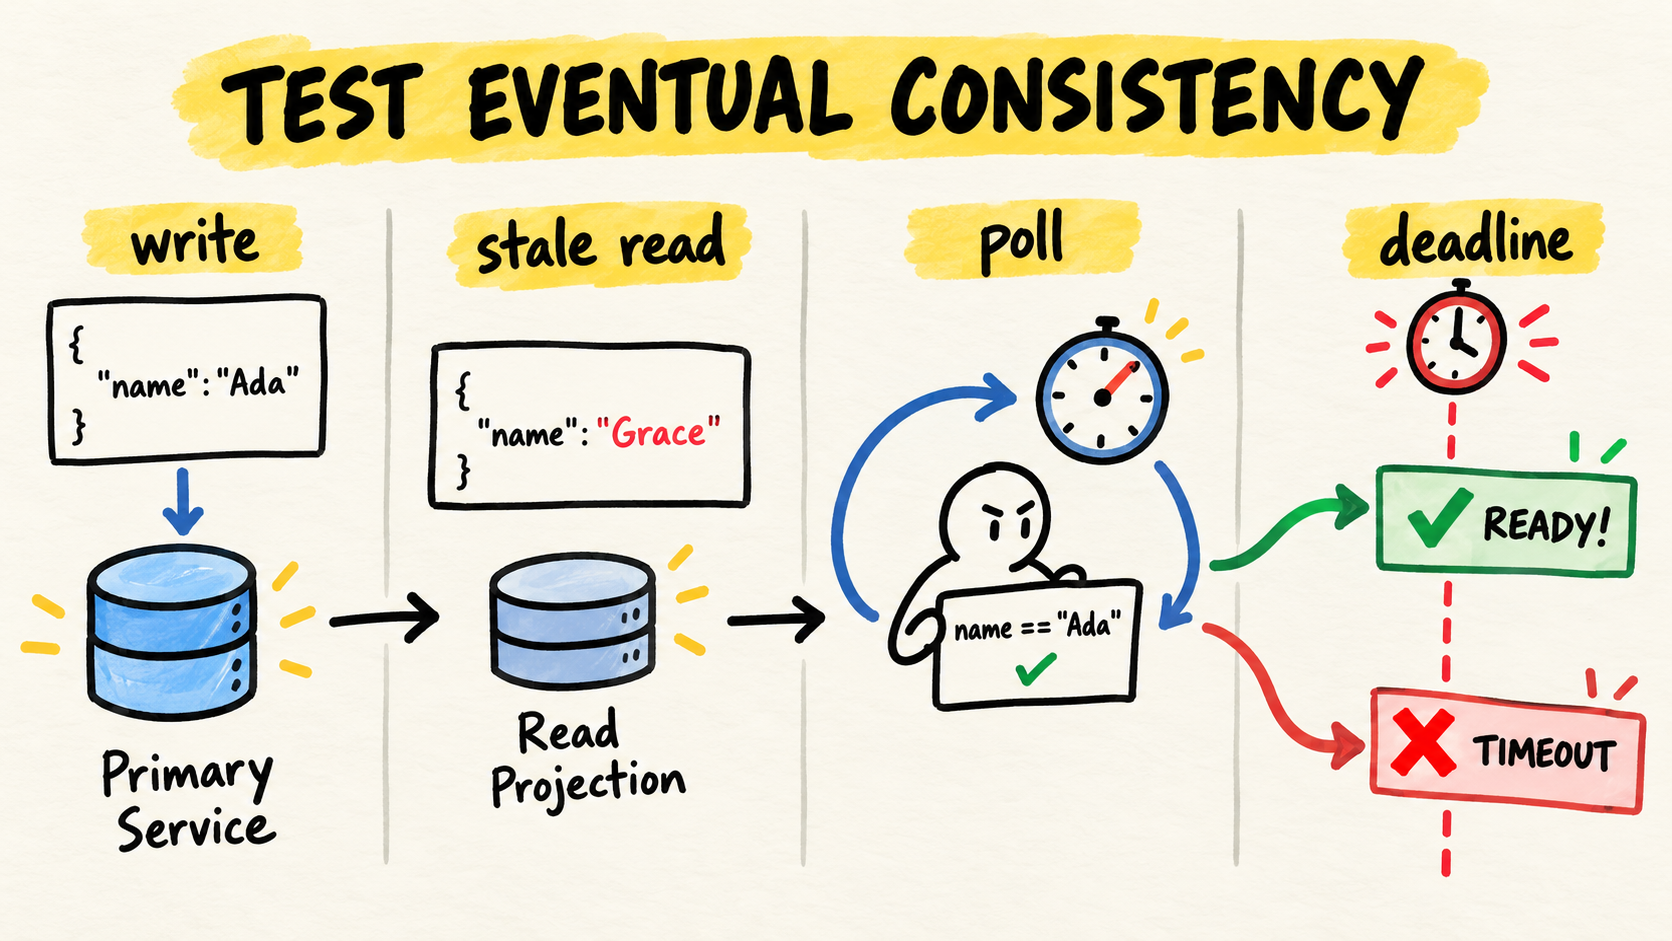
Una API acepta una escritura, pero la consulta siguiente todavía muestra el estado anterior. Puede ser normal cuando la lectura pasa por una réplica, un índice de búsqueda, una caché o una proyección actualizada por eventos. La prueba se vuelve inestable cuando trata esa ventana como un retraso fijo.
Para probar la consistencia eventual, define qué inicia la propagación, qué lectura debe reflejar el cambio, qué condición demuestra que llegó y cuál es el límite total. Después haz polling de esa condición. La prueba debe detenerse cuando aparece el estado correcto y dejar de reintentar cuando el fallo no es transitorio.
Es una cuestión sobre la frontera de la prueba. La comparación de pruebas unitarias y de integración en Node.js ayuda a decidir qué componentes deben mantenerse reales. Aquí la prueba atraviesa la ruta de lectura que usará un usuario u otro servicio.

Respuesta breve
- Registra la escritura, la lectura observada, la condición de éxito y el plazo total.
- Usa polling con límite, no un
sleepfijo que reinicia el reloj en cada intento.- Trata los estados transitorios como transitorios y los errores de autorización o validación como fallos inmediatos.
- Conserva las últimas observaciones cuando termina el plazo.
- Observa toda la ventana cuando el requisito es que algo no aparezca.
¿Qué debe demostrar la prueba?
La prueba no necesita demostrar que dos lecturas ocurren al mismo tiempo. Debe demostrar que el cambio se vuelve visible por la ruta que promete el contrato público, dentro de una ventana conocida. Antes de escribir código, nombra cuatro elementos: disparador, observación, predicado y plazo.
- Disparador: la escritura o el comando que inicia la propagación.
- Observación: el endpoint, la consulta, el índice o la pantalla que usará el consumidor.
- Predicado: el estado que significa que llegó el cambio, como un ID, una versión o un estado.
- Plazo: el tiempo máximo aceptable para que aparezca esa condición.
Un 200 no basta. Una respuesta correcta puede seguir conteniendo una versión antigua. El predicado debe comparar el valor producido por la escritura. Si el flujo usa versiones, comprueba también la versión esperada. Si usa estados, enumera los estados intermedios permitidos.
Por ejemplo, DynamoDB read consistency explica que una lectura eventualmente consistente puede no reflejar de inmediato una escritura completada. La misma documentación describe cuándo se puede pedir una lectura fuerte y cuándo un índice secundario global sigue siendo eventualmente consistente. Tu prueba debe seguir ese límite del proveedor, no una suposición genérica.
¿Por qué un sleep fijo produce una mala prueba?
Un sleep(1000) no verifica el estado. Hace una apuesta sobre el tiempo. Si la proyección está lista en 50 milisegundos, cada ejecución sigue pagando el segundo completo. Si necesita más tiempo bajo carga, la misma prueba falla aunque la ventana documentada de consistencia todavía no haya terminado.
El problema también aparece cuando cada intento reinicia el reloj. Un helper que espera un segundo después de cada lectura fallida puede seguir activo mucho más de lo que su autor esperaba. Calcula el plazo una sola vez y haz que cada solicitud consuma el mismo presupuesto.
La documentación de Assertions de Playwright recomienda reintentar aserciones para interfaces asíncronas y documenta expect.poll para repetir una función hasta que pase el matcher o se agote el timeout. Eso no convierte cualquier error en un retraso aceptable. La función todavía debe clasificar las respuestas.
La guía para probar APIs eventualmente consistentes con polling, consultada el 13/10/2026, hace la misma separación entre estados esperados, un plazo total y fallos terminales. Es una síntesis práctica, no la definición del contrato de tu sistema.
¿Cómo usar expect.poll en Playwright?
Usa expect.poll cuando lo que necesitas repetir es una lectura asíncrona y el matcher final puede expresar la convergencia. El ejemplo siguiente es ilustrativo: sustituye la ruta, el estado y la clasificación de 404 por el contrato de tu API.
import { test, expect } from "@playwright/test";

test("la proyección se vuelve visible después de escribir", async ({ request }) => {
  const create = await request.post("/orders", {
    data: { reference: "order-for-test" },
  });
  expect(create.ok()).toBeTruthy();

  const { id, version } = await create.json();

  await expect.poll(
    async () => {
      const response = await request.get(`/order-search/${id}`);

      // En este contrato, 404 significa "todavía no está indexado".
      if (response.status() === 404) {
        return { state: "not_visible" };
      }

      // Para esta API, estos estados quedan fuera de la propagación normal.
      if ([401, 403, 422].includes(response.status())) {
        throw new Error(`fallo terminal: ${response.status()}`);
      }

      if (!response.ok()) {
        throw new Error(`falló el endpoint de lectura: ${response.status()}`);
      }

      const body = await response.json();
      return { state: body.state, version: body.version };
    },
    {
      intervals: [100, 250, 500, 1_000],
      timeout: 10_000,
      message: "la proyección debe converger dentro del contrato",
    },
  ).toEqual({ state: "ready", version });
});
El código no espera hasta el final cuando aparece la versión correcta. Tampoco convierte una respuesta de autorización en otro intento. Los intervalos y el timeout son valores de ejemplo, no garantías universales. Derívalos del objetivo del servicio y de la carga que puede generar tu suite.
Esta prueba demuestra una lectura de proyección. No demuestra que todo el sistema sea rápido ni que todas las réplicas hayan convergido. Esa diferencia evita que una aserción funcional se convierta accidentalmente en un benchmark.
¿Cómo separar un retraso esperado de un fallo real?
Clasifica la observación antes de elegir el intervalo. Un registro ausente puede ser transitorio en un índice recién actualizado. El mismo 404 puede ser permanente en un endpoint que debería leer el registro primario. Los códigos HTTP ayudan, pero el contrato del recurso decide.
Una clasificación útil puede incluir not_visible, indexing, ready y failed. La prueba puede continuar con not_visible e indexing, detenerse con ready y fallar con failed. Para una respuesta como 503, decide explícitamente entre una política de retry y un fallo inmediato. No ocultes un incidente repitiendo cualquier estado hasta el timeout.
Conserva una observación compacta por intento: tiempo relativo, estado HTTP, estado del recurso, versión, ID de correlación y un mensaje sanitizado. No registres tokens, cuerpos sensibles ni datos personales. Cuando termine el plazo, el error debe mostrar la última condición observada, no solo "timeout".
Esto también separa el problema de probar la lógica de reintentos en JavaScript sin esperar. Una prueba de retry comprueba cuándo se vuelve a hacer una llamada. Una prueba de consistencia eventual comprueba cuándo el efecto de una escritura se vuelve visible a través de otra lectura. Un flujo puede necesitar ambas, pero responden preguntas distintas.
¿Cómo probar estados intermedios y versiones?
La consistencia eventual no significa que cualquier secuencia sea válida antes de converger. Si un recurso debe pasar de queued a indexing y después a ready, la prueba debe rechazar que vuelva de ready a queued cuando la API promete progreso monótono.
Una forma sencilla de expresar esta regla es conservar el último estado permitido y revisar cada observación nueva. Para versiones numéricas, rechaza una versión menor que la anterior. Para estados sin un orden total, enumera las transiciones permitidas en vez de comparar strings por accidente.
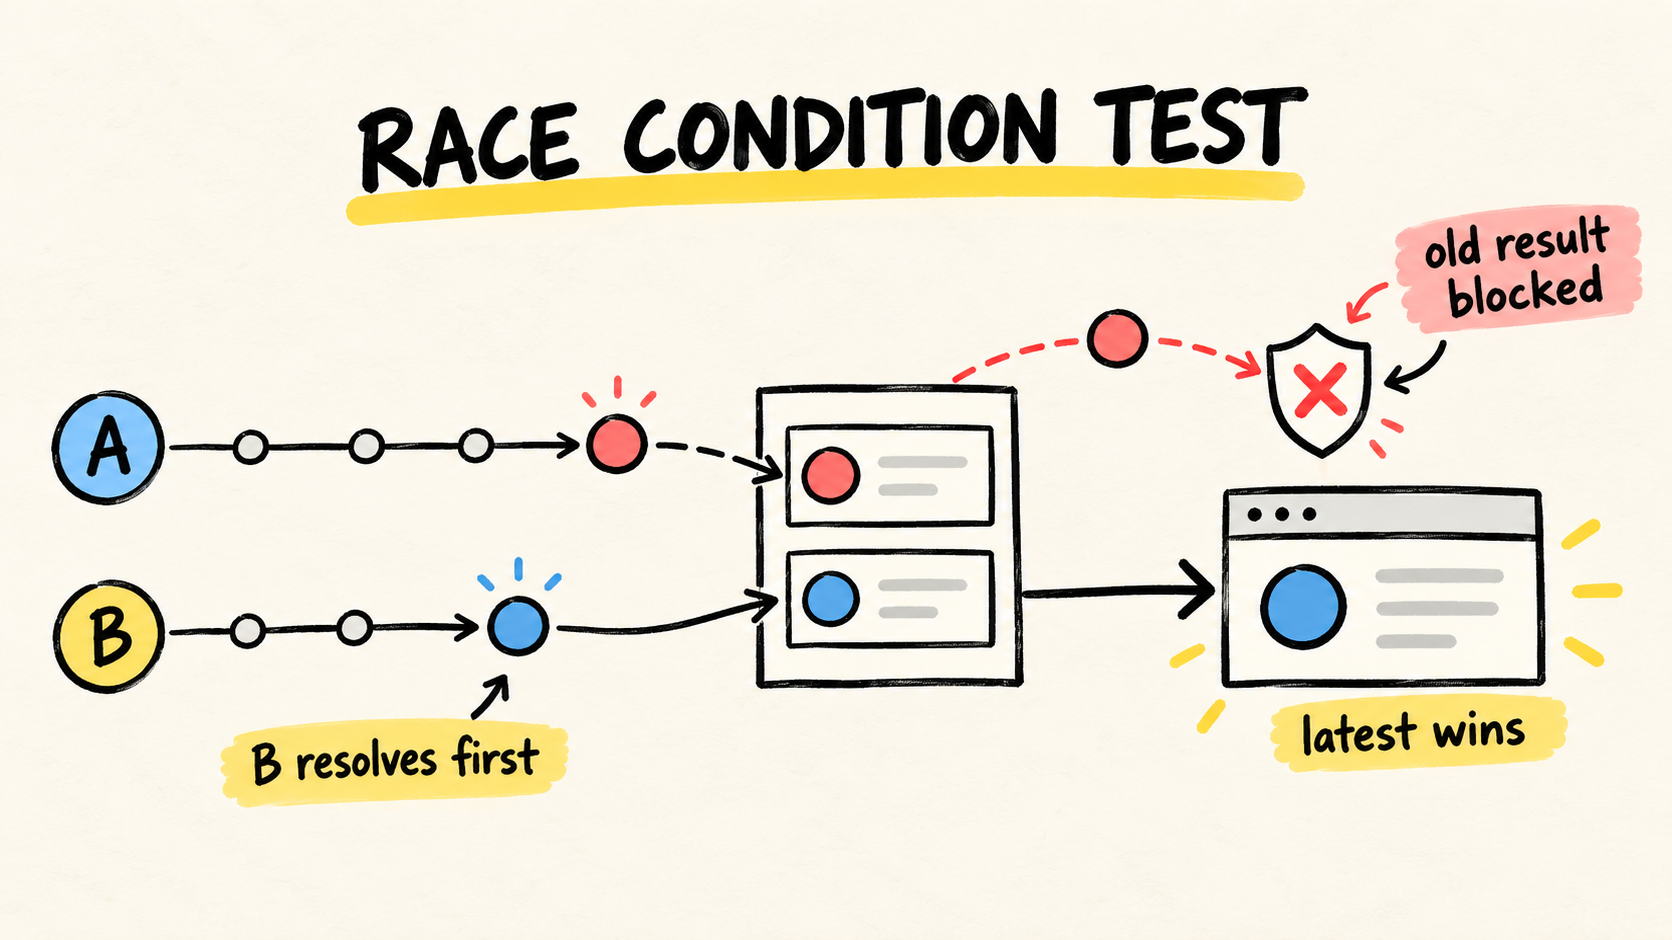
Si la inestabilidad viene de dos operaciones locales que compiten por el mismo recurso, la frontera es distinta. La fixture para probar condiciones de carrera en JavaScript asíncrono ayuda a controlar el orden de las operaciones. El polling de este artículo sirve cuando el orden interno ya terminó, pero el resultado todavía no es visible por la ruta de lectura.
¿Cómo probar que un estado prohibido nunca aparece?
Una aserción positiva puede detenerse en la primera lectura correcta. Una aserción negativa necesita observar toda la ventana. Ver una vez que un recurso no existe no demuestra que no aparecerá después de que una cola o un índice procese el evento.
Para pruebas de revocación, eliminación o aislamiento entre tenants, define una ventana de observación y falla en cuanto aparezca el estado prohibido. Declara el éxito solo cuando pase la ventana completa. Si el sistema ofrece una comprobación determinista de autorización, prefiere esa prueba a consultar repetidamente una proyección retrasada.
No reutilices el timeout de la aserción positiva solo por comodidad. "¿Aparecerá el registro?" y "¿nunca será visible?" tienen riesgos diferentes. La primera puede terminar pronto. La segunda debe completar el periodo que cubre realmente el contrato.
¿Cuándo no es el mejor test hacer polling?
Usa una lectura fuerte cuando la pregunta sea solamente si la escritura se persistió y el proveedor ofrezca esa garantía en la ruta elegida. En DynamoDB, por ejemplo, los índices secundarios globales no admiten la misma opción de lectura fuerte documentada para tablas e índices secundarios locales. Cambiar la consulta puede cambiar el objeto de la prueba.
Usa un evento, webhook o suscripción a una cola cuando ese sea el contrato público del consumidor. La prueba debe comprobar correlación, duplicados y preparación del suscriptor. Después del evento, todavía puede tener sentido consultar la ruta pública de lectura para comprobar el estado que verá el usuario.
Por último, no uses una prueba funcional de convergencia para medir percentiles de latencia. Demuestra si la condición apareció dentro de un límite. Una prueba de rendimiento necesita controlar por separado la carga, la concurrencia y la recopilación de duración. Mezclar las preguntas produce un timeout difícil de interpretar.
Checklist para llevar la prueba al CI
Antes de añadirla al recorrido principal, comprueba que:
- la escritura produce un identificador o versión que la lectura puede encontrar;
- la consulta usa la misma ruta que usa un consumidor real;
- el predicado comprueba el valor correcto, no solo
200; - las respuestas transitorias están enumeradas y los fallos terminales terminan pronto;
- existe un único deadline, sin renovarlo en cada intento;
- las observaciones finales están sanitizadas y sirven para diagnosticar;
- los estados prohibidos y las regresiones de versión tienen aserciones propias;
- la ventana de una aserción negativa aparece escrita en el requisito;
- el polling no está reemplazando una prueba de eventos ni una prueba de carga;
- la suite se ejecuta con datos aislados y limpieza conocida.
El objetivo no es hacer que la prueba espere más. Es hacer que la espera represente el contrato que el sistema ofrece. Cuando la lectura converge, la prueba termina. Cuando no converge, el fallo conserva suficiente evidencia para investigar si el defecto está en la escritura, la propagación o la lectura.
Preguntas frecuentes
¿Puedo usar sleep en una prueba de consistencia eventual?
Un sleep corto puede formar parte de una fixture controlada, pero no debe ser la prueba principal de convergencia. Playwright documenta expect.poll con timeout e intervalos configurables. Usa una condición observable y un único plazo total para que la prueba termine pronto cuando aparezca el estado correcto.
¿Debo reintentar cualquier error hasta que termine el timeout?
No. Reintenta solo los estados que el contrato clasifica como transitorios. Los fallos de autenticación, autorización, validación o schema deben terminar pronto. Una respuesta del servidor puede ser retryable en un sistema y terminal en otro, por lo que la clasificación debe estar junto a la prueba.
¿Cómo elijo el timeout?
Empieza por el objetivo de propagación que promete el sistema, no por un número cómodo para el CI. Usa un deadline total, registra la última observación e investiga cuando la prueba necesite más tiempo. Si el valor solo procede de intentos locales, trátalo como hipótesis y no como garantía del proveedor.
¿El polling reemplaza una prueba de eventos?
No. El polling comprueba una condición observable cuando esa es la ruta del cliente o cuando la visibilidad retrasada es el objeto de la prueba. Si el producto promete un webhook o evento, prueba por separado la entrega, la correlación, los duplicados y la recuperación.
Conclusión
Probar la consistencia eventual no consiste en elegir un sleep suficientemente grande. Consiste en escribir el contrato de visibilidad y dar a la prueba un único presupuesto de tiempo. El polling comprueba la condición correcta, termina pronto cuando hay éxito y no oculta fallos que no pertenecen a la propagación normal.
Ese diseño hace que el fallo sea útil. Sabes qué escritura inició el flujo, qué lectura se retrasó, qué estado se observó por última vez y qué límite se superó. La misma disciplina sirve para réplicas, cachés, índices de búsqueda y proyecciones basadas en eventos.
Cómo se produjo este artículo
Samuel Fajreldines es el autor responsable de este texto. La investigación combinó la documentación oficial de Playwright, la documentación de DynamoDB, la API de temporización de Node.js, resultados actuales en portugués, inglés y español y discusiones públicas de desarrolladores. Los fragmentos de Playwright son ejemplos ilustrativos de contrato, no mediciones de un sistema de producción.
Usé asistencia de IA para descubrir fuentes, organizar, redactar, generar la imagen, traducir y revisar la coherencia. Esa asistencia no ejecutó una arquitectura distribuida real, no midió la latencia de propagación y no sustituyó la verificación de las fuentes oficiales.
Fuentes consultadas
- Playwright, "Assertions", consultado el 13/10/2026. Documenta aserciones con retry,
expect.poll, intervalos y timeouts. - Amazon Web Services, "DynamoDB read consistency", consultado el 13/10/2026. Describe lecturas eventuales, lecturas fuertes y límites de los índices.
- Node.js, "Performance timing API", consultado el 13/10/2026. Referencia para un reloj monotónico al calcular un deadline.
- OneUptime, "How to Test Eventually Consistent APIs with Polling Instead of Fixed Sleeps", consultado el 13/10/2026. Síntesis práctica usada para comparar formatos y fallos, no como prueba del comportamiento de un proveedor.