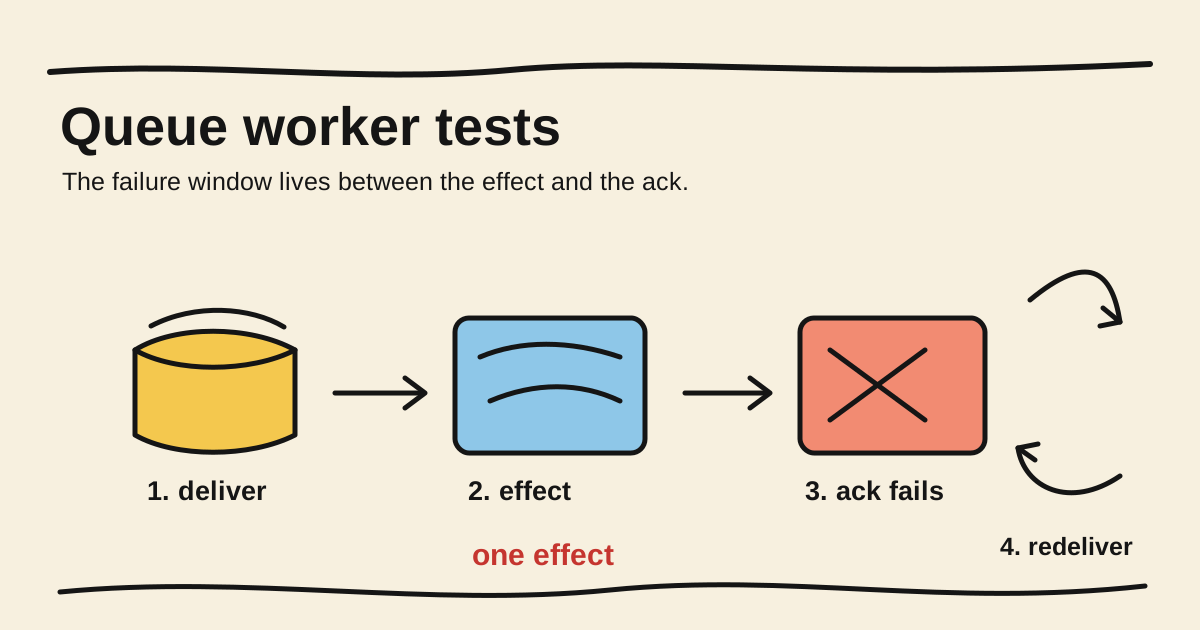
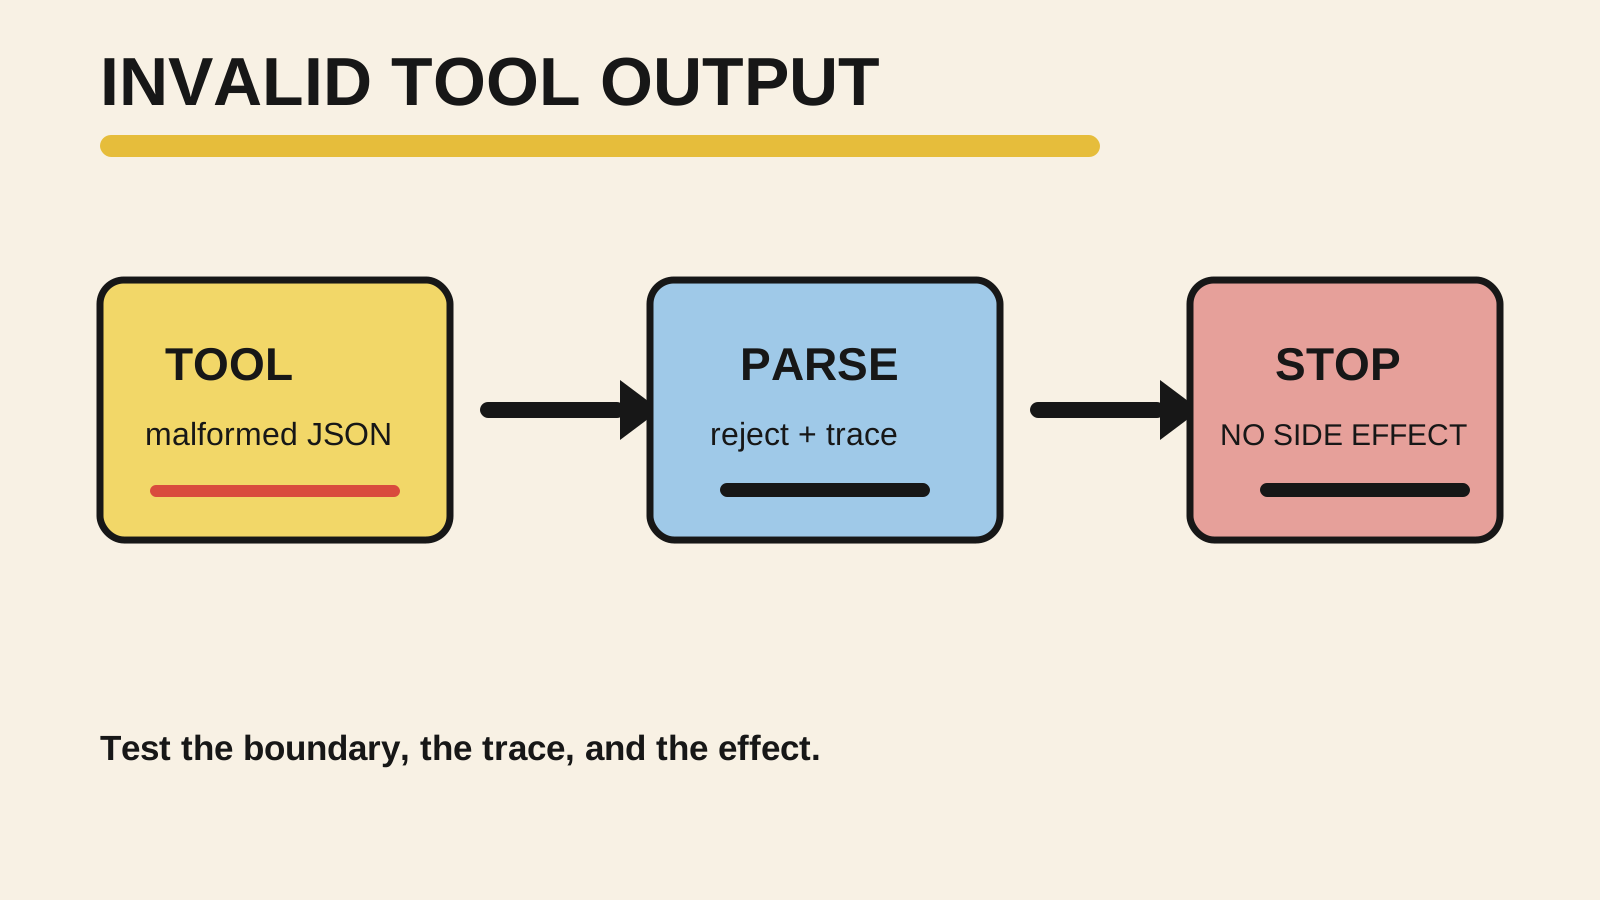
Una tool puede devolver HTTP 200 y aun así entregar un resultado que el agente no puede usar. El cuerpo puede ser JSON mal formado, tener el tipo equivocado u omitir el campo que autoriza el siguiente paso. Para probar este caso, inyecta la respuesta defectuosa en la frontera de la tool y revisa todo el recorrido, no solo la frase final del agente.
El test debe demostrar cuatro cosas: el parser rechazó el valor, el trace registró el motivo, la política de recuperación tomó una decisión conocida y ninguna tool con un efecto externo fue llamada. La guía sobre validar tool calls en TypeScript cubre el contrato de entrada. Este artículo pregunta qué probar después de que una tool devuelva una salida que no cumple su contrato.
Este recorte también es más pequeño que un eval completo. Evaluar la trayectoria de un agente observa el recorrido general. Para la frontera de persistencia después de una propuesta, consulta cómo validar la salida de un agente antes de guardarla. Aquí fijamos un fallo de tool y hacemos visible su consecuencia: el siguiente envío no puede ocurrir.
Respuesta breve
- Inyecta el payload inválido en el adaptador de la tool sin depender de una API o un modelo real.
- Separa el JSON mal formado del JSON válido con una forma incorrecta.
- Registra el error en el trace y verifica la política de detención o recuperación.
- Cuenta las llamadas a la siguiente tool y confirma que el efecto quedó en cero.
¿Qué debe demostrar el test?
No empieces por el texto que el agente mostró al usuario. Empieza por la frontera que convierte la respuesta de la tool en datos internos. El test debe responder preguntas distintas:
- ¿El texto se puede interpretar como JSON?
- ¿El valor interpretado tiene la forma que exige el runtime?
- ¿El agente debe detenerse, pedir una corrección, reintentar o derivar el caso?
- ¿Alguna tool posterior recibió autorización para producir un efecto?
JSON.parse() convierte una cadena en un valor de JavaScript y falla cuando la cadena no representa JSON válido (MDN, JSON.parse()). Eso responde solo a la primera pregunta. {"accountId":"acct-1"} es JSON válido, pero sigue siendo insuficiente si el contrato también exige status.
Un eval de agentes suele separar tarea, intento, grader, trace y resultado en el entorno. Anthropic describe estas partes en su guía sobre evals de agentes, incluida la diferencia entre lo que aparece en el transcript y el estado final que existe fuera de él. Aquí el estado final es simple: una respuesta inválida no puede llegar al efecto de envío.
Inyecta el fallo en la frontera correcta
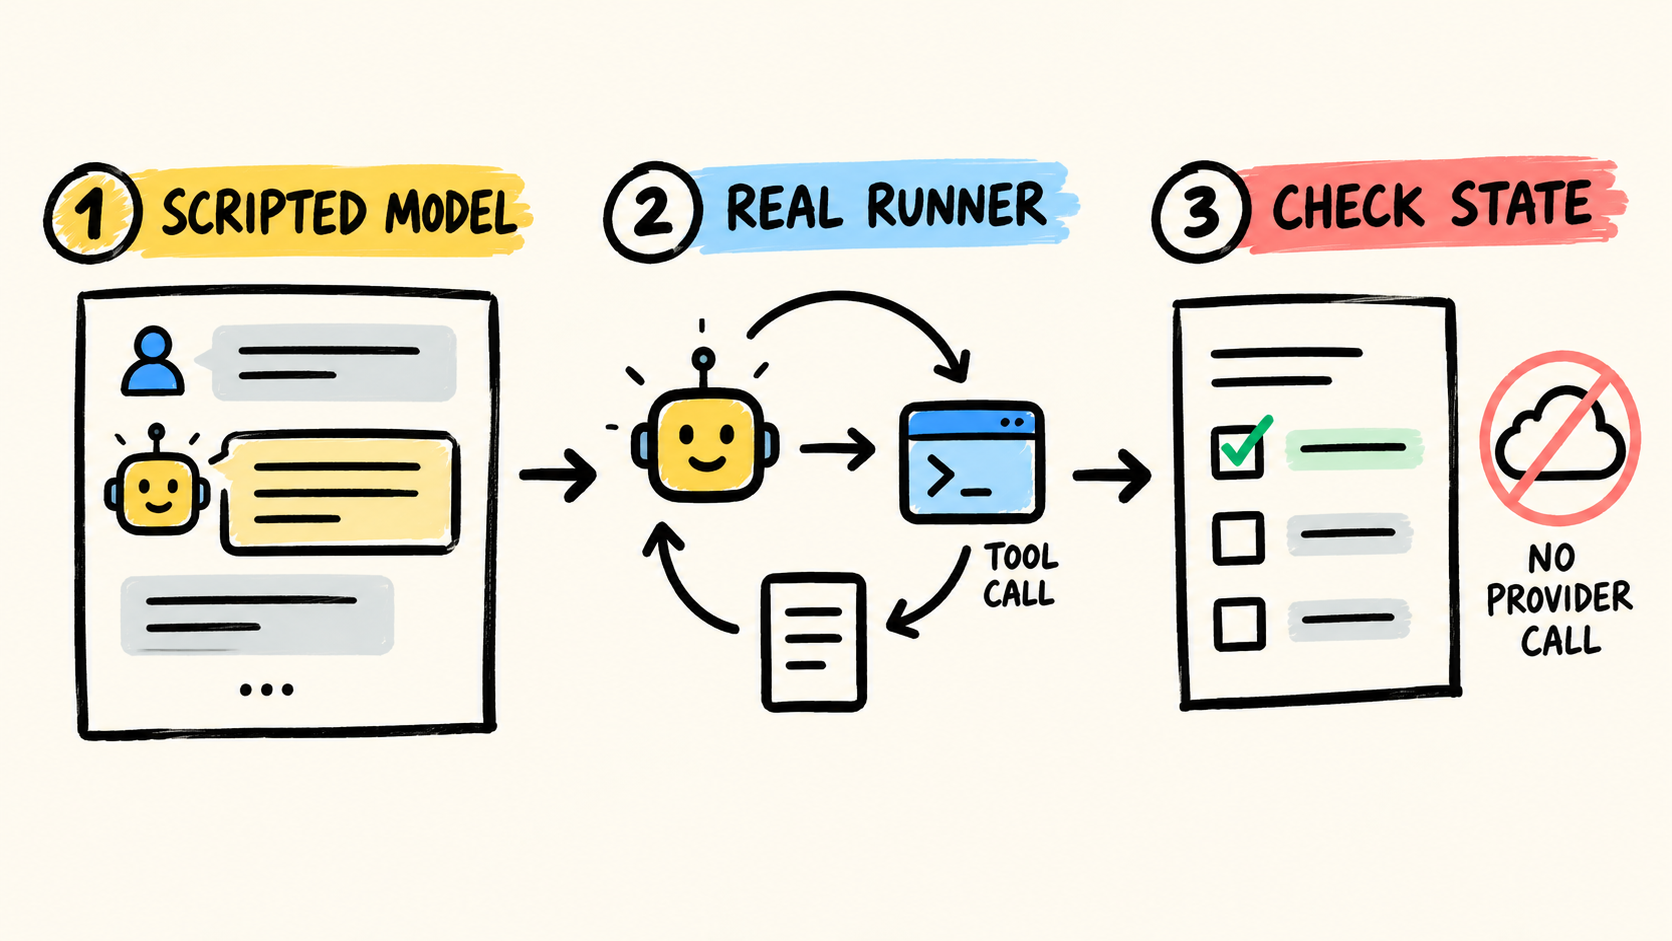
Un mock en el nivel del modelo no prueba la frontera de la tool. Puede devolver directamente el resultado que el código espera y dejar fuera del recorrido al parser, el trace o el dispatcher. El punto de inyección debe ser el adaptador que el runner llama realmente.
En este ejemplo, el agente consulta una cuenta. Si la cuenta necesita revisión, llama a sendEmail. El test controla lookupAccount, pero mantiene reales el parser, la decisión y el contador del efecto dentro de la fixture.
async function runAgent({ lookupAccount, sendEmail }) {
  const trace = [];
  trace.push({ kind: "tool_call", name: "lookup_account" });
  const raw = await lookupAccount({ accountId: "acct-1" });

  try {
    const account = parseAccount(raw);
    trace.push({ kind: "tool_result", name: "lookup_account", status: "valid" });

    if (account.status === "needs_review") {
      await sendEmail({ accountId: account.accountId });
    }

    return { status: "completed", trace };
  } catch (error) {
    trace.push({ kind: "tool_error", name: "lookup_account", code: error.code });
    return { status: "blocked", trace };
  }
}
El trace de la fixture no intenta reproducir el formato de un proveedor. Registra solo los eventos que el contrato local necesita comprobar. En producción, usa el formato de observabilidad que ya exista en tu runtime. La guía de OpenAI para evaluar workflows de agentes usa traces para registrar llamadas de modelo, tools, guardrails y handoffs, y recomienda graders estructurados para encontrar fallos del workflow.
El detalle importante es que sendEmail no está escondido dentro del mock de lookupAccount. Si el test controla las dos funciones de manera que nunca existe un camino entre ellas, no puede demostrar que una respuesta inválida bloquea el efecto.
Haz que el caso sea ejecutable con node:test
El runner incluido en Node ejecuta este caso sin instalar otro framework. La documentación de node:test de Node.js cubre el runner, las aserciones y las funciones de mocking. La fixture usa solo node:test y node:assert/strict.
import { test } from "node:test";
import assert from "node:assert/strict";

class ToolOutputError extends Error {
  constructor(code) {
    super(code);
    this.code = code;
  }
}

function parseAccount(raw) {
  let value;
  try {
    value = JSON.parse(raw);
  } catch {
    throw new ToolOutputError("invalid_json");
  }

  if (
    !value ||
    typeof value !== "object" ||
    typeof value.accountId !== "string" ||
    typeof value.status !== "string"
  ) {
    throw new ToolOutputError("invalid_shape");
  }

  return value;
}

// Incluye runAgent del ejemplo anterior en el mismo archivo.
test("el JSON mal formado se detiene antes del efecto", async () => {
  let sent = 0;
  const result = await runAgent({
    lookupAccount: async () => '{"accountId":"acct-1"',
    sendEmail: async () => { sent += 1; },
  });

  assert.equal(result.status, "blocked");
  assert.equal(sent, 0);
  assert.deepEqual(result.trace.at(-1), {
    kind: "tool_error",
    name: "lookup_account",
    code: "invalid_json",
  });
});

test("el JSON válido con una forma incorrecta también se rechaza", async () => {
  let sent = 0;
  const result = await runAgent({
    lookupAccount: async () => JSON.stringify({ accountId: "acct-1" }),
    sendEmail: async () => { sent += 1; },
  });

  assert.equal(result.status, "blocked");
  assert.equal(sent, 0);
  assert.equal(result.trace.at(-1).code, "invalid_shape");
});

test("la salida válida llega al efecto solo con la precondición", async () => {
  let sent = 0;
  const result = await runAgent({
    lookupAccount: async () => JSON.stringify({
      accountId: "acct-1",
      status: "needs_review",
    }),
    sendEmail: async () => { sent += 1; },
  });

  assert.equal(result.status, "completed");
  assert.equal(sent, 1);
});
Guarda el fragmento en un archivo .mjs que también contenga runAgent y ejecuta:
node --test invalid-tool-output.test.mjsEn mi ejecución local del 10 de noviembre de 2026, con Node.js v25.5.0, los tres casos pasaron. Eso es evidencia de la fixture en memoria: alcanza las tres decisiones que declara el código. No es un test del proveedor del modelo, de una API externa ni de la entrega de correo.
Comprueba el error, el recorrido y el efecto
Un test débil comprueba solo que se lanzó una excepción. Eso puede dejar al runtime sin un resultado utilizable. Otro test débil comprueba solo status: "blocked", pero no confirma si ya ocurrió una escritura antes del bloqueo.
Usa aserciones por capas:
- Error de frontera:
invalid_jsoneinvalid_shapeson códigos distintos. El operador necesita saber si debe investigar transporte, parser o contrato. - Trace: el trace contiene la llamada original y el evento de error. Así se distingue una tool que falló de una que nunca fue registrada.
- Política: la ejecución termina como
blocked, se deriva o entra en un retry limitado según el contrato. No uses el mensaje final como sustituto de esa decisión. - Efecto externo: el contador de
sendEmail, la lista de comandos o la fixture de base de datos no cambia cuando la precondición no fue demostrada.
Este formato también evita exigir una secuencia rígida cuando hay más de un camino seguro. Fija la invariante, como “no enviar sin una cuenta válida”, en lugar de cada frase que el modelo podría escribir. Cuando la elección del modelo forme parte del riesgo, añade un eval con el modelo y un grader separado. El test local sigue siendo responsable de la frontera determinista.
Amplía la matriz sin mezclar las capas
Después de los tres casos básicos, añade fallos que respondan a preguntas diferentes:
| Escenario | Inyectar | Comprobar |
|---|---|---|
| JSON mal formado | Cadena truncada o comilla sin cerrar | El parser rechaza, el trace registra invalid_json y el efecto queda en cero |
| Forma JSON incorrecta | Campo obligatorio ausente o tipo inesperado | El schema rechaza antes del siguiente dispatcher |
| JSON válido, valor incorrecto | status desconocido o ID incompatible |
El runtime no convierte la validez sintáctica en autorización |
| Error de transporte | Timeout o conexión rechazada | La política diferencia fallo de red y respuesta inválida |
| Recuperación | Segunda respuesta válida tras un fallo | El retry es limitado y no duplica la operación |
| Modelo real | Error de tool devuelto al modelo | El agente se detiene o corrige dentro del límite esperado |
Un test unitario puede usar funciones en memoria. Un test de contrato debe comprobar el formato que recibe realmente el adaptador. Un test de integración puede conectar una API de prueba y revisar el sistema de registro. Un eval con un modelo real debe observar el trace y el estado, porque el modelo puede responder de forma plausible sin arreglar el problema.
No conviertas la tabla en una lista permanente de mocks. Mantén cada caso cerca de la frontera que protege. El post sobre probar regresiones de agentes sin comparar texto exacto ayuda cuando el problema deja de ser un payload concreto y pasa a ser un comportamiento que debe mantenerse estable.
Fallos que dejan el test en verde
Validar solo el parser
assert.throws(() => JSON.parse(raw)) demuestra que el parser reconoce una entrada mala. No demuestra que el runner registre el error, termine el turno o bloquee la siguiente tool. Mantén la llamada al parser dentro del recorrido que usa el agente.
Simular el runner completo
Si el mock devuelve directamente { status: "blocked" }, el test no ejercita la decisión. Sustituye el modelo o el adaptador externo, pero deja reales el dispatcher, el parser, el trace y la aserción del efecto.
Comprobar solo la respuesta final
Una frase como “no pude completar esto” no dice si el agente ya envió el correo antes de escribirla. Cuenta la operación, revisa la fixture externa y registra la secuencia de eventos.
Reintentar todos los errores igual
Una salida inválida puede ser recuperable, pero el retry necesita presupuesto y una nueva entrada verificada. Si cada intento devuelve la misma respuesta mal formada, el test debe terminar con un límite explícito, no con un bucle.
Usar una tool de escritura en el caso unitario
Para probar la política basta un sendEmail falso con un contador. Deja SMTP, una base de datos o una cola para el test que necesite demostrar la integración. Un caso local no debe disparar efectos reales por accidente.
Checklist para CI
- ¿El fallo se inyecta en la frontera que el runner llama realmente?
- ¿La suite separa JSON mal formado, forma incorrecta, valor inválido y error de transporte?
- ¿El trace registra la tool, el motivo y el
runIdsin guardar secretos ni payloads sensibles? - ¿El test verifica la política de detención, retry limitado o derivación?
- ¿Existe una aserción sobre la tool que produce efectos y sobre el estado externo?
- ¿El caso sigue siendo determinista sin red, reloj ni llamadas al modelo?
- ¿Un test de contrato cubre el formato real del adaptador?
- ¿Existe al menos un eval separado para decisiones que dependen del modelo?
- ¿El caso falla cuando el código llama a la tool de efectos antes de validar la respuesta?
Un test de salida inválida es pequeño, pero protege una frontera importante. No necesita saber si el modelo es bueno. Necesita demostrar que el sistema no convierte una respuesta sin pruebas en permiso para cambiar el mundo.
Cómo se produjo este artículo
Samuel Fajreldines es el autor responsable. La investigación comparó la documentación actual de OpenAI y Anthropic sobre evaluación de agentes con la documentación de node:test y discusiones públicas recientes. Las discusiones ayudaron a elegir el lenguaje de los fallos; no se usaron como prueba técnica.
Ejecuté localmente una fixture en memoria con Node.js v25.5.0. Inyecta JSON mal formado, JSON con una forma incompleta y una respuesta válida. El resultado observado fueron tres tests aprobados. La fixture no llamó a un modelo, proveedor externo, cuenta ni servicio de correo.
Usé RemoteCode como herramienta del autor para organizar el contexto y revisar la estructura. No ejecutó los tests ni aportó evidencia de producción.