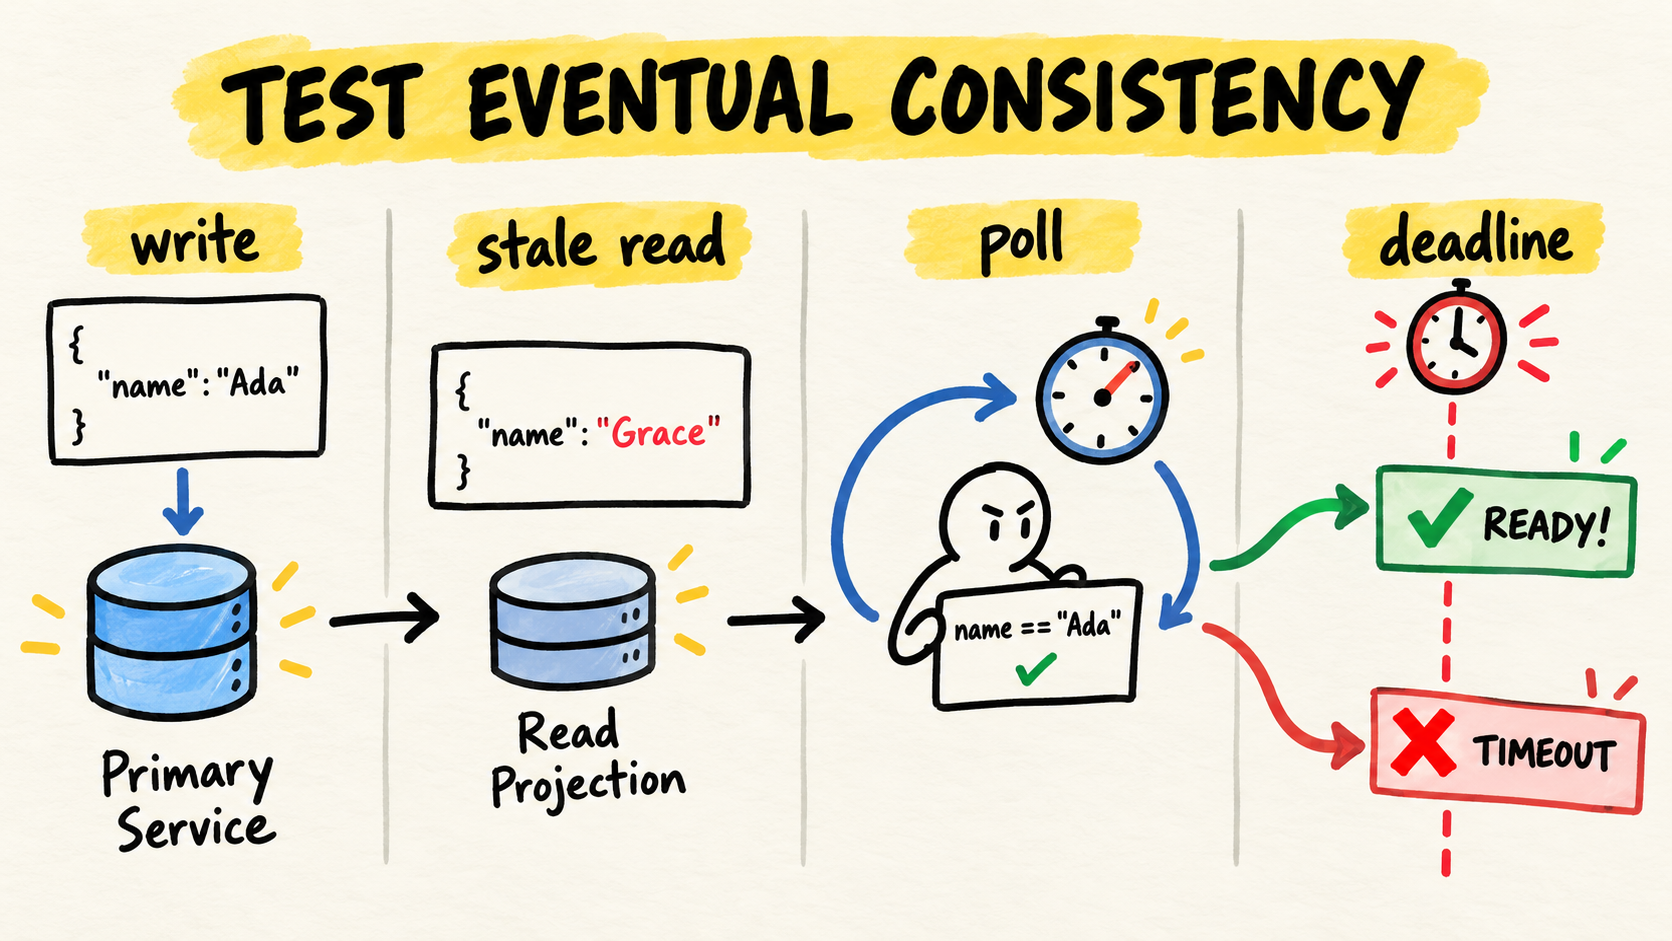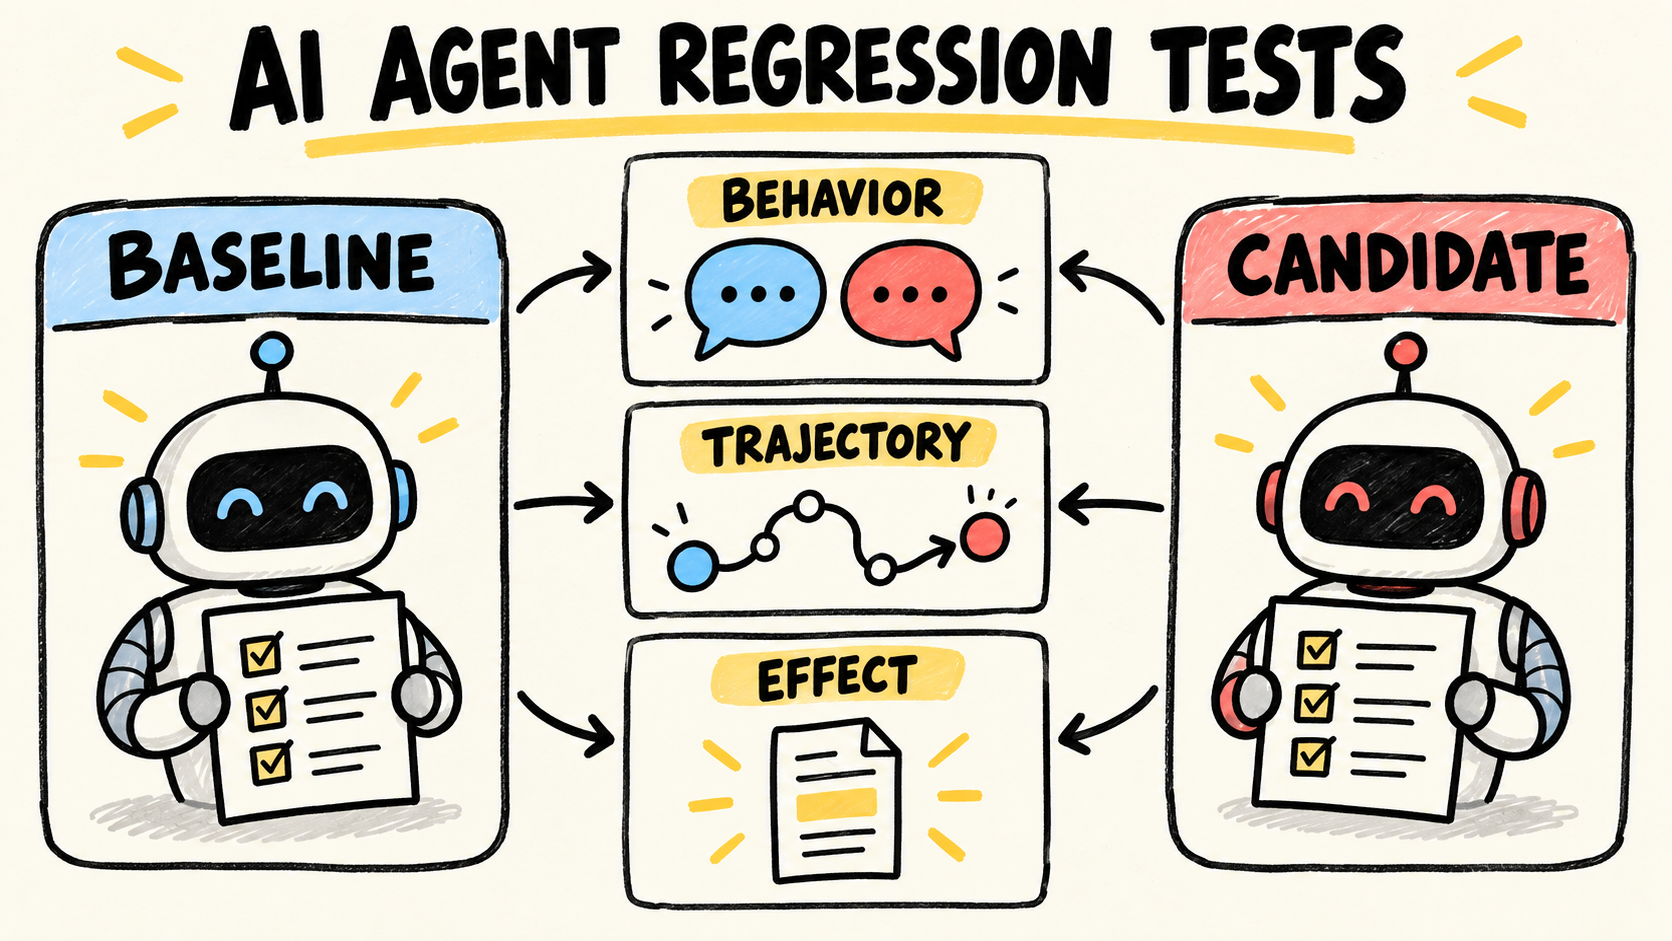
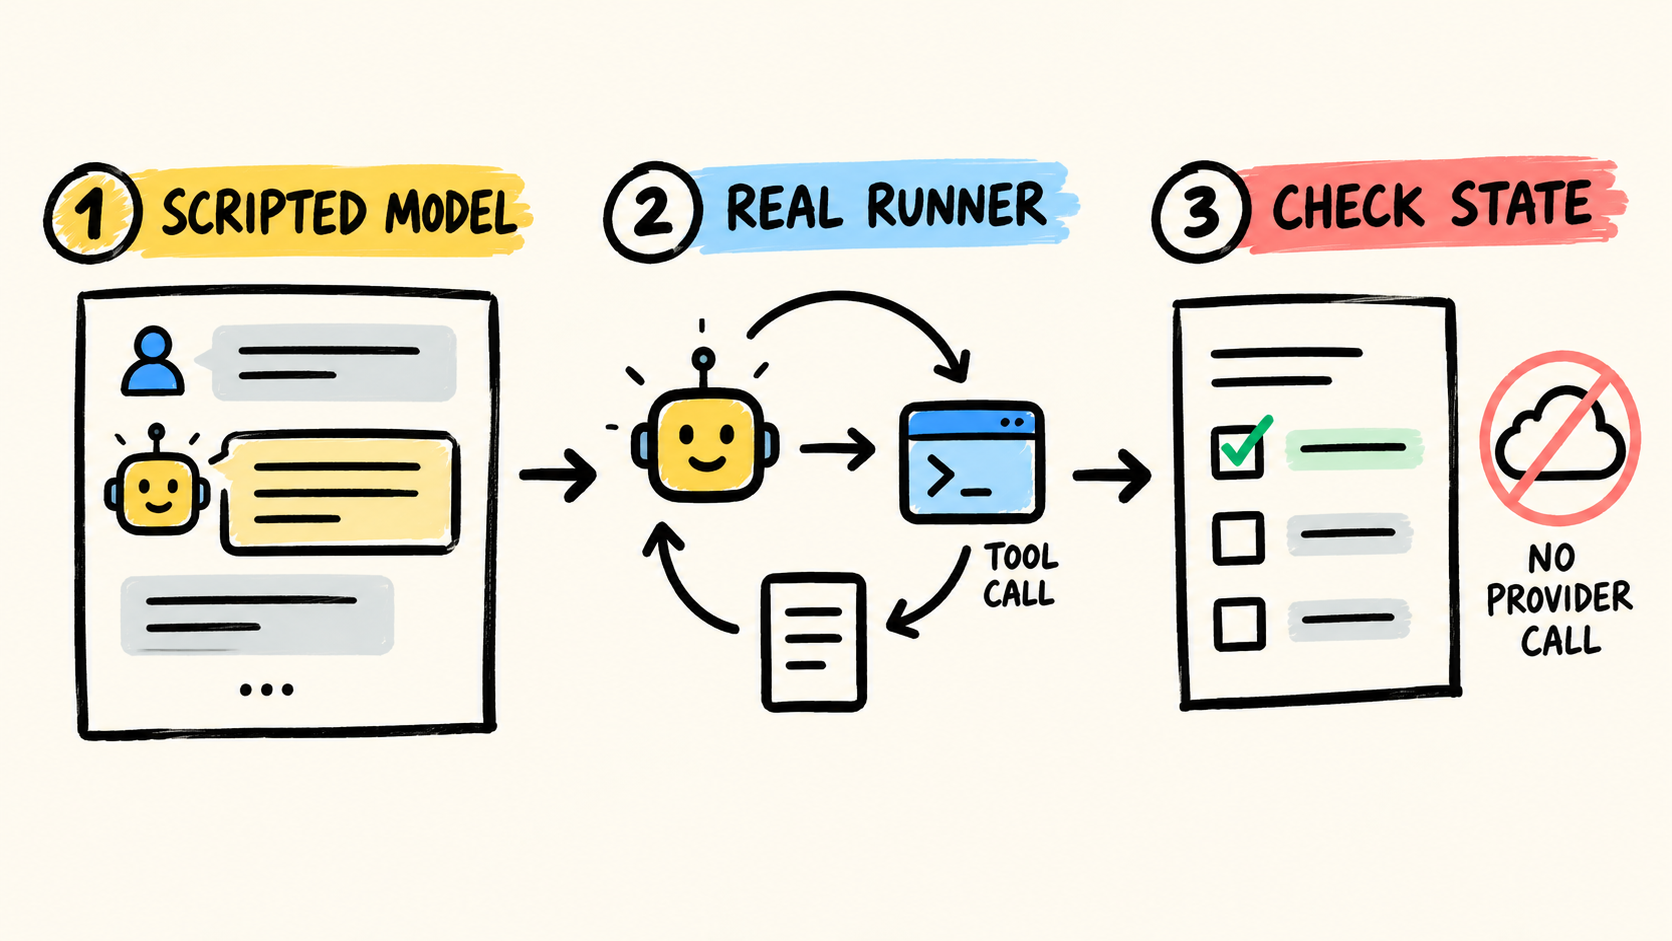
Una prueba de agente puede pasar porque un mock devolvió exactamente la respuesta que escribiste. El runner quizá nunca procesó la tool, comprobó el estado ni terminó en el punto correcto.
Para probar el código del agente sin hacer otra llamada al proveedor, sustituye la frontera del modelo por una secuencia local. Mantén bajo prueba el runner, el dispatcher y los fakes de estado. Después comprueba la trayectoria y el efecto, no solo la frase final.
Esta es una capa distinta de probar un agente con un mock o con un modelo real. Ese artículo ayuda a elegir la dependencia. Este construye la prueba rápida que no necesita secretos y muestra exactamente qué puede demostrar.
Respuesta breve
- Sustituye el cliente del modelo por respuestas guionizadas, no todo el runner.
- Usa tools falsas, observables y sin acceso a la red.
- Comprueba llamadas, argumentos, estado y terminación del bucle.
- Reserva el modelo real para decisiones, prompts y comportamiento emergente.
¿Qué controla esta prueba y qué queda fuera?
La prueba controla la entrada que el runner recibe del modelo y las dependencias que pertenecen a tu código. Así puedes reproducir una llamada a una tool, un fallo conocido, una respuesta incompleta o un turno adicional. Anthropic, "Demystifying evals for AI agents", separa tareas, trials, graders y traces como partes distintas de una evaluación.
Usa este mapa antes de escribir la fixture:
| Pregunta | Frontera controlada | Evidencia esperada |
|---|---|---|
| ¿El runner acepta una tool call válida? | Modelo guionizado | Nombre y argumentos registrados |
| ¿El resultado de la tool llega al siguiente turno? | Tool en memoria | Mensaje de tool y siguiente paso |
| ¿El bucle se detiene con una respuesta final? | Secuencia finita | Ninguna llamada inesperada |
| ¿El estado producido es correcto? | Repositorio en memoria | Estado antes y después |
| ¿Un modelo real elegiría esta tool? | Ninguna en la prueba offline | Requiere integración o eval real |
El último punto es el límite importante. Un fake demuestra que tu código sabe manejar una decisión conocida. No predice cómo un modelo interpretará una instrucción nueva. La guía actual de OpenAI para evaluar workflows de agentes también separa traces, graders, datasets y ejecuciones de evaluación. No mezcles esas preguntas en un solo resultado verde.
¿Cómo conectas un modelo guionizado con el runner real?
Empieza por la interfaz que el runner ya necesita. El fake solo debe conocer las formas de entrada y salida, no las reglas internas del bucle. En cada llamada devuelve el siguiente paso de la secuencia. Si el runner pide un paso que no existe, la prueba falla en vez de inventar una respuesta conveniente.
El ejemplo usa únicamente módulos de Node.js. La documentación del test runner de Node.js admite pruebas asíncronas que devuelven una Promise. Esta fixture no importa un SDK de proveedor ni abre una conexión de red.
const test = require("node:test");
const assert = require("node:assert/strict");

function scriptedModel(...replies) {
  let position = 0;
  const calls = [];

  return {
    calls,
    async complete(input) {
      calls.push(input);
      const reply = replies[position++];
      if (!reply) throw new Error("unexpected model call");
      return reply;
    },
    assertConsumed() {
      assert.equal(position, replies.length, "the script was not fully consumed");
    },
  };
}
El método assertConsumed protege contra un falso verde frecuente. Si el runner termina antes e ignora un paso esperado, la fixture debe informarlo. Lo mismo vale para una llamada adicional: debe fallar antes de alcanzar una dependencia externa.
¿Cómo mantienes observable el bucle y las tools?
El runner sigue siendo el objeto importante bajo prueba. Lee una respuesta del modelo, despacha la tool, envía el resultado al siguiente turno y se detiene con una respuesta final. La tool falsa no debe ser un retorno fijo escondido. Debe registrar su argumento y cambiar un estado pequeño que la prueba pueda consultar.
async function runAgent({ model, tools, input }) {
  const messages = [{ role: "user", content: input }];
  const trace = [];

  for (let turn = 0; turn < 4; turn += 1) {
    const reply = await model.complete({ messages });

    if (reply.type === "final") {
      return { answer: reply.text, trace };
    }

    if (reply.type !== "tool") {
      throw new Error("invalid model reply");
    }

    const tool = tools[reply.name];
    if (!tool) throw new Error(`unknown tool: ${reply.name}`);

    trace.push({ name: reply.name, args: reply.args });
    const result = await tool(reply.args);
    messages.push({ role: "assistant", content: JSON.stringify(reply) });
    messages.push({ role: "tool", content: JSON.stringify(result) });
  }

  throw new Error("turn limit exceeded");
}

test("runs the real loop with a local scripted model", async () => {
  const orders = new Map([["ord-7", { status: "paid" }]]);
  const calls = [];
  const model = scriptedModel(
    { type: "tool", name: "getOrder", args: { id: "ord-7" } },
    { type: "final", text: "El pedido ord-7 está pagado." },
  );

  const result = await runAgent({
    model,
    input: "¿Cuál es el estado de ord-7?",
    tools: {
      async getOrder({ id }) {
        calls.push({ name: "getOrder", id });
        return orders.get(id);
      },
    },
  });

  assert.equal(result.answer, "El pedido ord-7 está pagado.");
  assert.deepEqual(result.trace, [
    { name: "getOrder", args: { id: "ord-7" } },
  ]);
  assert.deepEqual(calls, [{ name: "getOrder", id: "ord-7" }]);
  assert.equal(model.calls.length, 2);
  model.assertConsumed();
});

test("rejects a tool that is not in the test boundary", async () => {
  const model = scriptedModel({
    type: "tool",
    name: "deleteOrder",
    args: { id: "ord-7" },
  });

  await assert.rejects(
    () => runAgent({ model, input: "Borra ord-7", tools: {} }),
    /unknown tool: deleteOrder/,
  );
  assert.equal(model.calls.length, 1);
});
La documentación de Vitest sobre mocks de funciones ofrece APIs equivalentes para controlar retornos y observar llamadas. El principio no depende de Vitest: el modelo se puede sustituir, mientras el bucle, la tool y el estado siguen visibles.
Ejecuté esta fixture con Node.js v25.5.0. Hace dos llamadas al fake local, ninguna al proveedor, y conserva el pedido en un Map. Eso demuestra el dispatcher y el contrato del runner en este escenario. No demuestra autenticación, serialización del SDK, concurrencia, una base de datos ni la selección de una tool por un modelo real.
¿Qué aserciones evitan un falso verde?
Empieza por señales observables. La respuesta final es útil, pero rara vez basta para un agente que llama tools. La prueba debe indicar qué llamada ocurrió, qué argumentos cruzaron la frontera, qué estado cambió y por qué terminó el bucle.
Comprueba al menos:
- Tool permitida: una llamada desconocida falla antes del efecto.
- Argumentos: el dispatcher recibe el identificador y los valores predeterminados esperados.
- Resultado consumido: la respuesta de la tool llega al siguiente turno.
- Estado: el registro o evento tiene el valor esperado.
- Terminación: el runner no hace llamadas después de la respuesta final.
- Límite: una secuencia interminable alcanza un límite de turnos.
Estas aserciones deben ser más pequeñas que la implementación. Si el requisito es "consultar el pedido correcto", no congeles toda la redacción de la respuesta. Si una frase legal exacta forma parte del requisito, la igualdad textual puede ser parte del contrato. La decisión debe salir del comportamiento que necesitas conservar.
Cuando una tool tiene un efecto mutable, usa un fake que cuente las operaciones y exponga el estado final. Para un correo, guarda en memoria el destinatario y el cuerpo. Para una actualización, conserva un registro sintético. Si la prueba comprueba solo "hecho", puede pasar sin ejecutar nada o después de ejecutarlo dos veces.
¿Cómo conviertes los fallos en casos repetibles?
El camino feliz es el comienzo, no la suite. Añade una fixture por cada fallo que el runtime deba manejar. El caso debe declarar su entrada, estado inicial, respuesta controlada, efecto permitido y resultado esperado.
| Escenario | Respuesta controlada | Qué comprobar |
|---|---|---|
| La tool devuelve un fallo transitorio | Error en la primera llamada, éxito en la siguiente | Retry limitado y ninguna llamada después del éxito |
| La tool devuelve datos inválidos | Objeto sin un campo obligatorio | Rechazo explícito o fallback seguro |
| El modelo pide una tool desconocida | Llamada fuera del catálogo | Error antes de cualquier efecto |
| El runner recibe una respuesta final temprana | Respuesta final en el primer paso | Cero llamadas posteriores |
| El proceso supera el límite | Llamadas repetidas a una tool | Terminación clara y estado consistente |
La prueba de fallos no tiene que fingir que representa toda la producción. Demuestra una combinación concreta. Para ampliar la cobertura, combínala con la prueba de trayectoria de un agente y convierte un defecto reproducido en un caso de regresión. Para revisar forma y argumentos en la frontera de la tool, usa validación de tool calls en TypeScript.
Evita una trampa: una tool falsa puede repetir la misma suposición que el código bajo prueba. Mantén las fixtures sencillas, valida las entradas e inspecciona el efecto producido. Cuando el comportamiento depende del servicio real, añade una prueba de integración contra un entorno aislado. No conviertas la fixture local en un certificado de integración.
¿Cómo separas la prueba offline de un eval real en CI?
Ejecuta la capa determinista en el pull request. Debe funcionar sin clave, red ni estado compartido. Reserva el eval con el modelo real para una tarea programada, un cambio de prompt o un cambio de proveedor. Esta separación explica mejor los fallos y evita que una caída externa oculte una regresión del runner.
La prueba offline puede demostrar que una respuesta guionizada recorre el camino esperado. Un eval real debe comprobar si el modelo elige ese camino a partir de lenguaje natural. Una capa no sustituye a la otra.
En CI, guarda como artefactos la secuencia de llamadas, los argumentos normalizados, el estado inicial, el estado final y la versión del caso. No publiques tokens, secretos ni datos de usuarios. Un trace pequeño es más fácil de revisar y basta para localizar la frontera rota.
Si cambia el propio verificador, pruébalo con casos positivos y negativos. Una suite que solo comprueba el camino feliz puede aceptar un state correcto mientras ignora un efecto duplicado. La prueba debe fallar cuando desaparece la evidencia relevante.
Checklist antes de confiar en la suite
- ¿El modelo es local, guionizado y puede informar de llamadas inesperadas?
- ¿El runner real sigue ejecutándose?
- ¿Las tools del escenario evitan la red y las bases de datos compartidas?
- ¿La prueba comprueba nombres, argumentos, orden cuando es un requisito y resultado?
- ¿El estado externo está representado por evidencia que la prueba puede leer?
- ¿Los límites de turnos, retries y efectos están explícitos?
- ¿Los casos de error distinguen fallo, éxito desconocido y datos inválidos?
- ¿Está escrito qué pregunta requiere un modelo real o una integración?
- ¿Una persona puede investigar el trace sin abrir un secreto?
Si no puedes responder la última pregunta, la prueba puede estar verde sin ayudarte a depurar. El valor de una capa determinista es su frontera explícita: vuelve repetible tu código y deja la incertidumbre restante en la capa que puede medirla.
Conclusión
Para probar un agente sin llamadas adicionales al LLM, guioniza la frontera del modelo y mantén observable el resto del runner. Usa tools falsas, un estado pequeño y aserciones sobre llamadas, argumentos, efectos y terminación.
Después escribe el límite junto a la prueba. La fixture local demuestra el comportamiento del código frente a una secuencia conocida. Un eval con un modelo real demuestra otra cosa. Cuando ambas capas tienen nombres y criterios propios, una prueba verde dice más que "el agente respondió".
Cómo se produjo este artículo
Samuel Fajreldines es el responsable de este artículo. La investigación comparó la documentación actual de Anthropic, OpenAI, Vitest y Node.js con los owners de pruebas existentes en este cluster. Las conversaciones públicas se usaron solo para lenguaje y modos de fallo, no como prueba técnica. Ejecuté la fixture localmente con Node.js v25.5.0. No hace llamadas al proveedor, no mide calidad del modelo y no representa un entorno de producción.
Usé RemoteCode como herramienta del autor para conservar el contexto y la evidencia entre sesiones. Apoyó el flujo de escritura, pero no ejecutó la fixture ni demostró las afirmaciones técnicas. La asistencia de IA apoyó la búsqueda de fuentes, la comparación, la redacción, la generación de la imagen, la localización y la revisión de consistencia. El código y los límites se comprobaron en el repositorio antes de publicar.