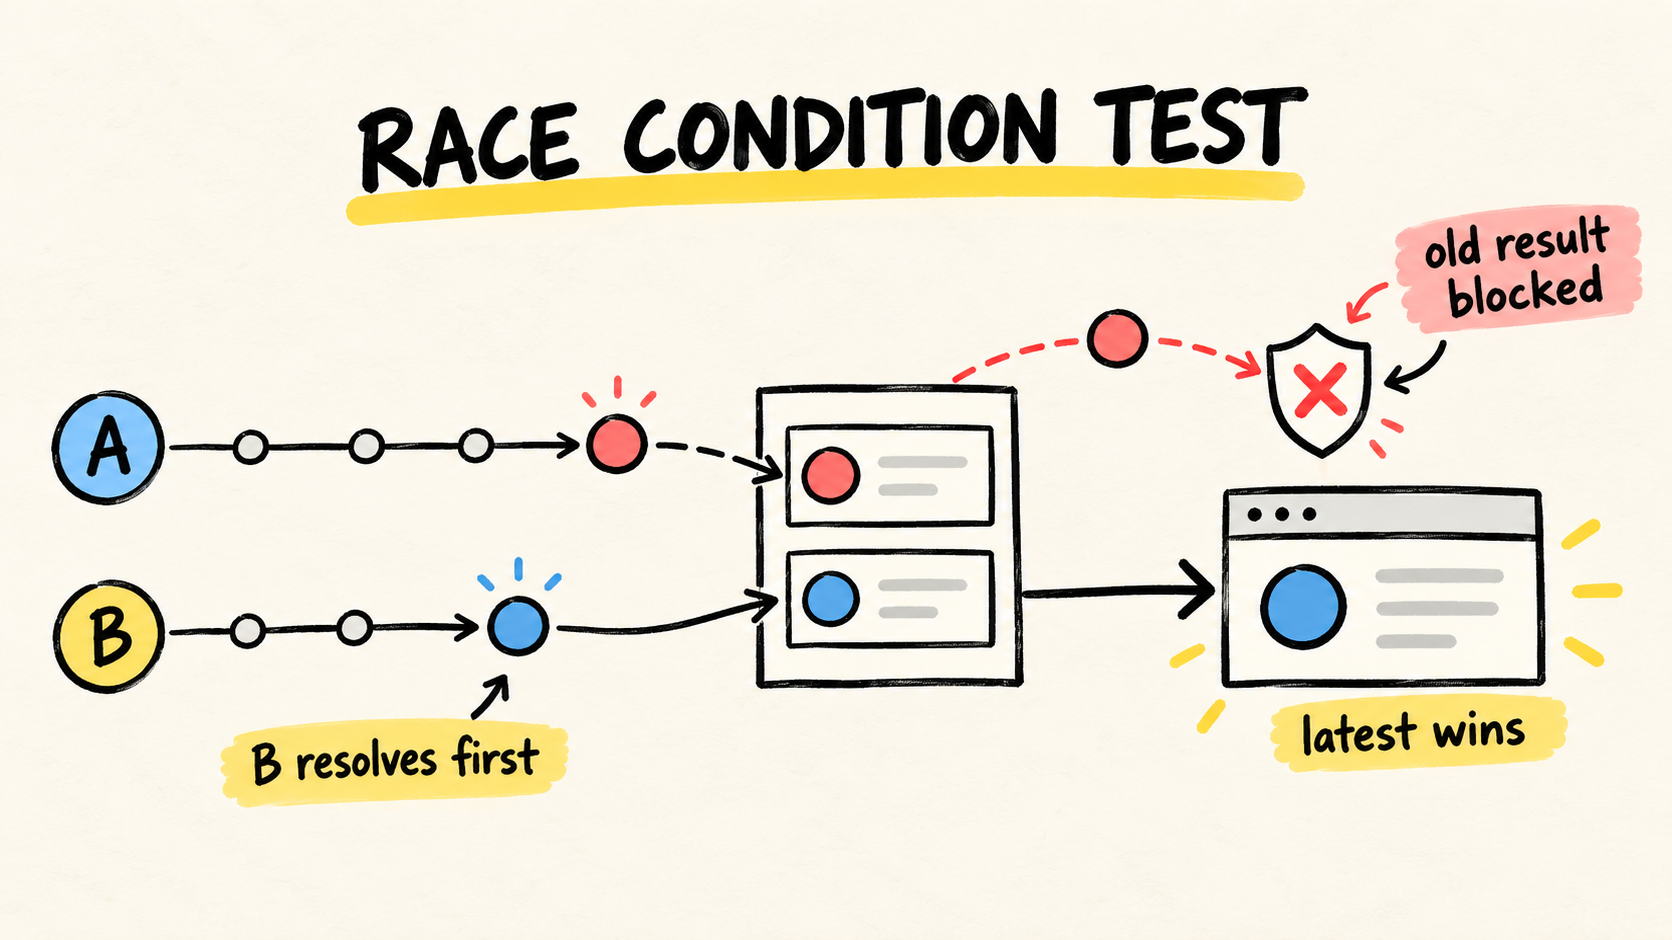
Una prueba puede seguir en verde mientras un agente cambia su comportamiento. La respuesta final parece igual, pero usó otra herramienta, omitió una aprobación o escribió el mismo efecto dos veces. Esa regresión queda invisible cuando la suite solo compara el texto generado.
Para probar regresiones en agentes de IA, congela casos representativos y compara invariantes observables. El estado final, las herramientas permitidas, los pasos obligatorios y los efectos externos suelen ser mejores contratos que el texto exacto. El texto sí merece una comprobación cuando forma parte del requisito.
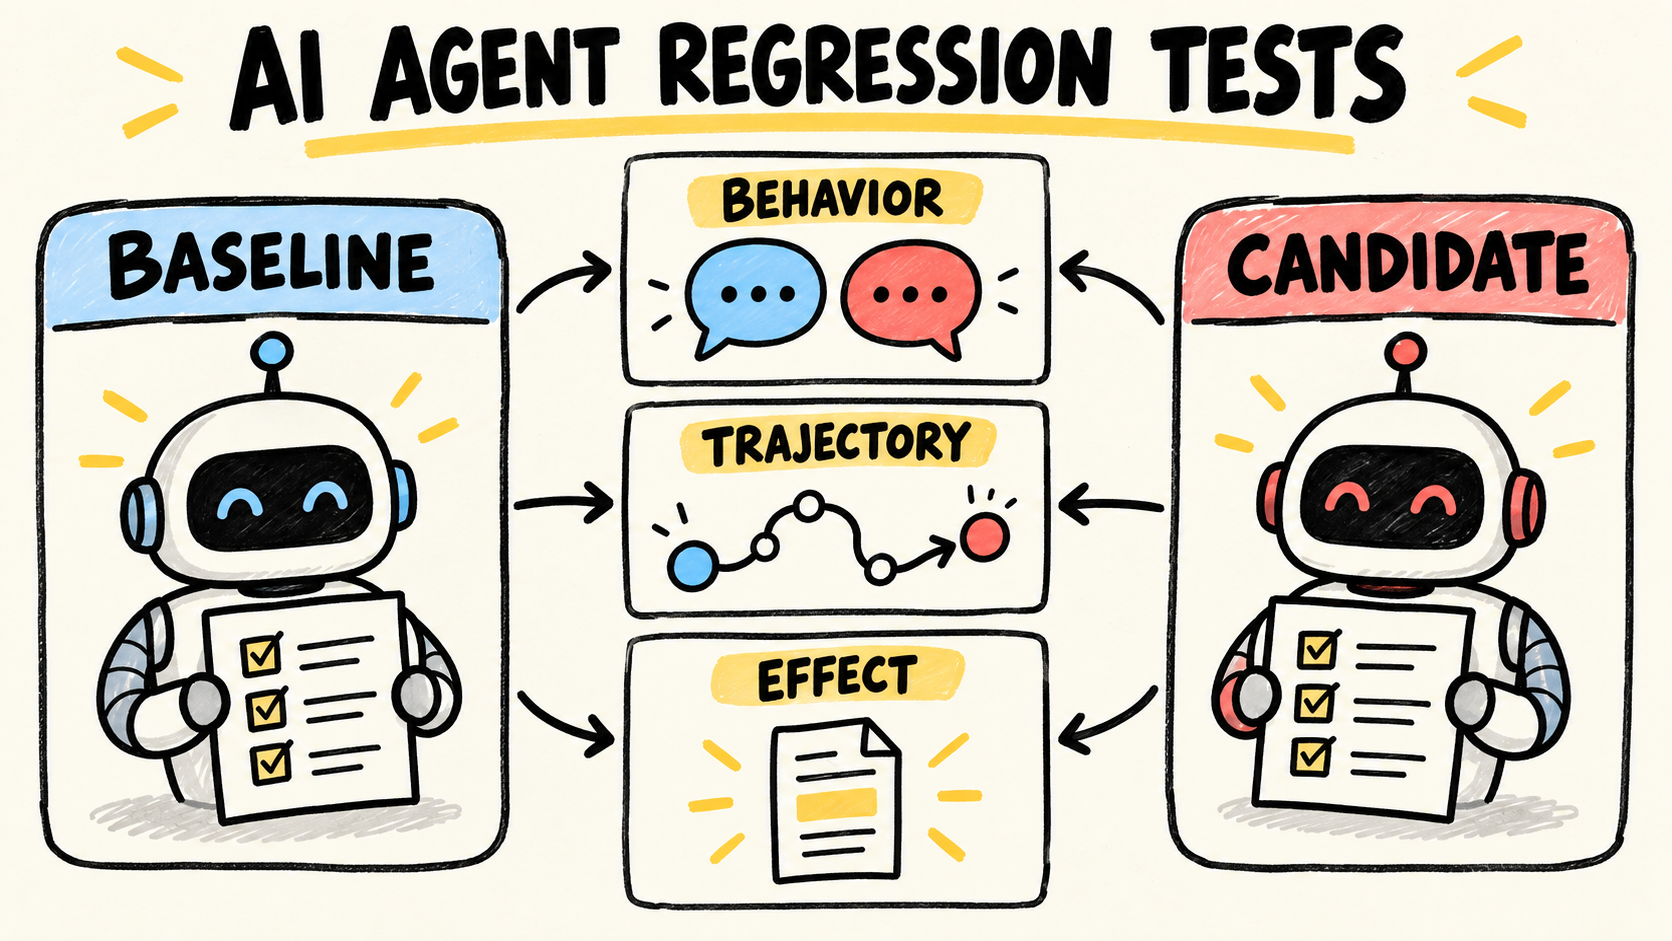
Este artículo separa tres preguntas: ¿el agente hizo lo correcto, siguió una trayectoria aceptable y dejó el efecto esperado? La guía sobre probar agentes con un mock o una API real ayuda a elegir la dependencia de cada capa. Aquí el objetivo es detectar un cambio no deseado después de crear los casos.
Respuesta breve
- Guarda casos que representen comportamientos importantes, incluidos fallos que ya hayan ocurrido.
- Compara estado, evidencia, herramientas y efectos. No exijas la misma frase sin una razón.
- Ejecuta varios trials cuando el modelo varíe y registra la distribución, no solo un resultado verde o rojo.
- Investiga una diferencia antes de actualizar el baseline. Una mejora intencional necesita una decisión explícita.
¿Qué cuenta como regresión en un agente de IA?
Una regresión es un cambio que hace que el agente deje de cumplir un comportamiento que antes se aceptaba. Anthropic, en "Demystifying evals for AI agents", plantea las evals de regresión alrededor de una pregunta sencilla: ¿el agente todavía resuelve las tareas que antes resolvía? El objetivo no es impedir todo cambio, sino hacerlo visible antes de que lo encuentre el usuario.
El disparador puede ser un prompt reescrito, un modelo actualizado, un schema de herramienta modificado, una regla de enrutamiento, una fuente de recuperación o una política de aprobación. La prueba no necesita saber qué disparó la diferencia. Necesita conservar evidencia suficiente para que la investigación encuentre la frontera que cambió.
Un caso de regresión necesita al menos una entrada, un criterio de éxito y una forma de registrar el resultado. Para un agente que consulta pedidos, el criterio puede ser devolver el pedido correcto sin usar una herramienta fuera de la allowlist. Para un agente que actualiza datos, puede incluir una sola mutación confirmada y un recibo que se pueda comprobar después.
¿Qué debes comparar: comportamiento, trayectoria o efecto?
Compara señales separadas porque cada una responde a una pregunta distinta. El mensaje final puede parecer correcto aunque la trayectoria haya violado una regla. La trayectoria puede parecer normal mientras el sistema externo recibe un duplicado. La prueba es útil cuando cada señal tiene un criterio claro.
| Señal | Pregunta | Ejemplo de aserción |
|---|---|---|
| Comportamiento | ¿El agente entregó el resultado pedido? | El estado final contiene el pedido correcto. |
| Trayectoria | ¿El camino respetó las reglas? | Usó solo herramientas permitidas y pidió aprobación antes de mutar. |
| Efecto | ¿El sistema externo quedó en el estado correcto? | Existe una escritura confirmada y no hay duplicados. |
| Texto | ¿La forma de la respuesta es parte del contrato? | Incluye el aviso obligatorio y no expone un campo prohibido. |
El marco de evaluación iterativa de Microsoft separa escenarios fundamentales, variaciones, pruebas de arquitectura y condiciones adversarias. Esa división evita convertir cada diferencia en una comparación de strings. Primero prueba el comportamiento central. Después usa variaciones para saber si el agente memorizó la frase del caso.
La regla práctica es sencilla: el baseline guarda criterios, no una transcripción sagrada. Cambiar el orden de dos lecturas puede ser aceptable. Eliminar una comprobación de autorización no lo es, aunque el texto final siga igual. Es una decisión de diseño, no una métrica universal.
¿Cómo conviertes un fallo en un caso de regresión?
Empieza por un fallo concreto o por un comportamiento que deba conservarse. Reduce el caso hasta que incluya entrada, datos controlados, resultado esperado y evidencia que pruebe la decisión. Si necesitas explicar el criterio de forma oral antes de que alguien lo entienda, todavía es demasiado vago.
Un formato pequeño puede vivir junto al código:
{
  "id": "pedido-sin-aprobacion",
  "input": "Actualiza la dirección del pedido ord-7",
  "expected": {
    "state": "unchanged",
    "allowedTools": ["get_order"],
    "requiredEvents": ["approval.denied"],
    "effects": 0
  }
}
Este ejemplo es ilustrativo. No conoce tu proveedor ni afirma que todos los agentes necesiten estos campos. Su valor está en convertir una expectativa en datos que un verificador pueda leer. Un caso positivo también debe decir qué no puede ocurrir, como una herramienta no permitida o una escritura sin confirmación.
Cuando un usuario encuentra un defecto, conserva la evidencia mínima para reproducirlo: entrada, versión del agente, herramientas disponibles, estado inicial, salida relevante y efecto observado. No copies tokens, datos personales ni prompts secretos al repositorio. La guía sobre registrar la auditoría de un agente explica por qué la frase final del modelo no demuestra un efecto externo.
¿Cómo evitas que la variación del modelo cree una falsa alarma?
No uses la igualdad textual como regla por defecto para respuestas abiertas. Un modelo puede escribir dos respuestas correctas con palabras diferentes. Prefiere aserciones sobre estado, hechos obligatorios, reglas prohibidas, herramientas permitidas y efectos confirmados. La igualdad exacta tiene sentido cuando una frase legal o un formato de protocolo es el contrato.
Anthropic llama trial a cada ejecución de una tarea y recomienda varias ejecuciones porque las salidas del modelo pueden variar. Eso no significa escoger el resultado más conveniente. Define antes cuántos trials ejecutarás, qué tasa aceptarás y cuándo un caso inestable debe salir del gate.
Separa los niveles de prueba:
- Determinista: schema, allowlist, cantidad de efectos, estado final y campos obligatorios.
- Semántico: calidad, cobertura, tono o cumplimiento de una rúbrica.
- Humano: ambigüedad del requisito, riesgo de negocio y decisión sobre un cambio intencional.
Un juez basado en un modelo puede ayudar en la capa semántica, pero no debe convertirse en una autoridad invisible. La guía de graders de OpenAI muestra distintos checks. Trata la herramienta actual como una implementación reemplazable, no como el contrato de tus pruebas. Calibra cualquier juez con revisión humana y conserva checks deterministas para los hechos objetivos.
¿Cómo pruebas el verificador antes de confiar en el gate?
El propio verificador también necesita pruebas. Si siempre lee state e ignora effects, la suite puede parecer sofisticada y aun así dejar pasar una escritura duplicada. Una fixture pequeña en JavaScript puede demostrar que cada evidencia ausente vuelve rojo el caso.
import assert from "node:assert/strict";
import test from "node:test";

function passes(run, expected) {
  return run.state === expected.state &&
    run.toolCalls.every((name) => expected.allowedTools.includes(name)) &&
    run.events.includes("approval.denied") === expected.requiredEvents.includes("approval.denied") &&
    run.effects === expected.effects;
}

test("rechaza una mutación cuando la aprobación fue denegada", () => {
  const expected = {
    state: "unchanged",
    allowedTools: ["get_order"],
    requiredEvents: ["approval.denied"],
    effects: 0,
  };

  assert.equal(passes({
    state: "unchanged",
    toolCalls: ["get_order"],
    events: ["approval.denied"],
    effects: 0,
  }, expected), true);

  assert.equal(passes({
    state: "unchanged",
    toolCalls: ["get_order", "update_order"],
    events: ["approval.denied"],
    effects: 1,
  }, expected), false);
});
Ejecuté esta fixture con Node.js v25.5.0. Prueba la capa de grading, no un modelo, una red ni una base de datos. Esa diferencia forma parte del resultado: un verificador puede ser correcto mientras la evaluación del agente todavía necesita casos reales, varios trials y revisión humana.
¿Cómo decides si la diferencia es una regresión real?
No actualices el baseline ante el primer resultado rojo. Abre el caso y compara entrada, estado inicial, versión del prompt, modelo, herramientas y resultado. Después clasifica la diferencia como regresión, mejora intencional, cambio de requisito, fallo de la fixture o inestabilidad.
Si cambió el requisito, actualiza el caso y registra la decisión en el pull request. Si el agente usa otra trayectoria, comprueba que siga cumpliendo el contrato. Si la diferencia aparece en un trial y desaparece en los demás, mejora la prueba o sácala del gate hasta entender la variación. El baseline no debe congelar un comportamiento que el equipo decidió abandonar.
Un conjunto pequeño puede empezar con casos de fallos reales. Anthropic recomienda empezar con un conjunto sencillo y ampliarlo cuando aparezcan nuevos fallos. La documentación de Microsoft describe el ciclo evaluar, analizar, mejorar y volver a evaluar. El número adecuado depende del riesgo y de la variedad del producto. No existe un tamaño universal honesto.
¿Cómo llevas las regresiones al CI?
Separa el gate rápido de la evaluación que depende del modelo. En un pull request, ejecuta checks deterministas y un conjunto pequeño de escenarios estables. En una tarea programada o antes de cambiar prompt o modelo, ejecuta trials con el agente real y guarda los artefactos. Así el CI no finge que un mock demuestra el comportamiento del modelo, ni exige una llamada de red en cada cambio de código.
Un resultado mínimo debe identificar el caso, la versión del agente, el resultado, las señales que fallaron y los artefactos para investigar. No publiques transcripts sensibles en el comentario del pull request. El vínculo entre caso, ejecución y evidencia vale más que un porcentaje aislado.
Para coding agents, conecta la suite con evals de PR para frenar agentes de código en CI. Para cambios de herramientas o de salida estructurada, combínala con validación de tool calls en TypeScript. La prueba de regresión no sustituye esas comprobaciones. Verifica que los comportamientos que ya funcionaban sigan funcionando después del cambio.
Checklist para una suite que siga siendo útil
Revisa cada caso con estas preguntas:
- ¿Qué comportamiento o efecto protege este caso?
- ¿Se puede comprobar el criterio sin comparar palabras inestables?
- ¿Incluye un fallo o una variación que apareció en el uso real?
- ¿La trayectoria contiene herramientas, aprobaciones y límites que deben preservarse?
- ¿Se comprobó el efecto externo, o la prueba solo aceptó el mensaje del agente?
- ¿La cantidad de trials y la tasa aceptable se definieron antes de ejecutarlos?
- ¿Hay una persona responsable de revisar un rojo y decidir si cambia el baseline?
Si la respuesta a la última pregunta es no, tienes un informe automático, pero todavía no una práctica de regresión. La suite necesita un responsable que pueda distinguir un defecto de un cambio correcto.
Preguntas frecuentes
¿Tengo que comparar toda la respuesta del agente?
No. Compara la respuesta completa solo cuando la redacción sea un contrato explícito. En los demás casos, comprueba estado, hechos obligatorios, reglas prohibidas, herramientas permitidas, aprobaciones y efectos. Una aserción pequeña suele resistir mejor los cambios de modelo y todavía detecta una regresión real.
¿Una eval de regresión sustituye las pruebas unitarias?
No. Una eval observa el comportamiento del agente en un escenario. Las pruebas unitarias siguen siendo la forma directa de comprobar parsing, autorización, retry, schemas y reglas deterministas. La suite de regresión conecta esas pruebas con el comportamiento que el equipo decidió conservar.
¿Cuándo debo actualizar el baseline?
Después de investigar la diferencia y registrar que es deseada. Si cambió el requisito, actualiza el criterio y explica la decisión. Si el agente perdió una protección, corrige el agente. Si el resultado es inestable, resuelve la inestabilidad antes de convertirlo en aprobación.
Conclusión
Probar regresiones en agentes de IA no significa congelar cada palabra generada. Significa conservar lo que el sistema debe seguir haciendo: llegar al estado correcto, respetar herramientas y aprobaciones, producir los eventos necesarios y dejar el efecto esperado.
Empieza con un fallo concreto, escribe el criterio como datos y prueba el verificador antes de ponerlo en CI. Usa varios trials cuando el modelo varíe, pero mantén deterministas las partes objetivas. Cuando aparezca una diferencia, investiga antes de actualizar el baseline. Una buena suite puede decir no solo que algo cambió, sino qué cambió y por qué importa.
Cómo se produjo este artículo
Samuel Fajreldines es el autor responsable de este artículo. La investigación comparó la documentación actual de Anthropic, Microsoft y OpenAI con discusiones públicas recientes y los owners de testing existentes en el sitio. La fixture del verificador se ejecutó localmente con Node.js v25.5.0. No llama a un proveedor, no mide la calidad de un modelo y no representa una evaluación de producción. La asistencia de IA apoyó el descubrimiento, la comparación de fuentes, la redacción, la imagen, la localización y la revisión de consistencia; no aportó experiencia de producción ni sustituyó la verificación de fuentes.
Fuentes consultadas
- Anthropic, "Demystifying evals for AI agents", consultado el 2026-10-06.
- Microsoft Learn, "Construir un marco de evaluación iterativa en cuatro etapas", consultado el 2026-10-06.
- OpenAI, "Graders", consultado el 2026-10-06.
- Node.js, "Test runner", consultado el 2026-10-06. Usado para la fixture local.
- Reddit, "How do you actually test an agent harness when half of it is non-deterministic?", consultado el 2026-10-06. Usado como señal de lenguaje y failure modes, no como prueba técnica.