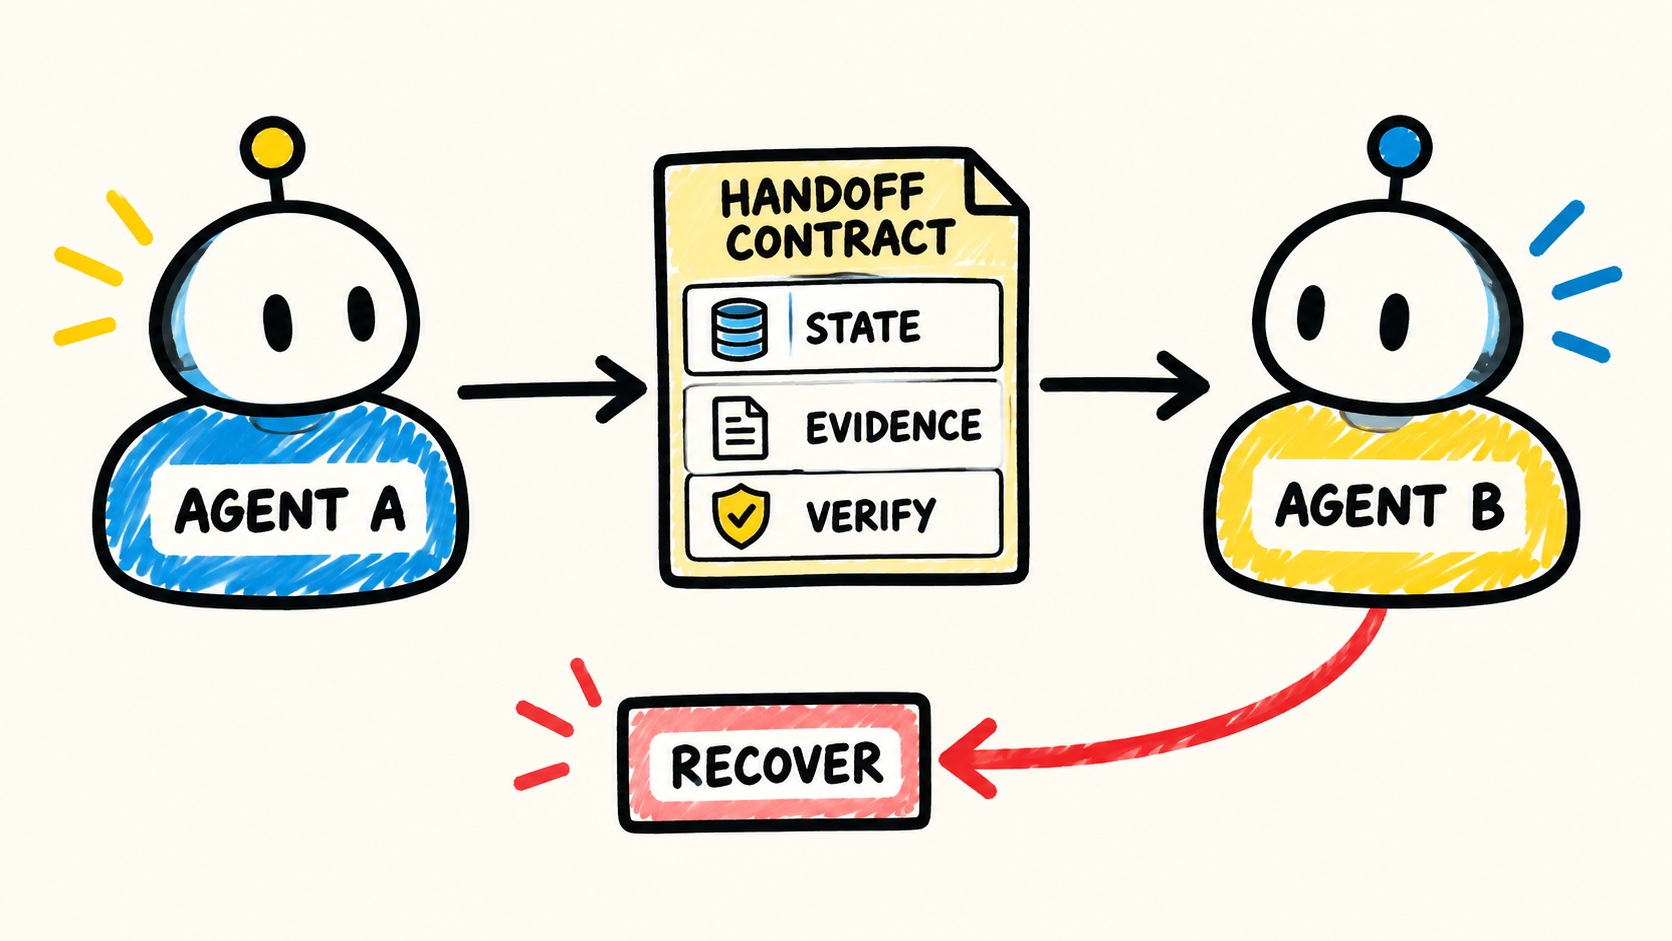
El agente envió un mensaje, cambió un registro o rechazó una herramienta. Cuando alguien pregunta qué ocurrió, el equipo solo encuentra la conversación y una traza llena de spans. Falta la relación entre la persona que inició la ejecución, la autoridad activa, la decisión aprobada y el sistema que confirmó el efecto.
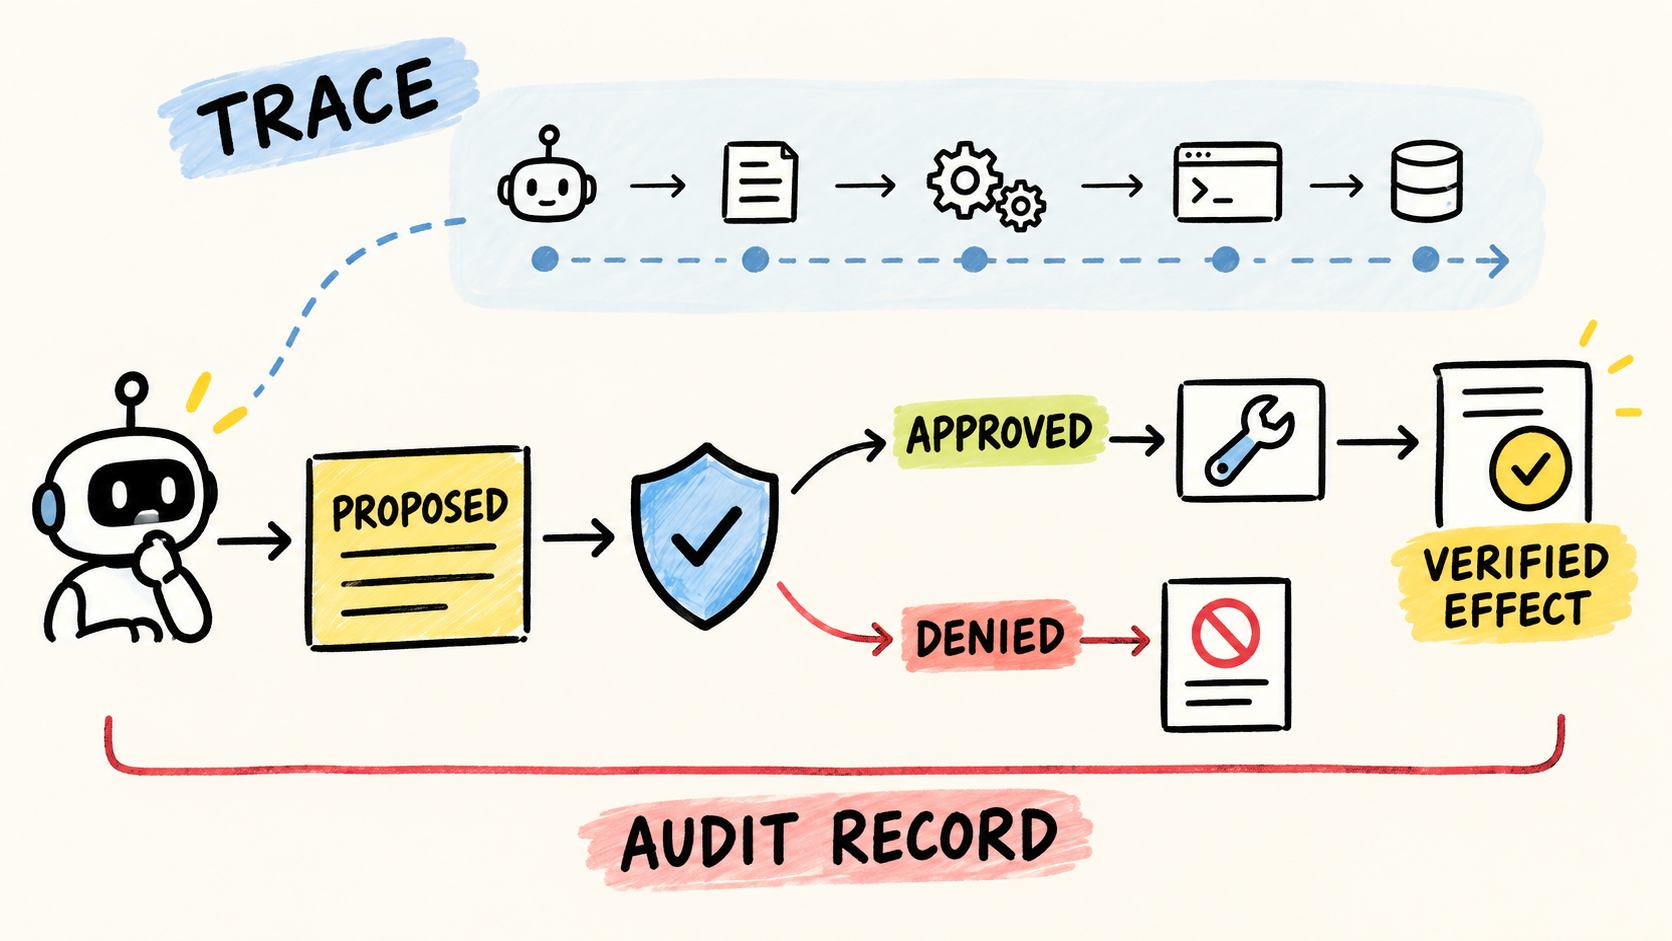
Para crear un registro de auditoría de un agente de IA, guarda eventos estructurados que conecten identidad, intención, política, acción y resultado. Incluye los intentos bloqueados, no solo las llamadas exitosas. El modelo puede proponer una acción, pero el runtime o el sistema que la ejecuta debe registrar qué se permitió, qué comenzó y qué se confirmó realmente.
Esto es distinto de guardar cada prompt. Una traza de tool calls de un agente con OpenTelemetry explica el orden y la duración de la ejecución. El registro de auditoría debe responder si la acción tenía autoridad, qué aprobación la cubría y qué evidencia quedó después.
Respuesta breve
- Registra
runId,traceId, la identidad humana o de servicio y las versiones del agente y del modelo.- Registra la acción propuesta, la herramienta, el objetivo, la política y la decisión, incluido
denied.- Vincula la aprobación con el payload exacto aprobado, no solo con el nombre de la herramienta.
- Separa
completeddeunknown: un timeout no demuestra que el efecto no ocurrió.- Guarda referencias, hashes y resultados redactados cuando el payload completo contiene datos sensibles.
Una traza y un registro de auditoría responden preguntas distintas
La traza responde: «¿En qué orden ocurrieron las operaciones y dónde falló la ejecución?». El registro de auditoría responde: «¿Quién autorizó esta acción, qué política se aplicó y qué resultado se puede verificar?». Un sistema puede producir ambos a partir de una ejecución, pero no debe tratarlos como el mismo registro.
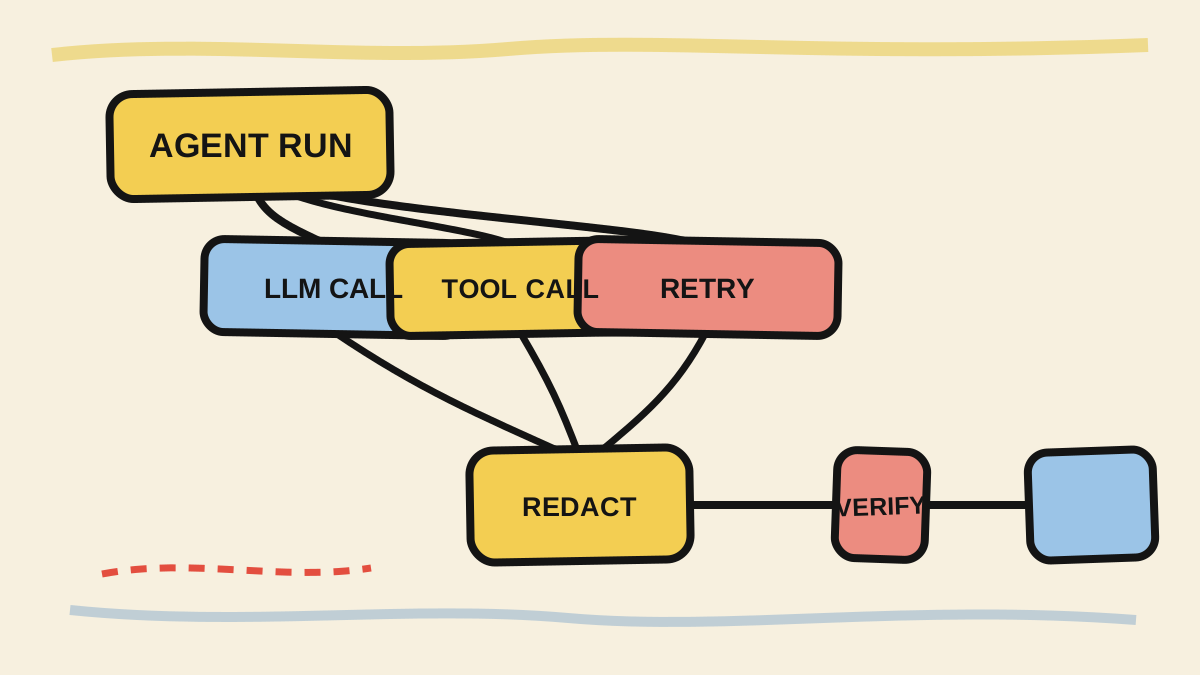
La guía de tracing del OpenAI Agents SDK describe trazas que incluyen generaciones del modelo, tool calls, handoffs, guardrails y eventos personalizados. La guía de tracing de la Agents API también organiza las llamadas a herramientas por agente, sesión, turno y span, con argumentos, resultados y estado cuando esos datos se registran. Eso es útil para diagnosticar.
La auditoría añade una relación de responsabilidad. El evento debe decir en nombre de quién ocurrió la acción, qué agente y versión estaban activos, qué alcance de autoridad se usó y si la acción fue propuesta, permitida, denegada, ejecutada o confirmada. La traza puede apuntar al evento con traceId; no lo sustituye.
Tampoco confundas el resumen final del agente con una prueba. El modelo puede afirmar que actualizó un pedido cuando la herramienta falló, fue bloqueada o terminó en un timeout antes de que alguien comprobara el resultado. El escritor del evento de resultado debe estar en la frontera que recibió la respuesta real de la herramienta o que volvió a leer el sistema externo.
¿Qué preguntas debe responder el registro?
Empieza por el incidente que querrías investigar seis semanas después. Un registro útil responde a estas preguntas sin reconstruir la historia a partir de cinco logs incompatibles.
| Pregunta | Campos mínimos | Fuente preferida |
|---|---|---|
| ¿Quién inició el trabajo? | actorId, tipo de identidad, runId |
gateway o runtime |
| ¿Qué agente tomó la decisión? | agentId, versión, modelId, versión de configuración |
runtime |
| ¿Cuál era el objetivo? | referencia de tarea o intención redactada | aplicación, no solo el modelo |
| ¿Qué acción se propuso? | herramienta, operación, objetivo, actionHash |
runtime antes de ejecutar |
| ¿Qué la autorizó? | alcance, regla, decisión y approvalId |
política o gateway |
| ¿La acción fue bloqueada? | decision: denied, regla, motivo categorizado |
frontera de política |
| ¿Qué se ejecutó? | intento, ID de solicitud externa, inicio y fin | ejecutor de la herramienta |
| ¿Cuál fue el efecto? | estado, recibo, referencia del recurso o read-back | sistema externo afectado |
| ¿Qué sigue siendo incierto? | outcome: unknown, motivo y siguiente paso |
runtime después de timeout o caída |
Estos campos no son un estándar universal. Son un contrato mínimo que vincula propuesta, autorización, ejecución y consecuencia. La guía de OWASP para proteger aplicaciones agénticas incluye el registro de planes, validaciones, tool calls, aprobaciones, errores y cambios de estado entre sus prácticas de operación segura. La lista anterior convierte esa preocupación en una frontera que el equipo puede implementar y probar.
No registres «el agente decidió» como si fuera una identidad. La identidad viene del usuario, servicio o credencial que inició la operación. El modelo y su versión explican qué componente generó la propuesta. La política explica por qué el ejecutor la aceptó o la rechazó. Son roles diferentes.
Modela el ciclo de la acción, incluido lo que no ocurrió
Un único evento tool_call: success es demasiado pequeño para una acción que pasa por aprobación, cola, retry y confirmación externa. Usa estados que representen transiciones observables. Un conjunto posible es:
proposed -> approved -> started -> completed
                 \-> denied
started -> failed
started -> unknown -> reconciled
proposed significa que el agente sugirió una operación. approved significa que una política o una persona autorizó ese payload. denied es útil y debe registrarse aunque no se haya llamado a ningún sistema externo. started marca que el ejecutor cruzó la frontera de autorización. completed solo debe aparecer cuando la herramienta o el sistema externo devolvió confirmación suficiente.
unknown importa en las acciones con efectos. Si un worker pierde la conexión después de enviar una solicitud, el proceso local sabe que perdió la respuesta, no que la operación falló. El runtime puede consultar el sistema externo, usar un ID de solicitud o aplicar una operación idempotente antes de cambiar unknown a reconciled o failed.
Esto complementa la guía para pausar y reanudar un agente de IA. El checkpoint guarda el estado necesario para continuar. El registro de auditoría guarda las transiciones y la evidencia que el runtime observó antes de la interrupción. Uno no debe sustituir al otro.
Vincula la aprobación con la acción exacta
Una aprobación que diga «puedes actualizar el CRM» es demasiado débil para una auditoría. El mismo nombre de herramienta puede recibir objetivos, filtros y valores diferentes. La aprobación debe apuntar a una representación estable de la operación que se ejecutará.
Una implementación puede guardar la acción normalizada, un hash del payload redactado y el alcance que se evaluó:
import { createHash, randomUUID } from "node:crypto";

type Decision = "proposed" | "approved" | "denied";
type Outcome = "started" | "completed" | "failed" | "unknown";

type AuditEvent = {
  id: string;
  createdAt: string;
  runId: string;
  traceId: string;
  actorId: string;
  agentId: string;
  agentVersion: string;
  eventType: "decision" | "execution";
  toolName: string;
  target: string;
  actionHash: string;
  decision?: Decision;
  outcome?: Outcome;
  policyRule?: string;
  approvalId?: string;
  externalRequestId?: string;
  evidenceRef?: string;
};

function hashAction(action: unknown): string {
  return createHash("sha256")
    .update(JSON.stringify(action))
    .digest("hex");
}

function makeAuditEvent(
  base: Omit<AuditEvent, "id" | "createdAt" | "actionHash">,
  action: unknown,
): AuditEvent {
  return {
    ...base,
    id: randomUUID(),
    createdAt: new Date().toISOString(),
    actionHash: hashAction(action),
  };
}
El código es ilustrativo. Muestra la forma del contrato, pero no implementa almacenamiento append-only, autorización, redaction, control de concurrencia ni confirmación externa. En producción, el ejecutor debe consumir la aprobación junto con actionHash; si cambia el payload, la aprobación ya no corresponde a la acción.
No uses el hash como prueba de que la acción se ejecutó. Como máximo, demuestra que una representación quedó asociada al evento. El resultado necesita el estado devuelto por la herramienta, un identificador externo o una lectura posterior del recurso. La diferencia entre «lo envié» y «el sistema lo confirmó» es la parte que el incidente intentará aclarar.
El runtime debe escribir el resultado, no el modelo
El modelo puede proponer una razón, una herramienta y unos argumentos. No debe ser el autor de la línea que afirma que se envió un pago, se borró un archivo o se cambió un permiso. El ejecutor conoce el ID de solicitud, el código de retorno y la excepción. Un gateway de política conoce la decisión y el alcance. El sistema externo puede aportar el recibo final.
Eso no significa descartar la salida del modelo. Guarda una referencia o un resumen redactado cuando haga falta para explicar la propuesta. Solo separa model_output de execution_result. El primero es una entrada para revisar. El segundo es una observación de la frontera que ejecutó o comprobó la acción.
La guía de observabilidad de Microsoft Agent Framework muestra por qué importa esta separación: prompts, respuestas, argumentos y resultados sensibles están desactivados por defecto, y activarlos puede exponer información confidencial. La configuración de telemetría no sustituye una política de retención. Incluso si la traza contiene un argumento, el registro de auditoría puede guardar solo un hash, una referencia protegida y el conjunto mínimo necesario para revisar.
Una división práctica es:
- Modelo: propone intención, herramienta y argumentos.
- Política: decide permitir, exigir aprobación o denegar.
- Ejecutor: registra inicio, fin, error, retry e ID de solicitud.
- Sistema externo: confirma el cambio o permite una lectura de reconciliación.
- Capa de auditoría: une las referencias y ofrece una vista revisable.
Esta división reduce la posibilidad de que una narración plausible se convierta en la única versión de lo ocurrido.
Qué no registrar por defecto
Un registro de auditoría completo no es un almacén de prompts. Guardarlo todo puede ampliar la filtración que querías investigar, aumentar el coste de retención y dar acceso a personas que solo necesitaban ver la decisión.
Empieza bloqueando por defecto:
- tokens, cookies, claves y cabeceras de autorización;
- prompts de sistema completos cuando una referencia versionada o un hash responde la pregunta;
- datos personales y financieros que no sean necesarios para identificar el objetivo;
- el cuerpo completo de respuestas externas grandes;
- el razonamiento privado del modelo tratado como una explicación verificable.
Usa identificadores, clasificación de datos, tamaño, estado, hash, referencia a un artefacto redactado y una política de acceso. Guarda el contenido completo en un almacenamiento separado solo cuando estén definidos su propósito, retención y controles de acceso. Redactarlo únicamente en el dashboard llega tarde: los datos quizá ya pasaron por el transporte, el exportador y el almacenamiento.
No prometas un «log inmutable» porque la aplicación escriba JSONL. Append-only es una propiedad del almacenamiento y de la autorización, no del formato del archivo. Si una revisión exige protección contra cambios, define quién puede escribir, quién puede leer, cómo se comprueba la integridad y cuánto tiempo existe el registro. Este artículo no convierte esas decisiones en una conclusión legal de cumplimiento.
¿Cómo probar que el registro cuenta la historia correcta?
Haz que la auditoría falle en un entorno controlado. Elige una herramienta con un efecto ficticio y verifica cada transición, no solo la respuesta final del agente.
- Ejecuta una acción permitida y comprueba
proposed,approved,startedycompleted. - Intenta una acción fuera del alcance y confirma que existe
deniedsin una llamada externa. - Cambia un argumento después de la aprobación y verifica que
actionHashya no coincide. - Haz que la herramienta devuelva un error y confirma
failed, con los secretos eliminados del mensaje. - Corta la conexión después del envío y confirma
unknown, sin convertir el timeout en «no se ejecutó». - Reconcilia usando el ID de solicitud externa y registra el recibo o la razón por la que sigue incierto.
- Cruza un handoff y comprueba que
runId,traceId, autoridad y versión del agente siguen conectados. - Envía un argumento sensible y confirma que el exportador recibe la forma redactada esperada.
La prueba más importante la hace alguien que no escribió el runtime. Dale un runId y una pregunta concreta, como «¿qué agente intentó cambiar este registro, qué regla lo permitió y qué confirmó el sistema?». Si necesita leer el código para entender la secuencia, el registro todavía es telemetría interna, no una traza de auditoría útil.
Para operaciones que pueden repetirse, combina esta prueba con verificar una tool call antes de reintentarlo y probar la idempotencia de una API sin duplicar efectos. El registro debe guardar el intento y la reconciliación, pero no puede arreglar un ejecutor que repite efectos.
¿Traza, log, métrica o checkpoint?
Usa cada señal para la pregunta que puede responder:
| Señal | Pregunta principal | No sustituye |
|---|---|---|
| Traza | ¿Cuál fue el orden y dónde apareció el tiempo o el error? | prueba de autorización o estado externo |
| Registro de auditoría | ¿Quién propuso, permitió, denegó y ejecutó la acción? | almacenamiento del estado del run |
| Métrica | ¿Cuántos fallos, bloqueos o acciones ocurrieron? | explicación de un caso individual |
| Checkpoint | ¿Desde dónde puede continuar el runtime? | prueba de que un efecto externo fue confirmado |
| Recibo externo | ¿Qué sistema confirmó qué cambio? | contexto de la decisión |
OpenTelemetry mantiene convenciones para trazas, eventos y señales de GenAI, pero una convención de telemetría no define automáticamente la política de auditoría de tu aplicación. Usa los IDs de trace y span para correlación cuando sea seguro. Mantén estable el contrato de auditoría aunque cambies el backend de observabilidad.
Preguntas frecuentes
¿Necesito guardar el prompt completo para auditar un agente?
No. Guarda una referencia versionada, un hash o un resumen redactado cuando baste para identificar el contexto. Conserva el contenido completo solo cuando el propósito y la política de acceso lo justifiquen. El registro debe explicar la decisión sin convertir todo lo que vio el agente en una copia permanente.
¿Una traza de OpenTelemetry ya es un registro de auditoría?
No necesariamente. Una traza organiza operaciones, duración, relaciones y errores. Un registro de auditoría añade identidad, autoridad, decisión de política, aprobación, acción exacta y resultado verificable. Puedes producir ambos juntos y conectarlos con traceId, pero no debes asumir que un dashboard de trazas conserva la evidencia o la retención necesarias para una revisión.
¿Debo registrar las acciones denegadas?
Sí, cuando el intento ayuda a responder qué quiso hacer el agente o el usuario y qué regla lo bloqueó. Una denegación puede ser el evento más importante de un incidente de prompt injection o de una mala configuración. Registra un motivo categorizado y la referencia de la política sin copiar datos sensibles innecesarios.
¿El registro puede demostrar la intención del modelo?
No. Puede registrar la salida que propuso la acción, la versión del modelo y el contexto seleccionado. Eso ayuda a investigar, pero no convierte una explicación generada después en una prueba causal. La autorización, la ejecución y el efecto deben registrarlos componentes que controlen esas fronteras.
Conclusión
Un agente no es auditable porque produzca más texto. Es auditable cuando cada acción importante deja un vínculo verificable entre identidad, autoridad, política, ejecución y efecto.
Empieza con un evento pequeño. Registra lo que se propuso, permitió o denegó, comenzó y confirmó. Conserva unknown cuando desaparezca la respuesta. Redacta el contenido que no necesita estar en el registro y prueba la historia con alguien que no conozca el código.
La traza explica el camino. El checkpoint permite continuar. El registro de auditoría sostiene la pregunta de responsabilidad. Mezclar estas funciones crea registros grandes y aun así deja la pregunta principal sin respuesta.
Cómo se hizo este análisis
Samuel Fajreldines es el autor responsable de este artículo. La investigación comparó la documentación actual del OpenAI Agents SDK, OpenAI Agents API, Microsoft Agent Framework, OpenTelemetry y OWASP con discusiones públicas recientes y el cluster existente del sitio. El contrato de eventos y la lista de verificación son una síntesis editorial. El código TypeScript es ilustrativo y no se ejecutó contra un agente ni contra un backend de auditoría. La asistencia de IA apoyó el descubrimiento, la redacción, la generación de la imagen, la localización y la revisión de consistencia; no aportó experiencia de producción ni sustituyó la verificación de las fuentes. El autor también usa RemoteCode como herramienta de trabajo.
Fuentes consultadas
- OpenAI Agents SDK, “Tracing”, consultado el 01/10/2026
- OpenAI API, “Agents API tracing”, consultado el 01/10/2026
- Microsoft, “Agent Framework observability”, consultado el 01/10/2026
- OpenTelemetry, “Generative AI semantic conventions”, consultado el 01/10/2026
- OWASP GenAI Security Project, “Securing Agentic Applications Guide”, consultado el 01/10/2026
- Obot, “What to log when an agent calls a tool”, consultado el 01/10/2026