El despliegue termina en verde, pero la primera petición devuelve un error. En otro caso, el contenedor está vivo y espera a que se recupere una base de datos, mientras una probe de liveness reinicia la instancia antes de que pueda recuperarse. “Health check” dice muy poco cuando la decisión configurada es la equivocada.
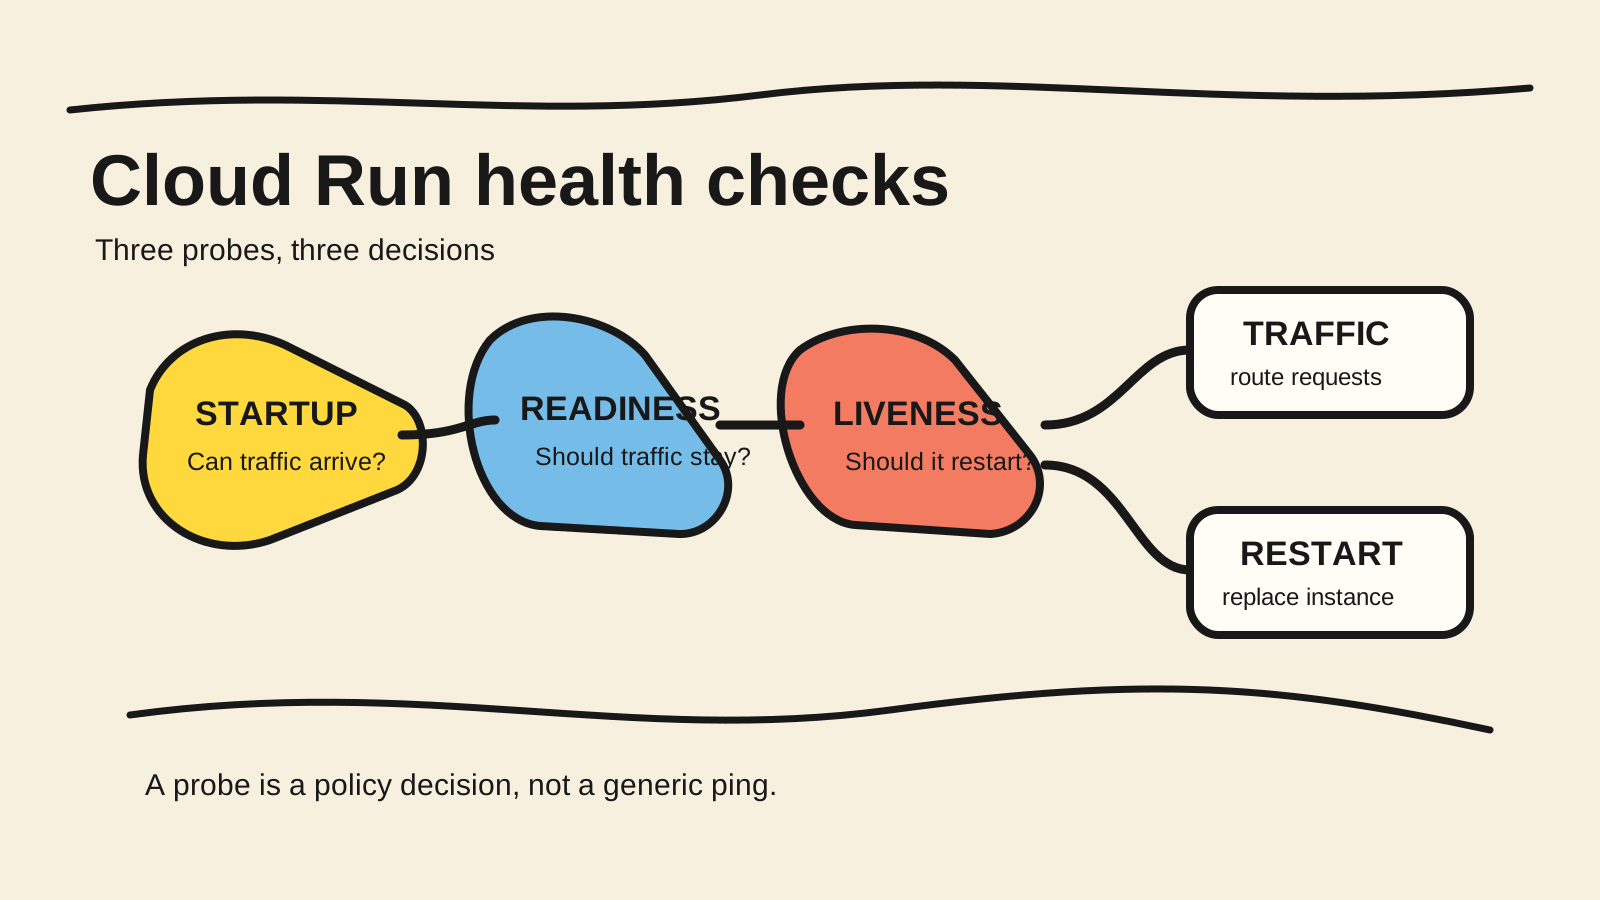
En Cloud Run, startup, readiness y liveness responden a preguntas distintas. Startup decide cuándo el contenedor puede recibir tráfico. Readiness decide si una instancia debe seguir recibiendo tráfico. Liveness decide si una instancia que ya no progresa necesita reiniciarse. Elige la probe por el estado que protege, no por el nombre del endpoint.
Este artículo convierte esa diferencia en una matriz de diagnóstico, un endpoint ilustrativo en Node.js y una configuración pequeña para revisar. No desplegué un servicio de Cloud Run para escribirlo. Los comandos y el YAML son ejemplos que debes adaptar y verificar en el proyecto real.
Respuesta breve
- Usa startup para proteger la inicialización y evitar que una liveness temprana mate el contenedor.
- Usa readiness para sacar una instancia del tráfico sin tratarla como muerta.
- Usa liveness para detectar un proceso que ya no puede avanzar, como un deadlock.
- No hagas que liveness dependa de cada base de datos, cola o API externa sin definir qué corrige realmente un reinicio.
¿Qué decide cada probe en Cloud Run?
En 2026, Google Cloud, “Configure container health checks for services”, consultado el 30/09/2026, separa las tres probes por su consecuencia operativa. Startup controla el paso a recibir tráfico, readiness controla las peticiones nuevas y liveness puede terminar una instancia para que otra arranque.
| Probe | Pregunta | Fallo típico | Consecuencia |
|---|---|---|---|
| Startup | ¿El proceso terminó una inicialización segura? | puerto cerrado, imports incompletos, configuración obligatoria ausente | el contenedor no se libera y puede detenerse |
| Readiness | ¿Esta instancia debe recibir tráfico ahora? | modo de drenaje, dependencia temporalmente indisponible | Cloud Run deja de enviar tráfico nuevo |
| Liveness | ¿El proceso todavía puede avanzar? | deadlock o bucle sin progreso | el contenedor puede reiniciarse |
Los nombres no son intercambiables. Una aplicación puede estar viva y todavía no estar lista. También puede estar lista para responder y quedarse bloqueada horas después. Si un endpoint devuelve 200 para todos los estados, la plataforma pierde la información que debería guiar la acción.
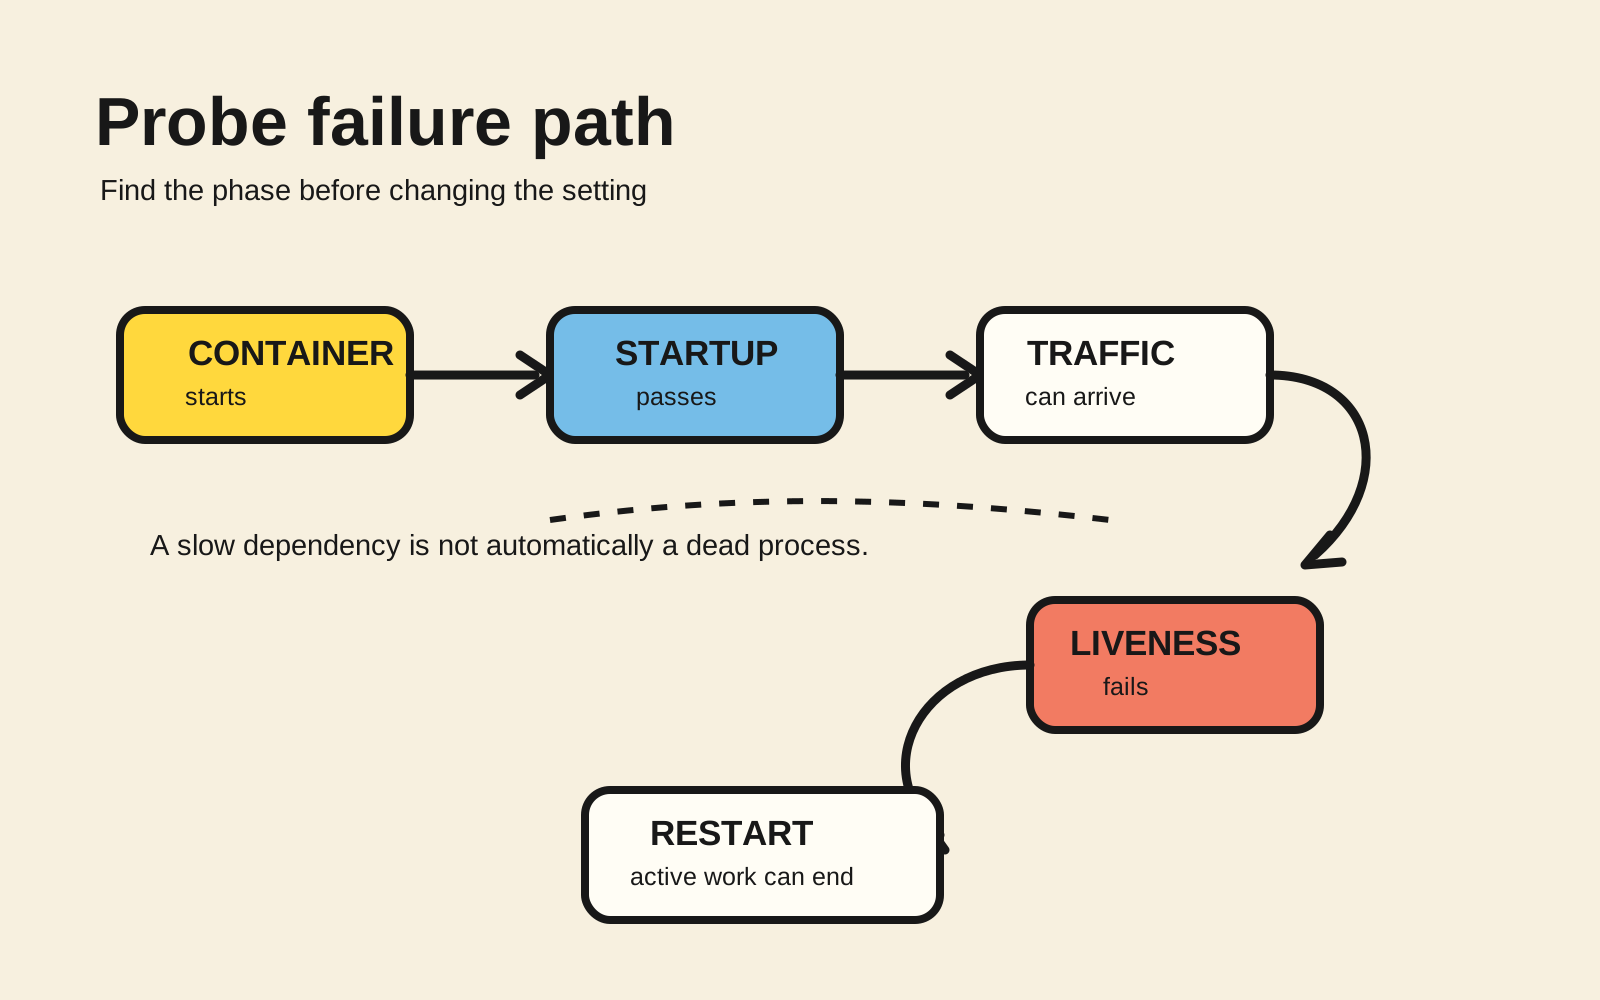
Cloud Run trata startup de forma especial: cuando está configurada, las comprobaciones de liveness y readiness permanecen desactivadas hasta que startup pasa. La documentación de Google Cloud también recomienda que startup demuestre una condición suficiente para recibir tráfico, porque una instancia puede recibir una petición antes de que termine su primera comprobación de readiness.
¿Por qué startup debe ir antes que liveness?
Un proceso lento no es automáticamente un proceso bloqueado. Si la aplicación carga un modelo, restaura configuración o abre conexiones antes de servir, startup debe representar ese punto de disponibilidad. Una liveness demasiado agresiva durante la inicialización puede crear un ciclo en el que el contenedor se reinicia antes de completar el trabajo.
La comprobación TCP de startup de Cloud Run verifica que el proceso abrió su puerto. En la documentación actual, cuando no configuras una startup probe, el servicio recibe una configuración TCP con timeoutSeconds: 240, periodSeconds: 240 y failureThreshold: 1 (Google Cloud, “Configure container health checks for services”, consultada el 30/09/2026). Ese valor confirma el puerto, no la disponibilidad de cada dependencia.
Para una aplicación que necesita una condición más fuerte, usa HTTP o gRPC. Una startup probe HTTP considera éxito una respuesta 2xx o 3xx. Cualquier otra respuesta falla. El endpoint debe usar HTTP/1 y la ruta configurada debe existir en el contenedor. Una respuesta positiva debe significar que la instancia puede servir tráfico de forma segura, no solo que el proceso abrió un socket.
¿Cómo diseñar endpoints sin crear un bucle de reinicios?
El endpoint de liveness debe ser barato y local. Tiene que detectar un estado que un reinicio pueda corregir. Si consulta la base de datos en cada llamada y la base de datos queda indisponible, todas las instancias pueden parecer muertas al mismo tiempo. El sistema convierte un fallo de dependencia en una cola de reinicios.
Un servidor de Node.js puede separar los estados. El siguiente ejemplo es ilustrativo y no usa un framework específico:
import http from 'node:http';

let started = false;
let acceptingTraffic = false;
let stuck = false;

const server = http.createServer((request, response) => {
  if (request.url === '/startup') {
    response.statusCode = started ? 204 : 503;
  } else if (request.url === '/ready') {
    response.statusCode = acceptingTraffic ? 204 : 503;
  } else if (request.url === '/live') {
    response.statusCode = stuck ? 503 : 204;
  } else {
    response.statusCode = 404;
  }

  response.end();
});

server.listen(process.env.PORT || 8080, '0.0.0.0', () => {
  started = true;
  acceptingTraffic = true;
});
El ejemplo muestra la separación, no una política lista para producción. En un servicio real, started debe cambiar después de la inicialización que exige el tráfico. acceptingTraffic debe cambiar durante el drenaje y la recuperación. stuck debe representar una condición que el proceso no puede reparar por sí mismo. No devuelvas detalles internos ni credenciales en el cuerpo de la respuesta.
Google Cloud indica que los endpoints HTTP de health check son accesibles externamente y siguen los mismos principios que cualquier endpoint expuesto. Mantén la respuesta mínima, no dependas de un secreto escondido en la ruta y usa headers configurables solo cuando el diseño realmente los necesite. El endpoint no debe convertirse en un informe público de la arquitectura.
¿Cuándo conviene usar TCP, HTTP o gRPC?
TCP demuestra solo que un socket acepta una conexión. Es un comienzo razonable para un proceso sencillo, pero no sabe si el enrutamiento interno, la configuración necesaria o el estado de la aplicación terminaron de cargarse. Cloud Run admite TCP, HTTP y gRPC para startup; también documenta formas HTTP y gRPC para liveness y readiness.
HTTP funciona cuando la decisión cabe en un endpoint pequeño. Permite distinguir 204 de 503, expresar una regla clara y probarla localmente con curl. No uses la ruta principal como probe si lee datos, exige autenticación de usuario o produce efectos secundarios.
gRPC tiene sentido cuando el servicio ya implementa el protocolo de health checking. La configuración debe apuntar al puerto correcto y, cuando corresponda, al servicio gRPC correcto. No añadas gRPC solo para llamar a la misma dependencia de otra forma. La probe debe seguir siendo barata y determinista.
El tipo de probe no arregla una configuración equivocada. Un puerto distinto del que escucha el proceso, una ruta inexistente o un timeout menor que el tiempo de arranque producen fallos que parecen indisponibilidad de la aplicación. Comprueba primero la interfaz que el contenedor expone realmente.
¿Cómo configurar y verificar una revisión?
La configuración crea una nueva revisión del servicio. Usa YAML, Terraform o la CLI de Google Cloud, pero mantén el ejemplo lo bastante pequeño para revisarlo en el diff. Esta versión ilustra una startup HTTP y una liveness HTTP:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: example-service
spec:
  template:
    spec:
      containers:
        - image: REGION-docker.pkg.dev/PROJECT/REPOSITORY/IMAGE:TAG
          ports:
            - containerPort: 8080
          startupProbe:
            httpGet:
              path: /startup
              port: 8080
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 12
          livenessProbe:
            httpGet:
              path: /live
              port: 8080
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 3
Estos valores no son una recomendación universal. Hacen explícitas las preguntas del ejemplo. Cloud Run limita el timeout al periodo configurado y documenta 3 como failureThreshold predeterminado para probes configuradas. Ajusta los valores al arranque que observes y al coste de terminar una instancia que todavía atiende peticiones.
Después del despliegue, inspecciona la revisión y los logs del contenedor. Confirma el nombre de la revisión, la imagen, el puerto, la ruta, los eventos de fallo de la probe y el momento en que startup pasó. Prueba los endpoints localmente antes de buscar una causa en Cloud Run:
curl -i http://localhost:8080/startup
curl -i http://localhost:8080/live
En producción, un 503 de liveness puede terminar peticiones que todavía se estaban atendiendo. La referencia de Google Cloud describe ese efecto y el inicio de una nueva instancia después de la terminación. Provoca el primer fallo en una revisión sin tráfico crítico y confirma que el resultado observado coincide con el contrato que querías probar.
¿Qué fallos deben entrar en la prueba?
Prueba cada transición que cambia la acción de la plataforma. Una suite pequeña resulta más útil cuando cada caso tiene una expectativa explícita:
| Escenario | Simular | Resultado esperado |
|---|---|---|
| inicialización lenta | retrasar started más allá del primer intento |
startup sigue fallando hasta que exista la condición |
| ruta equivocada | configurar /health y servir solo /live |
la revisión muestra la incompatibilidad |
| puerto equivocado | escuchar fuera del puerto configurado | startup TCP o HTTP no pasa |
| dependencia caída | hacer fallar la base de datos sin bloquear el proceso | readiness puede retirar tráfico; liveness no reinicia sin motivo |
| deadlock | mantener vivo el proceso, pero detener el progreso | liveness falla y el reinicio se puede observar |
| drenaje | poner acceptingTraffic en false |
readiness deja de enviar tráfico nuevo |
La prueba de deadlock debe demostrar que el reinicio ayuda. Si la causa es una configuración persistida o una base de datos indisponible, una nueva instancia no la arreglará. En ese caso, la recuperación y la alerta deben apuntar a la dependencia, en vez de esconder el evento en reinicios repetidos.
¿Qué no demuestra un health check?
Una probe demuestra solo la condición que codificaste. Un 204 en /live no confirma que la consulta principal sea correcta, que haya mensajes en la cola, que funcionen las credenciales o que los usuarios puedan terminar una operación. Una readiness que retira tráfico tampoco repara el estado que causó el fallo.
La guía general sobre health checks en Google Cloud y AWS cubre los papeles de monitorización, uptime y balanceador. En Cloud Run, la probe interna es solo una capa. Añade métricas, logs, trazas y una comprobación externa cuando la pregunta sea “¿puede un usuario completar el flujo?”.
No mezcles una probe del servicio con la capacidad. Cómo elegir la concurrencia de Cloud Run cubre cuántas peticiones puede sostener una instancia. Un servicio puede estar listo para recibir tráfico y aun así volverse lento con mucha concurrencia. La comparación de cold starts en Cloud Run cubre otro punto de la espera. Si un reinicio interrumpe trabajo activo, consulta cómo manejar SIGTERM en Cloud Run antes de elegir liveness.
Preguntas frecuentes
¿Readiness y liveness son lo mismo en Cloud Run?
No. Readiness controla si una instancia debe seguir recibiendo tráfico. Liveness indica que la instancia necesita reiniciarse. En la documentación consultada el 30/09/2026, readiness aparece como Preview y un fallo puede retirar tráfico sin terminar la instancia, mientras que liveness puede terminarla después de fallos repetidos (Google Cloud, “Configure container health checks for services”).
¿Puedo poner una consulta a la base de datos en liveness?
Solo si el contrato demuestra que reiniciar la instancia corrige el fallo. Si la base de datos está caída, todas las instancias pueden fallar a la vez y entrar en un bucle de reinicios. En general, mantén liveness local y usa readiness, métricas y alertas para dependencias externas. El diseño correcto depende del estado que la aplicación pueda reparar.
¿Startup sustituye a readiness?
No por completo. Startup define cuándo la instancia terminó de inicializarse y puede empezar a recibir tráfico. Readiness puede retirar tráfico más tarde y permitir que la instancia vuelva cuando su estado mejore. Cloud Run recomienda que startup sea suficiente para recibir tráfico porque una petición puede llegar antes de que termine la primera comprobación de readiness.
Conclusión
Elige la probe por la acción que debe provocar un fallo. Startup protege la entrada al servicio. Readiness controla la participación temporal en el tráfico. Liveness reinicia un proceso que ya no puede avanzar. Un endpoint con tres nombres distintos no crea esas decisiones por sí solo.
Configura una revisión pequeña, prueba el puerto y la ruta, simula un arranque lento, elimina una dependencia y crea un estado sin progreso. Si un reinicio no arregla la causa, no lo conviertas en liveness. Un buen health check da a la plataforma una decisión segura, en vez de devolver verde para todo.
Cómo se hizo este análisis
Samuel Fajreldines es el autor responsable de este artículo. La investigación comparó la documentación actual de Google Cloud sobre health checks y el contrato de contenedores, la documentación de Kubernetes sobre la semántica de las probes, los artículos existentes del sitio y discusiones públicas recientes de troubleshooting. No hubo despliegue ni benchmark de Cloud Run. El código y el YAML son ilustrativos. La asistencia de IA apoyó el descubrimiento, la redacción, la generación de imágenes y la revisión de consistencia, pero no ejecutó la configuración ni sustituyó la verificación de fuentes.
Fuentes consultadas
- Google Cloud, “Configure container health checks for services”, consultado el 2026-09-30
- Google Cloud, “Configure container health checks for instances”, consultado el 2026-09-30
- Google Cloud, “Container runtime contract”, consultado el 2026-09-30
- Kubernetes, “Configure liveness, readiness and startup probes”, consultado el 2026-09-30
- Node.js, “HTTP”, consultado el 2026-09-30