El pedido se guardó, pero el evento que debía reservar el inventario nunca llegó al broker. El proceso se cayó entre COMMIT y la llamada de publicación. Si inviertes el orden, puedes anunciar un pedido que después falla en la base de datos.
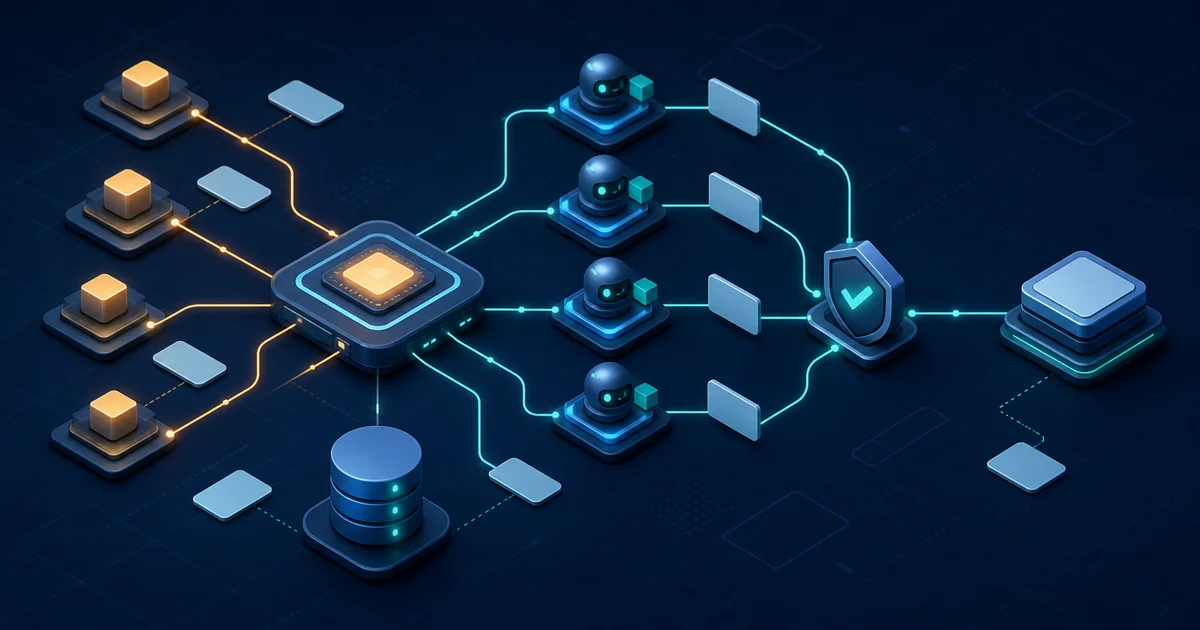
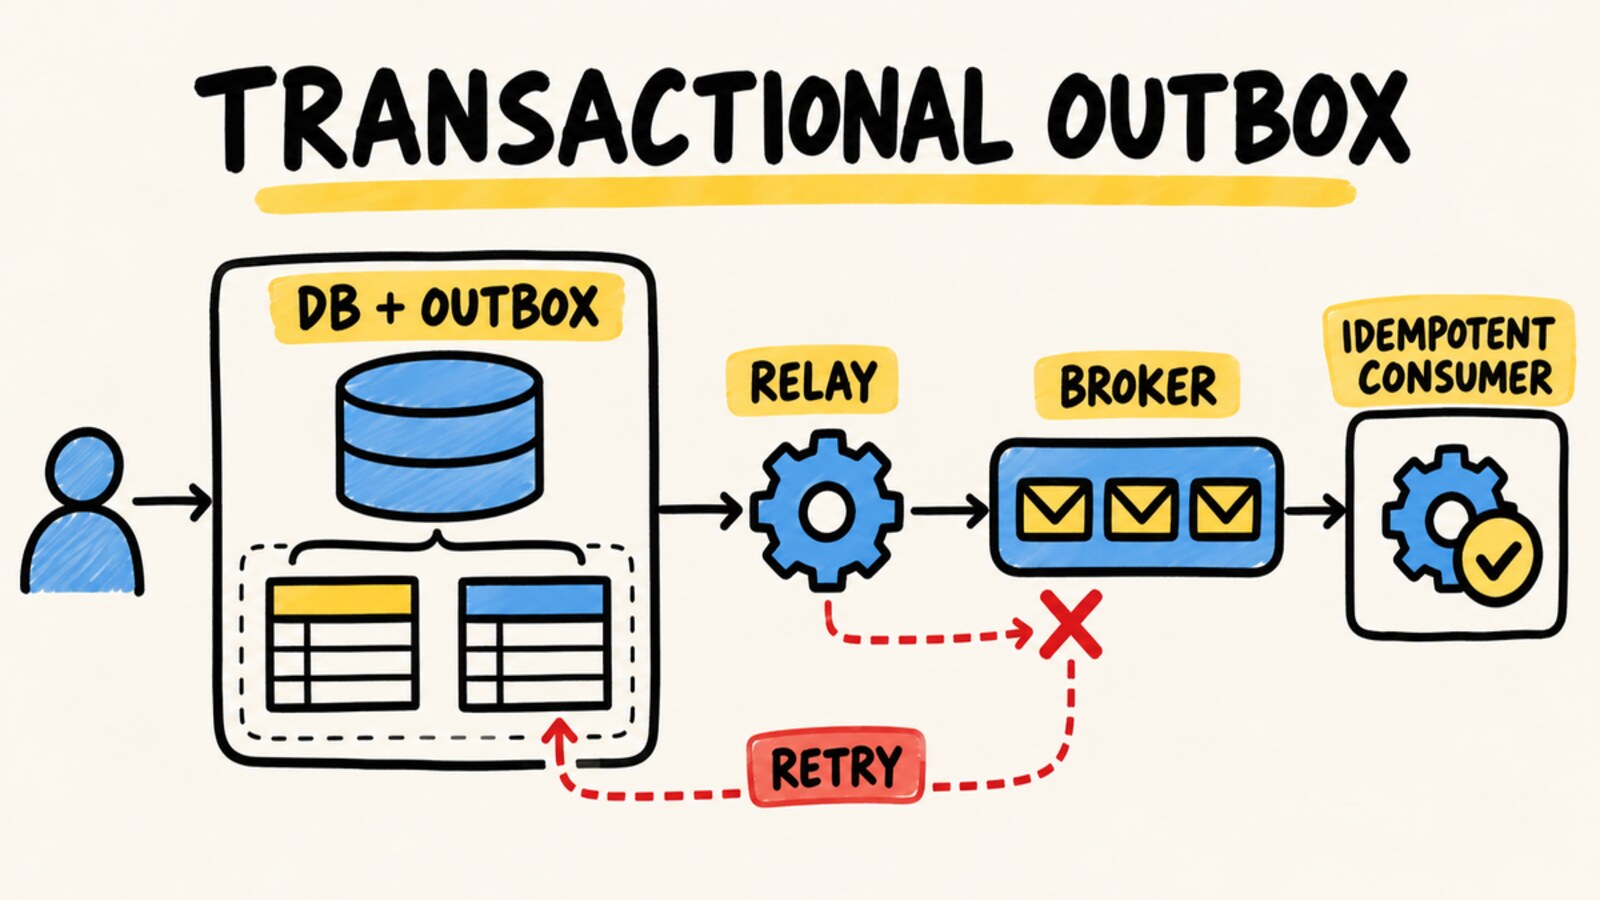
El patrón outbox transaccional cierra esa ventana al guardar el cambio de negocio y el evento en una sola transacción local. Después del commit, un relay lee las filas pendientes del outbox y las publica. La publicación todavía puede fallar o suceder dos veces, por lo que el diseño necesita reintentos, observabilidad y un consumidor idempotente.
Este artículo es un spoke de la ejecución durable para agentes de IA con checkpoints, colas y workflows. El patrón también sirve para APIs y servicios normales. En un runtime de agentes, la misma frontera aparece cuando una transición confirmada debe despertar una tarea, emitir un evento de auditoría o iniciar trabajo fuera del proceso actual. El outbox no convierte la llamada externa en parte de la transacción de la base de datos.
Conclusiones clave
- Guarda el registro de negocio y el mensaje del outbox en la misma transacción de la base de datos.
- Publica después del commit mediante polling o CDC y conserva la fila hasta que el relay acepte la entrega.
- Trata los duplicados como algo normal: el relay puede caerse después de publicar y antes de registrar el éxito.
- Haz que los consumidores dedupliquen con un ID estable y conserva el orden solo donde el dominio realmente lo necesite.
- Prefiere una transacción local sencilla cuando no exista una segunda obligación de publicación.
El problema es una doble escritura
Piensa en esta API de pedidos:
const order = await saveOrder(input);
await broker.publish("OrderPlaced", order);
return order;
Si saveOrder hace commit y el proceso se cae antes de publish, la base de datos conoce el pedido, pero el inventario, el correo o una proyección downstream nunca reciben la notificación. Si inviertes las llamadas, el evento puede llegar mientras el registro no existe. Un reintento no resuelve el problema por sí solo: un timeout puede ocultar una publicación que el broker ya aceptó.
AWS Prescriptive Guidance describe este caso como una operación de escritura en dos sistemas. Su solución es guardar el evento junto con la actualización y usar un proceso separado para enviarlo. La referencia del patrón Transactional Outbox de microservices.io marca la misma frontera: la transacción local confirma la obligación y el relay se encarga de la comunicación posterior.
Esto no es una promesa de entrega exactamente una vez. Evita que la obligación de publicar exista solo en la memoria del proceso.
¿Cuándo vale la pena el outbox?
Usa el patrón cuando un cambio local confirmado debe causar trabajo asíncrono en otro sistema y perder esa notificación dejaría estados inconsistentes. Por ejemplo:
| Situación | Primera decisión |
|---|---|
| Actualizar una tabla y llamar a un broker después | Considera un outbox en la misma transacción |
| Guardar una preferencia sin ninguna notificación downstream | Una transacción local suele ser suficiente |
| Crear una tarea de agente después de guardar una aprobación | Un outbox puede registrar la obligación de iniciar la tarea |
| Actualizar varias bases de datos como si fueran una sola transacción | El outbox no coordina commits entre servicios; evalúa una saga u otro diseño de coordinación |
| Enviar un correo después del commit | El outbox puede proteger la intención de entrega, pero el proveedor de correo aún necesita idempotencia o un recibo seguro |
El coste es real. Ahora operas una tabla, un relay, reintentos, retención, métricas y una política para los mensajes que no avanzan. Si la operación puede seguir siendo síncrona dentro de una sola base de datos, añadir un broker y un relay puede sumar piezas sin resolver un fallo real.
¿Qué debe confirmarse junto?
La unidad atómica debe contener el estado que necesitan los lectores downstream y la obligación de publicar el cambio. La documentación de COMMIT de PostgreSQL indica que los cambios se vuelven visibles y durables cuando el comando termina con éxito (documentación de PostgreSQL sobre COMMIT). La forma exacta depende de la base de datos y del driver, pero la idea es esta:
-- Forma ilustrativa. Adapta tipos, constraints y cliente a tu base de datos.
CREATE TABLE outbox_events (
  id uuid PRIMARY KEY,
  aggregate_type text NOT NULL,
  aggregate_id text NOT NULL,
  event_type text NOT NULL,
  payload jsonb NOT NULL,
  created_at timestamptz NOT NULL,
  published_at timestamptz,
  attempts integer NOT NULL DEFAULT 0,
  last_error text
);

BEGIN;

UPDATE orders
SET status = 'placed'
WHERE id = 'order-42';

INSERT INTO outbox_events
  (id, aggregate_type, aggregate_id, event_type, payload, created_at)
VALUES
  ('event-42', 'order', 'order-42', 'OrderPlaced', '{"orderId":"order-42"}', now());

COMMIT;
El UPDATE y el INSERT deben fallar o confirmarse juntos. Si la transacción hace rollback, el relay no debería encontrar una obligación fantasma. Si hace commit, la fila del outbox necesita un ID estable, tipo de evento, clave del agregado, payload e información suficiente para diagnosticar los intentos.
No escribas el outbox por accidente mediante otra conexión. Eso recrea la doble escritura: el pedido puede confirmarse mientras falla la fila del evento, o al revés. Pasa el mismo contexto transaccional al código que guarda la entidad y al código que registra el evento.
El relay publica después del commit
El relay es un worker, no una parte invisible de la transacción. Encuentra filas elegibles, reclama un lote, publica en el broker y registra el resultado. Si la publicación falla, conserva la fila, registra el error y programa otro intento. Si el proceso muere después de que el broker acepta el mensaje pero antes de escribir published_at, la misma fila puede volver a intentarse.
Con varios relays, la tabla necesita una política de claim. En PostgreSQL, FOR UPDATE SKIP LOCKED puede evitar que los workers esperen por las mismas filas, pero la documentación advierte que el resultado no es una vista consistente y que esta opción sirve para tablas parecidas a colas, no para consultas generales (cláusulas de locking de PostgreSQL). El claim también necesita un lease o una ruta de recuperación cuando un worker desaparece durante la publicación.
Hay dos familias comunes de relay:
- Polling publisher: los workers consultan la tabla en intervalos o reciben una señal para despertarse. Es fácil de entender, pero necesita índices, límites de lote, backoff y una política que evite convertir la base de datos de negocio en el cuello de botella.
- Change data capture: una herramienta captura la fila insertada y la envía al broker. El Outbox Event Router de Debezium, por ejemplo, captura cambios de una tabla outbox y enruta eventos usando campos de la fila. CDC reduce el polling de la aplicación, pero añade configuración, operación y una dependencia de captura.
Elige según la carga, la latencia aceptable, la capacidad operativa, el orden necesario y la recuperación. No existe una cifra universal de throughput que indique cuándo sustituir polling por CDC.
Los duplicados y el orden siguen siendo responsabilidad del diseño
El relay no debería borrar una fila antes de una publicación aceptada. Incluso después de marcar un evento como publicado, el proceso puede morir entre el broker y la base de datos. Por eso AWS recomienda consumidores idempotentes para los mensajes duplicados, y el patrón de microservices.io trata la publicación duplicada como una posibilidad normal del relay.
El consumidor puede usar el ID del evento en una tabla de inbox con una constraint única, o hacer que la operación de negocio sea idempotente. Lo importante es que la comprobación y el efecto no creen otra carrera. Un SELECT separado seguido de un INSERT no te protege si llegan dos entregas juntas. Usa una constraint o una transacción adecuada para la base de datos.
El orden también necesita un alcance. AWS advierte que los eventos deben seguir el orden de las actualizaciones del servicio cuando el dominio lo requiera. Eso no significa que todos los mensajes de todos los agregados necesiten una cola global. Elige una clave de orden por agregado, partición o workflow y documenta qué hace el consumidor con un evento tardío.
Cómo verificar el contrato antes de operarlo
Un outbox no está listo solo porque exista la tabla. Comprueba los fallos que atraviesan todo el proceso:
- Rollback: fuerza un fallo después de insertar la entidad y el evento. Ninguna de las dos filas debería quedar confirmada.
- Relay no disponible: confirma que el estado local sigue siendo recuperable y que la fila permanece cuando el broker rechaza la conexión.
- Timeout ambiguo: simula una publicación aceptada seguida de un error del relay. El consumidor debe tolerar la segunda entrega.
- Dos workers: haz que dos relays compitan por el mismo lote y confirma que claim, lease y actualización final no hacen desaparecer un evento.
- Orden por agregado: guarda dos transiciones del mismo pedido y comprueba el orden que ve el consumidor. Prueba agregados distintos por separado.
- Mensaje venenoso: registra intentos, error y suficiente payload para investigar. Después de un límite, mueve el mensaje a una cuarentena operable, como la dead-letter queue para tareas de agentes de IA que fallan.
Esto complementa las pruebas de idempotencia de una API sin duplicar efectos y las pruebas de webhooks con firmas, duplicados y reintentos. Ejercitan fronteras distintas: el outbox protege la obligación de publicar, mientras que el consumidor y la API protegen el efecto de recibir o repetir una petición.
Lo que el outbox no resuelve
El patrón no hace que una base de datos y un broker participen en una sola transacción distribuida. Tampoco deshace automáticamente un efecto externo que ya fue aceptado, hace que los consumidores sean rápidos ni elimina la necesidad de métricas, retención y replay.
Si varios servicios deben completar una transacción de negocio, cada servicio sigue teniendo sus propios cambios y fallos. Una saga puede coordinar esos pasos con acciones compensatorias, pero esa es una decisión distinta de publicar de forma fiable un evento local.
Para un agente, registra también el ID de la ejecución, el ID de la acción y la versión del contrato que produjo el evento. Uso RemoteCode como herramienta propia para este tipo de flujo. Así puedes conectar un cambio confirmado con el trabajo que inició el relay sin poner prompts ni secretos en el payload de integración.
Usa este criterio: si perder la notificación después del commit deja un estado que nadie puede reconstruir, persiste la obligación de publicar en la misma transacción. Después trata el relay, los duplicados, el orden y la recuperación como partes visibles del sistema.
Fuentes
- AWS Prescriptive Guidance, "Transactional outbox pattern", consultado el 31 de octubre de 2026.
- microservices.io, "Pattern: Transactional outbox", consultado el 31 de octubre de 2026.
- PostgreSQL, "COMMIT", consultado el 31 de octubre de 2026.
- PostgreSQL, "SELECT: locking clause", consultado el 31 de octubre de 2026.
- Debezium, "Outbox Event Router", consultado el 31 de octubre de 2026.
- Microsoft Learn, "Idempotent Consumer pattern", consultado el 31 de octubre de 2026.