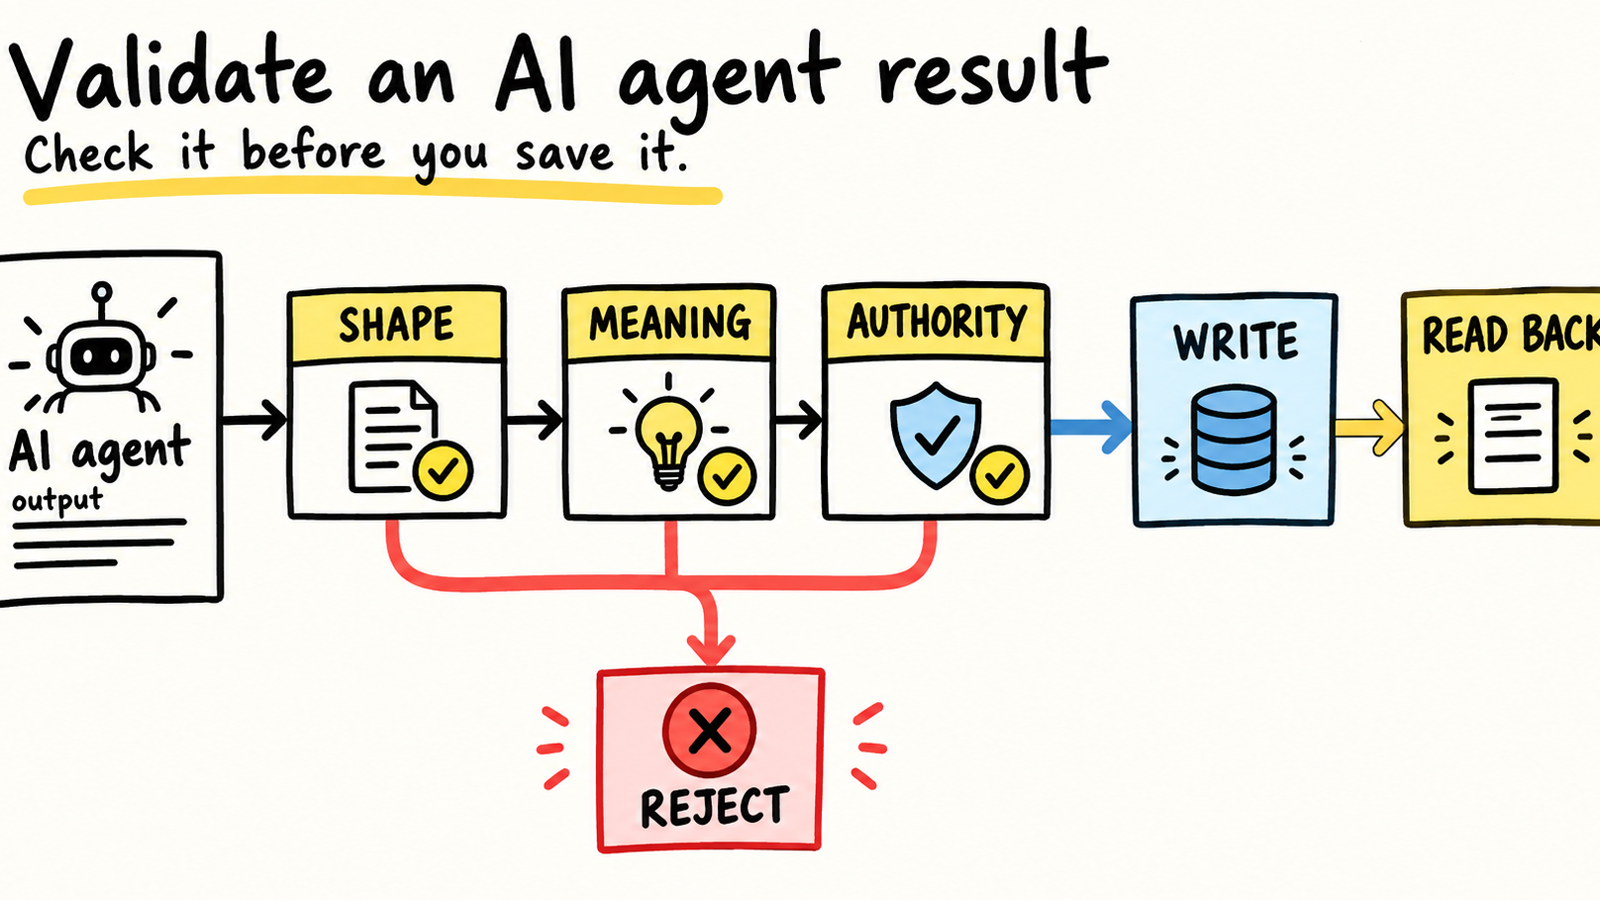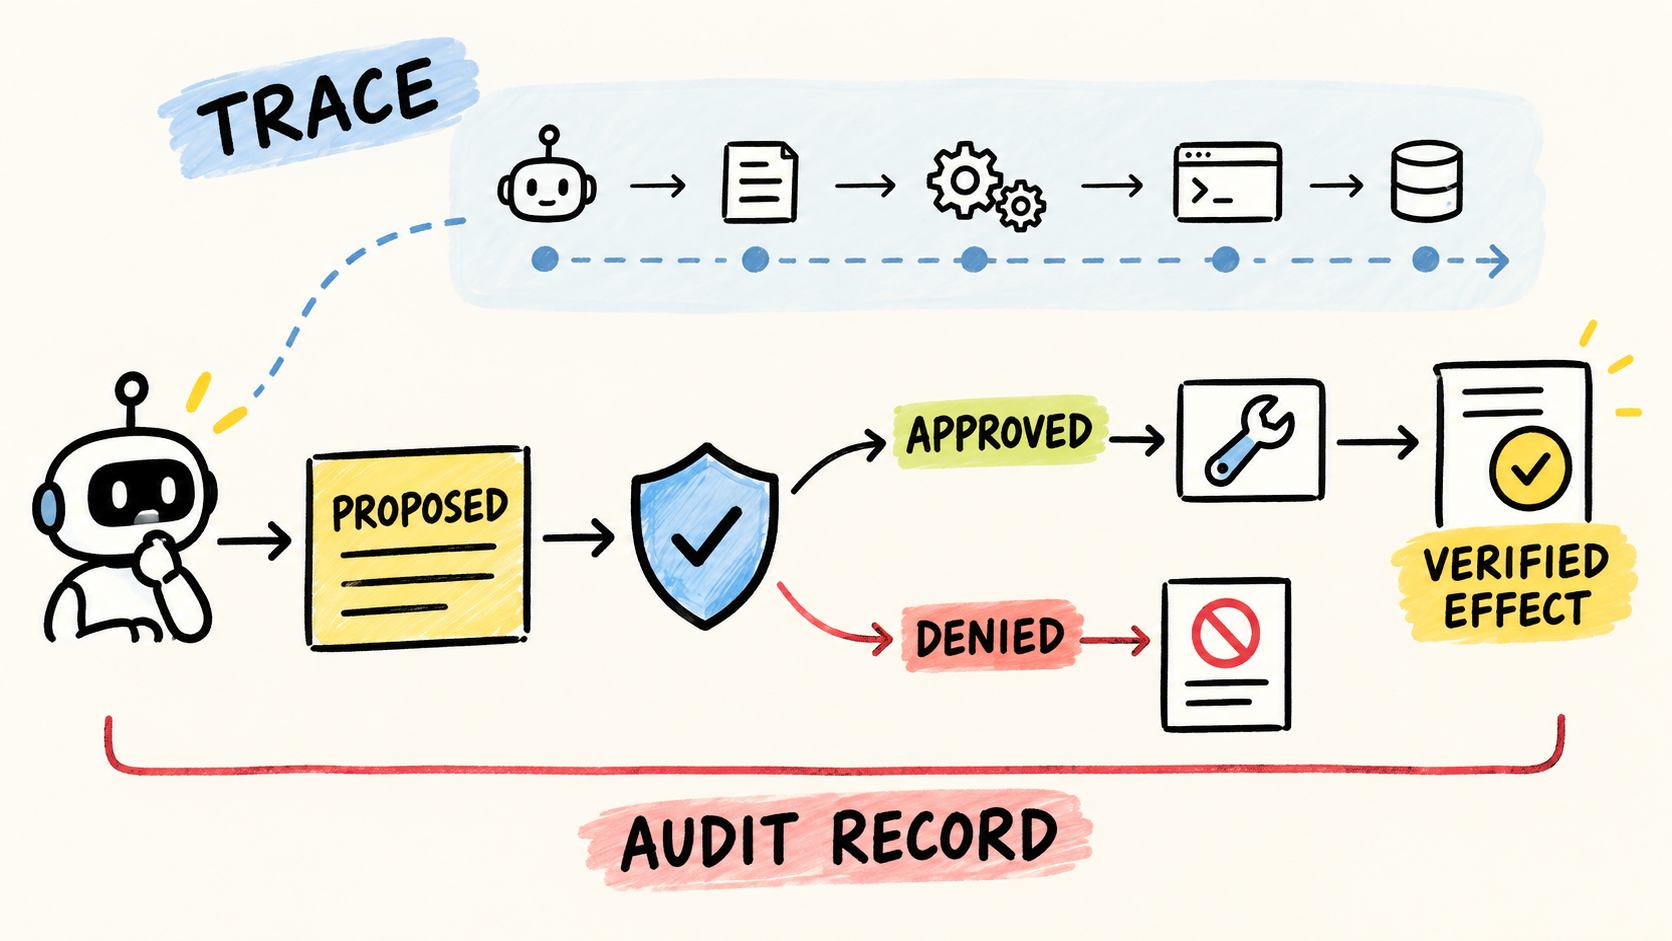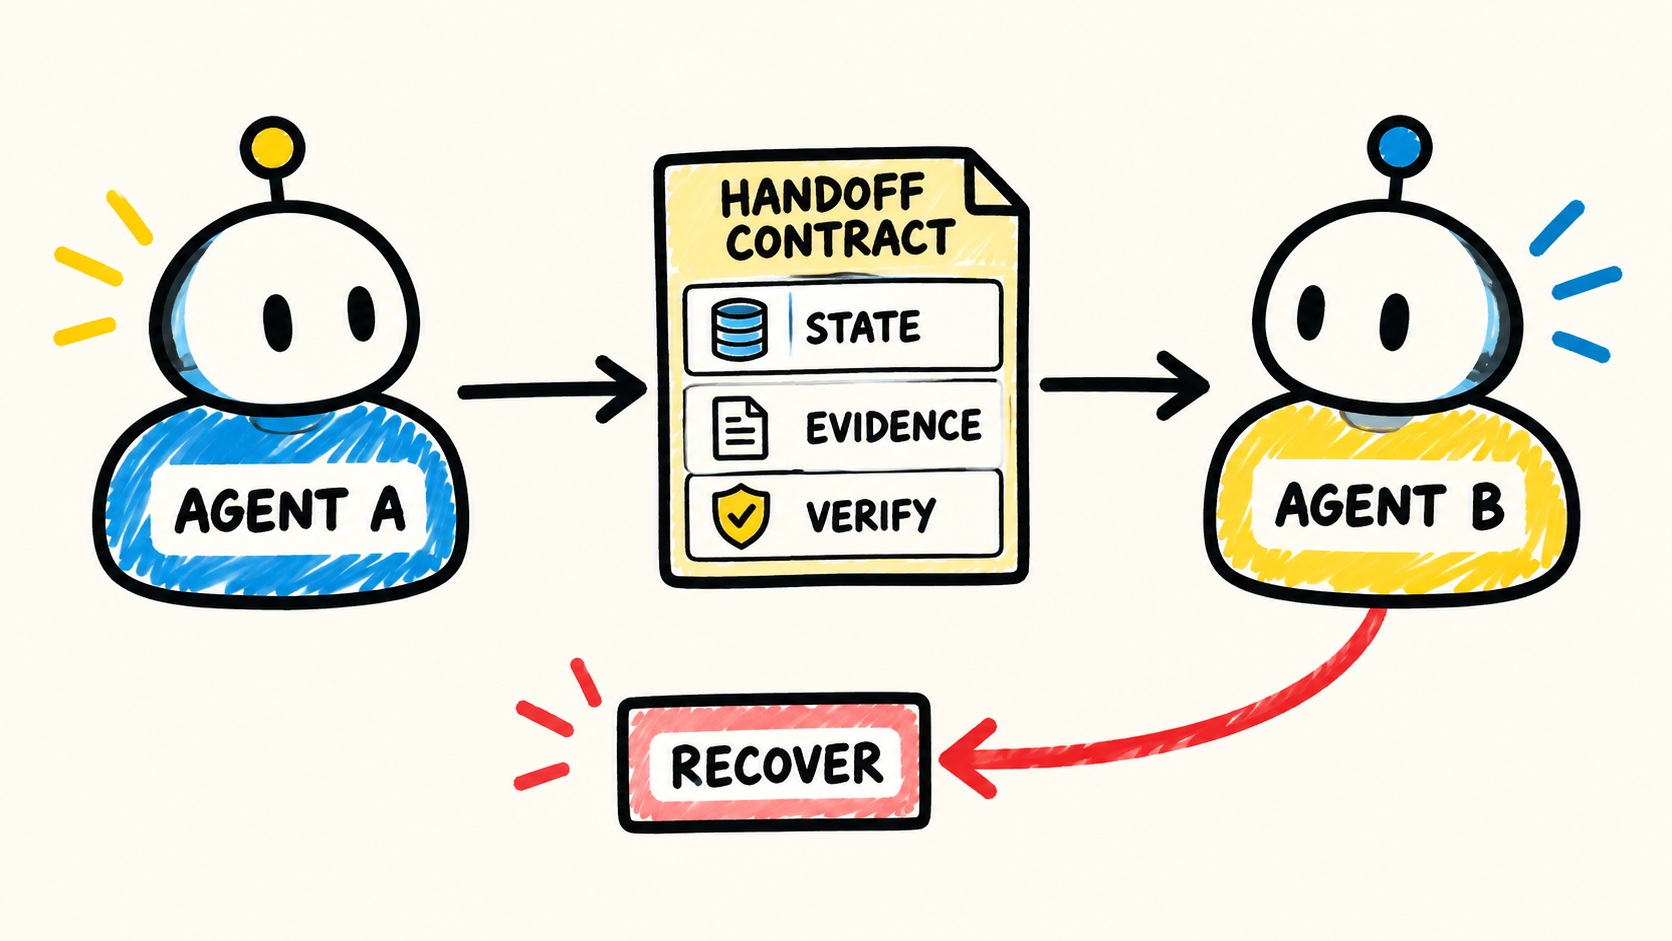
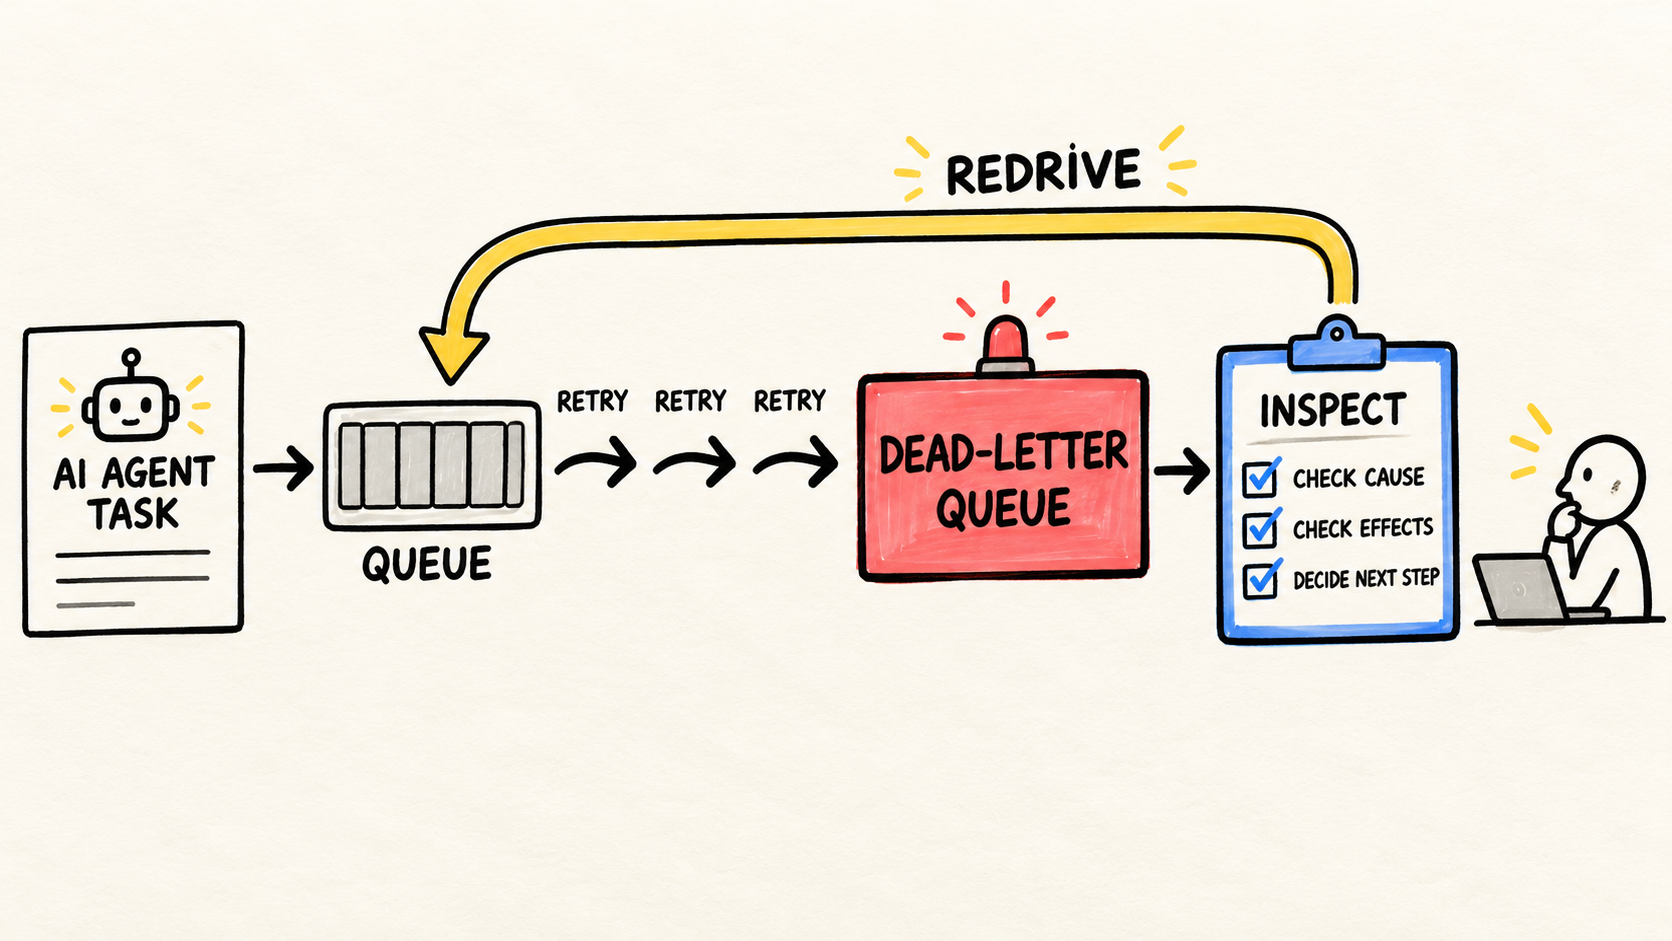
Una tarea de un agente de IA falla, vuelve a la cola y falla otra vez. Entonces el worker puede repetir la misma llamada, descartar el mensaje o dejar que alguien descubra el problema demasiado tarde. El mayor riesgo es no saber si un intento anterior ya cambió un sistema externo.
Cuando una tarea alcanza su límite de reintentos, muévela a una dead-letter queue (DLQ) y conserva la evidencia necesaria para decidir. Una DLQ no debe ser un montón de mensajes olvidados. Es un estado de cuarentena: una persona o una política explícita decide si la tarea se corrige, se reanuda, se compensa o se rechaza.
Esto complementa la ejecución durable para agentes de IA con colas y workflows. La ejecución durable conserva el progreso y los checkpoints. La DLQ organiza qué hacer cuando ese progreso no puede continuar con seguridad.
Respuesta corta
- Define límites de reintentos para la tarea y para el worker.
- Separa el fallo transitorio, el fallo permanente y el efecto externo incierto.
- Cuando se agote el presupuesto, registra la tarea, la causa, los intentos, el checkpoint y los posibles efectos en una DLQ.
- Haz redrive solo después de revisar la causa y la idempotencia de la operación.
- Si repetir no es demostrablemente seguro, envía la tarea a reparación, compensación o revisión humana.
¿Qué resuelve una dead-letter queue para un agente de IA?
Una DLQ da un destino a la tarea que debe salir del camino normal. Evita que un mensaje venenoso consuma reintentos para siempre y evita que el operador reconstruya el incidente a partir de logs separados.
No interpreta el fallo por sí sola. Un broker sabe que la entrega no fue confirmada. No sabe si una herramienta creó un pedido antes de que se cortara la conexión, si el modelo produjo argumentos inválidos o si el estado del negocio cambió parcialmente. Ese significado pertenece al contrato del agente y al sistema que ejecutó la herramienta.
Las bibliotecas de agentes ya ofrecen límites de bucle para una ejecución individual. La documentación de OpenAI Agents JS describe maxTurns y documenta un valor predeterminado de 10; la documentación de Vercel AI SDK documenta 20 pasos predeterminados para ToolLoopAgent. Esos límites terminan una ejecución. No conservan ni investigan la tarea que terminó. El artículo sobre cómo evitar bucles infinitos en un agente cubre el límite dentro del loop; aquí, el foco está en lo que ocurre después. (OpenAI Agents JS, Vercel AI SDK, consultados el 8 de octubre de 2026.)
¿Qué fallos deben ir a la DLQ?
No envíes todas las excepciones por el mismo camino. La política debe separar la posibilidad de que otro intento funcione del riesgo de repetir un efecto peligroso.
| Situación | Ejemplo | Siguiente estado | ¿Redrive automático? |
|---|---|---|---|
| Transitorio sin efecto confirmado | timeout antes de recibir respuesta | reintento con espera | quizá, dentro del presupuesto |
| Permanente sin efecto | schema inválido o herramienta eliminada | DLQ para corregir | no |
| Efecto externo incierto | timeout después de llamar a pagos | DLQ para consultar o compensar | no |
| Límite de política | demasiados pasos o llamadas repetidas | DLQ o cancelación | no |
| Estado recuperable | fallo después de un checkpoint válido | workflow de reanudación | solo con contrato de resume |
Un fallo transitorio no se define únicamente por el código HTTP. El mismo timeout puede ocurrir antes o después de que un servicio externo confirme una mutación. Conserva la posición de la tarea, la clave de idempotencia y el recibo del efecto cuando existan. Sin ellos, el worker convierte la incertidumbre en un duplicado.
La documentación de Temporal distingue errores permanentes y transitorios, y permite marcar errores no reintentables o limitar intentos. La decisión del framework es un dato para tu contrato, no una prueba de que una herramienta concreta sea segura para repetir. (Temporal, políticas de reintento, consultado el 8 de octubre de 2026.)
¿Qué debe contener el registro de la tarea?
El registro de la DLQ debe permitir que un operador decida sin ejecutar el agente a ciegas. Normalmente necesita:
- Identidad:
taskId,runId, tipo de tarea, tenant y clave de idempotencia. - Entrada controlada: referencia al payload o snapshot necesario, sin copiar secretos a la cola.
- Historial: número de intentos, timestamps, versiones del agente y del modelo, versión de la política relevante y nombres de herramientas.
- Causa clasificada: timeout, límite, validación, permisos, dependencia no disponible o efecto incierto.
- Checkpoint y artefactos: último progreso confirmado, salida estructurada, recibo de herramienta y trace relacionado.
- Siguiente acción:
retry,resume,repair,compensate,rejectohuman_review, con responsable y motivo.
No conserves una transcripción completa por defecto. Guarda una referencia a un artefacto protegido y aplica la política de retención del producto. La guía sobre qué registrar en la auditoría de un agente ayuda a separar la evidencia operativa de una conversación que no demuestra el efecto. Los logs detallados también necesitan control de acceso porque un fallo puede contener datos de clientes o argumentos de herramientas.
¿Redrive, resume, reparación o compensación?
No son sinónimos. Redrive crea otro intento desde la cola. Resume continúa desde un checkpoint. Reparar cambia la entrada o la configuración antes de volver a intentar. Compensar revierte o neutraliza un efecto que ya ocurrió.
Usa esta secuencia antes de devolver una tarea a la cola normal:
- Encuentra el límite del fallo. ¿Ocurrió antes de la llamada, durante la llamada o después de una confirmación parcial?
- Consulta el sistema externo. Un timeout no confirma ni niega el éxito. Consulta con la clave de idempotencia, un recibo o una lectura segura.
- Clasifica la causa. Corrige schema, permisos o datos inválidos antes del redrive; no aumentes el límite para esconder el diagnóstico.
- Elige el punto de inicio. Reanuda desde el checkpoint cuando el workflow lo garantice. Haz redrive desde el principio solo si cada efecto es idempotente o si el agente puede demostrar que todavía no ocurrió.
- Registra la decisión. El siguiente operador debe saber por qué la tarea volvió, se compensó o se rechazó.
El contrato para verificar una tool call antes de reintentar cubre el caso más cercano: un resultado incierto de una herramienta. La DLQ amplía esa revisión al momento en que la política de reintentos ya se agotó.
¿Dónde ayudan los proveedores de colas?
La DLQ del proveedor reduce trabajo operativo, pero no crea la semántica de recuperación del agente.
- Amazon SQS envía mensajes a una DLQ cuando se alcanza el
maxReceiveCountconfigurado. AWS recomienda analizar el contenido y configurar alarmas; la retención y el orden dependen de la configuración de la cola. (AWS, dead-letter queues, consultado el 8 de octubre de 2026.) - Google Cloud Pub/Sub reenvía mensajes no entregables a un dead-letter topic y registra los intentos de entrega de forma aproximada. La aplicación aún debe interpretar la tarea y definir el comportamiento de redrive. (Google Cloud, dead-letter topics, consultado el 8 de octubre de 2026.)
En ambos casos, “fue a la DLQ” es un evento de infraestructura. El contrato del agente aún necesita taskId, estado del efecto externo y siguiente acción permitida. No trates el número de entregas del broker como el número completo de turnos, llamadas de herramientas o efectos secundarios.
Un contrato pequeño para decidir
El ejemplo es ilustrativo. No llama a una cola ni decide si un pago es idempotente. Hace explícita la información que la política necesita antes de elegir el siguiente estado.
type NextAction = "retry" | "resume" | "repair" | "compensate" | "reject" | "human_review";

type Failure = {
  attempts: number;
  maxAttempts: number;
  effect: "none_confirmed" | "confirmed" | "unknown";
  checkpoint: boolean;
  retryable: boolean;
  inputFixed: boolean;
};

export function decideNext(failure: Failure): NextAction {
  if (failure.effect === "unknown") return "human_review";
  if (failure.effect === "confirmed") return "compensate";
  if (failure.checkpoint) return "resume";
  if (failure.retryable && failure.attempts < failure.maxAttempts) return "retry";
  if (failure.inputFixed) return "repair";
  return "reject";
}
El contrato queda incompleto si effect siempre se rellena como none_confirmed porque el worker no encontró un recibo. “No encontré confirmación” es distinto de “demostré que no hubo efecto”. Cuando la diferencia importe, usa unknown y detén la tarea. Si el run también pasó por compactación, el checklist de qué conservar en el contexto antes de continuar ayuda a conservar la frontera entre hecho confirmado e hipótesis.
¿Cómo verificar una DLQ antes de liberar un redrive?
Usa fixtures controladas e incluye casos en los que la herramienta pudo ejecutarse. Una matriz mínima debe demostrar que:
- un timeout antes de la llamada puede reintentarse dentro del presupuesto;
- un timeout después de una mutación pasa a
human_reviewo a una consulta de idempotencia; - un error de schema no consume reintentos para siempre;
- un checkpoint válido reanuda el paso correcto sin repetir efectos anteriores;
- un redrive repetido mantiene la misma clave de idempotencia;
- el operador ve causa, versión, artefactos y responsable sin la transcripción completa.
No necesitas un modelo en vivo para demostrar transiciones deterministas. Sí necesitas una prueba de integración controlada cuando la propiedad depende del broker, del sistema externo o de la herramienta. Este artículo no presenta un benchmark ni una prueba de producción: el contrato es una propuesta verificable, no un resultado medido.
Fallos comunes que la DLQ no corrige
Tratar la DLQ como una papelera
Sin un responsable de alertas, la cola solo oculta el fallo. Define retención, alertas, responsable de triage, plazo de respuesta y una salida para las tareas que no pueden redrivearse.
Hacer redrive en lote
Un lote puede mezclar errores de autenticación, datos inválidos y efectos externos inciertos. Haz redrive por clase de causa y conserva el historial de la decisión. Una tarea reparada no demuestra que las demás sean seguras.
Borrar el payload para cumplir la retención
Una retención corta puede eliminar la evidencia necesaria para explicar el incidente. Una retención larga puede aumentar el riesgo de datos. Separa el sobre operativo de los artefactos sensibles y define la regla con seguridad y producto.
Confundir un límite de turnos con recuperación
maxTurns o un límite de pasos evita un bucle local. No explica qué ocurrió con una llamada que perdió su respuesta. Para esa duda necesitas idempotencia, recibo, consulta o revisión.
Preguntas frecuentes
¿Todo fallo de un agente necesita una DLQ?
No. Un fallo demostrablemente transitorio puede reintentarse dentro de un presupuesto. La DLQ es para el trabajo que agotó el camino normal o necesita otra decisión antes de continuar.
¿Una DLQ reemplaza los checkpoints?
No. Un checkpoint indica dónde puede continuar un workflow. Una DLQ explica por qué la tarea salió del camino normal y qué decisión está pendiente. Se complementan.
¿Puedo hacer redrive automáticamente después de corregir la causa?
Solo cuando el contrato demuestra que la nueva ejecución es segura, la causa está corregida y la tarea no tiene un efecto externo incierto. De lo contrario, conserva una revisión explícita y registra la autorización.
¿Cuánto tiempo debe quedarse una tarea en la DLQ?
Depende del riesgo, los acuerdos operativos y la retención de datos. Define el período con el responsable del sistema y conserva los artefactos necesarios para investigar una decisión. No existe un número universal honesto.
Conclusión
Una tarea que falla repetidamente necesita un estado mejor que “inténtalo otra vez”. Una dead-letter queue crea ese estado, pero solo sirve cuando conserva el historial de ejecución, los posibles efectos externos y la siguiente acción autorizada.
Empieza por clasificar fallos, limitar intentos, registrar checkpoints y tratar un efecto desconocido como desconocido. Después, prueba redrive, resume, reparación y compensación con fixtures que ejerciten las transiciones peligrosas. El sistema no necesita eliminar todos los errores. Necesita impedir que un fallo difícil se convierta en un bucle infinito, un mensaje perdido o un duplicado silencioso.
Cómo se produjo este artículo
Samuel Fajreldines es responsable de este artículo. La investigación comparó la documentación actual de OpenAI Agents JS, Vercel AI SDK, AWS, Google Cloud y Temporal con resultados públicos y discusiones recientes de practicantes. El TypeScript es un modelo de decisión ilustrativo, no una prueba de producción. La asistencia de IA apoyó la organización de la investigación, la redacción, la generación de la imagen y la localización; no ejecutó un agente, no midió una cola ni aportó experiencia operativa que el autor no haya demostrado. El autor también usa RemoteCode como herramienta de trabajo; esto no es una promesa de rendimiento del artículo.
Fuentes consultadas
- OpenAI Agents JS, “Running agents”, consultado el 8 de octubre de 2026.
- Vercel AI SDK, “Loop control”, consultado el 8 de octubre de 2026.
- Google Cloud, “Dead-letter topics”, consultado el 8 de octubre de 2026.
- AWS, “Using Amazon SQS dead-letter queues”, consultado el 8 de octubre de 2026.
- Temporal, “Retry policies”, consultado el 8 de octubre de 2026.