Una factura de Cloud Run puede parecer inexplicable cuando un servicio recibe pocas solicitudes, pero todavía necesita trabajar después de responder. El problema suele mezclar tres decisiones: cuándo está disponible la CPU, cuánto debe vivir una instancia y si un servicio HTTP es el recurso adecuado para el trabajo.
La introducción a Google Cloud Run explica la plataforma en general. Este artículo responde a una elección más concreta: ¿cuándo conviene la facturación por solicitudes y cuándo la facturación por instancias?
No ejecuté un servicio de Cloud Run ni medí una aplicación concreta para este artículo. La comparación usa la documentación actual de Google Cloud, conversaciones públicas para identificar dudas recurrentes y una matriz de decisión original. Los comandos son referencias de configuración, no una prueba de resultados en tu proyecto.
Respuesta breve
- Usa la facturación por solicitudes cuando el trabajo esté ligado al procesamiento de solicitudes y el tráfico sea esporádico, variable o tenga picos.
- Usa la facturación por instancias cuando la aplicación necesite CPU durante todo el ciclo de vida de la instancia, incluido cierto trabajo limitado en segundo plano.
- No elijas el modo solo por la palabra “facturación”. Confirma si el trabajo pertenece a un Service, Job, worker pool o instancia de Cloud Run.
- Mide coste, latencia, apagados y trabajo incompleto después de cambiar una sola variable cada vez.
¿Cuál es la diferencia entre los dos modos?
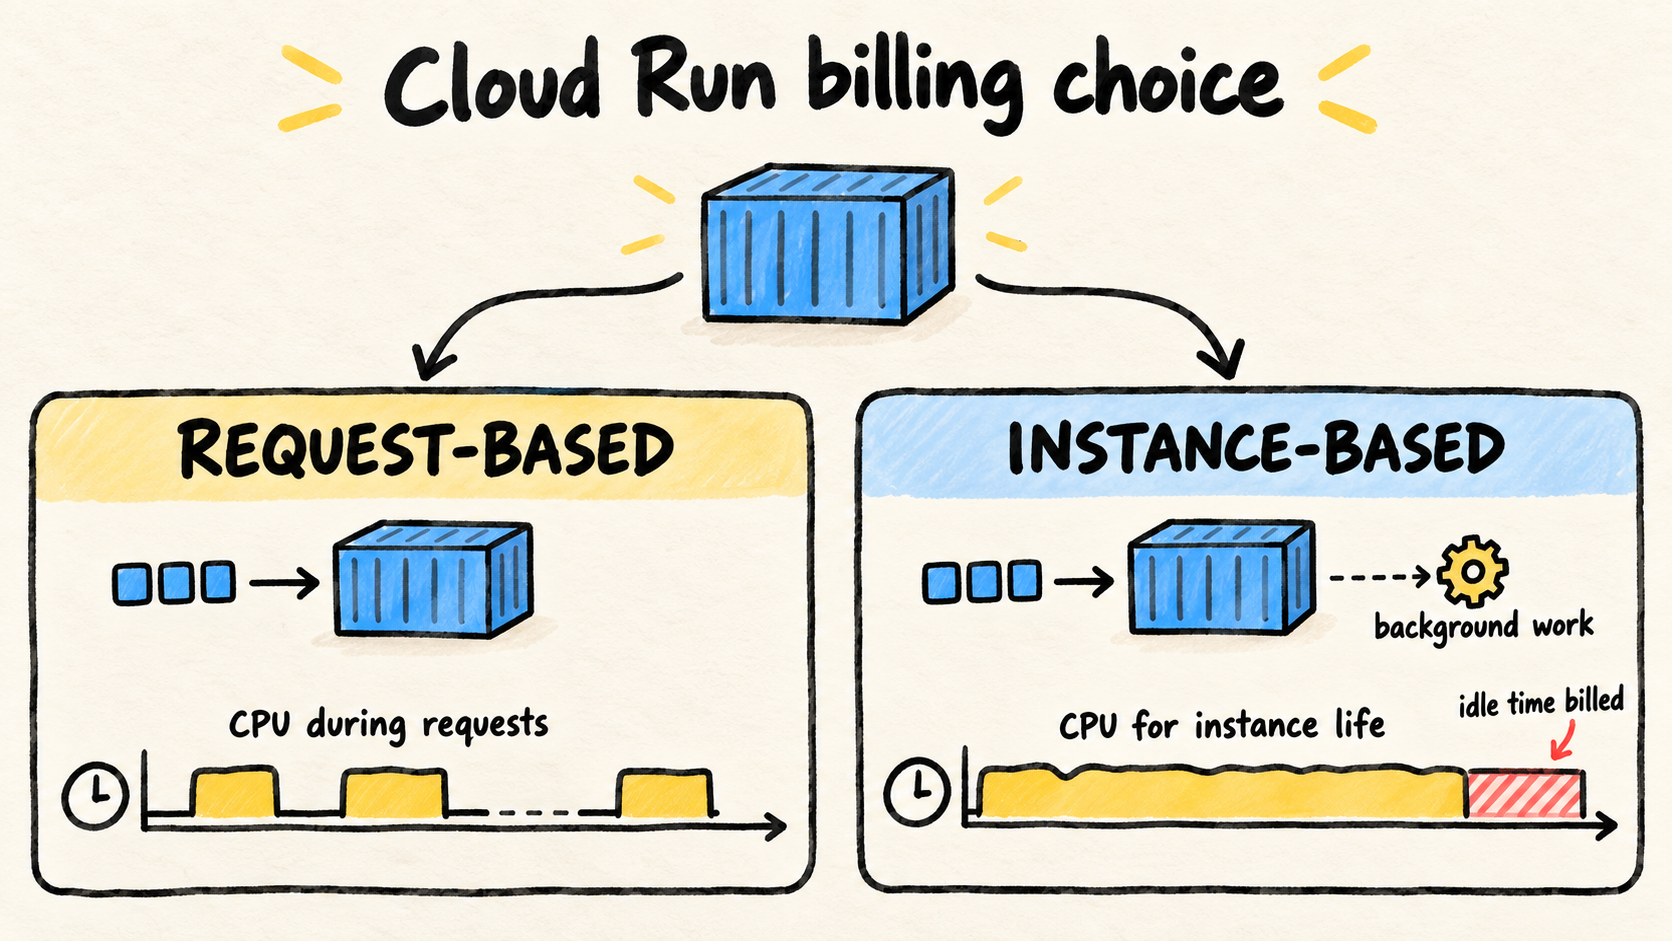
La documentación de configuración de facturación de Cloud Run, consultada el 28/10/2026, explica que la facturación por solicitudes asigna CPU durante el procesamiento de las solicitudes. La facturación por instancias mantiene la CPU asignada durante todo el ciclo de vida de la instancia.
La diferencia también cambia lo que ocurre cuando no hay una solicitud activa. Con la facturación por solicitudes, la capacidad inactiva no sigue procesando trabajo en segundo plano con CPU asignada. Con la facturación por instancias, la instancia permanece en un ciclo de vida facturado mientras existe, incluso cuando está inactiva. La página de precios de Cloud Run, consultada el mismo día, describe la diferencia entre el tiempo procesando solicitudes y el tiempo de vida de la instancia.
| Pregunta | Facturación por solicitudes | Facturación por instancias |
|---|---|---|
| ¿Cuándo se asigna la CPU? | Durante el procesamiento de solicitudes | Durante el ciclo de vida de la instancia |
| Tráfico habitual | Esporádico, variable o con picos | Continuo, lento o con trabajo fuera de la solicitud |
| ¿Qué pasa mientras está inactiva? | El servicio puede escalar y no procesa trabajo de fondo con CPU asignada | La instancia permanece en su ciclo de vida facturado mientras existe |
| Trabajo que merece atención | APIs y handlers ligados a solicitudes | Trabajo de fondo limitado, agentes de telemetría y trabajo iniciado durante el ciclo de vida |
| Riesgo de decisión | Pagar por capacidad que no necesitas | Pagar por instancias inactivas o usar un Service como worker duradero |
El modo no es automáticamente barato o caro. Es una declaración sobre el ciclo de vida que necesita tu aplicación.
¿Cuándo conviene la facturación por solicitudes?
La facturación por solicitudes suele encajar con una API que hace su trabajo importante durante la solicitud y termina la mayor parte antes de responder. También encaja con un tráfico que cambia mucho y puede beneficiarse de escalar desde cero. Si la preocupación es la primera solicitud, compara esta decisión con el diagnóstico de cold starts en Cloud Run.
Google Cloud recomienda este modo para cargas esporádicas, con picos o variables en la documentación de facturación. Es una recomendación según el tipo de carga, no una estimación universal de precio. El coste real depende del uso, la región, la configuración y los recursos asociados.
Elige este camino cuando se cumplan estas condiciones:
- El trabajo importante ocurre durante una solicitud.
- El proceso no necesita CPU fiable después de enviar la respuesta.
- La espera de escalar desde cero cabe en el objetivo de la ruta.
- El servicio puede repetir la operación o guardar su estado sin depender de que el proceso actual siga vivo.
Eso no hace segura la facturación por solicitudes para cualquier endpoint corto. Si una ruta inicia trabajo asíncrono y devuelve éxito antes de guardar una unidad de trabajo durable, el problema es de fiabilidad del flujo, no solo de facturación.
¿Cuándo resuelve un problema real la facturación por instancias?
La facturación por instancias tiene sentido cuando el trabajo necesita CPU fuera del periodo estricto de procesamiento de una solicitud. La documentación de Google Cloud menciona trabajo asíncrono o en segundo plano limitado después de la respuesta, como agentes de OpenTelemetry, trabajo asíncrono de Node.js, hilos de Java y coroutines de Kotlin.
También puede encajar con tráfico continuo o con una aplicación que hace trabajo de fondo mientras existe la instancia. La frase importante es “mientras existe la instancia”. El autoscaling sigue aplicándose. Cloud Run puede terminar instancias y una instancia inactiva puede permanecer como máximo 15 minutos después de una solicitud, salvo que otras configuraciones, como las instancias mínimas, cambien ese comportamiento (Google Cloud, “Billing settings for services”, consultado el 28/10/2026).
Elige la facturación por instancias solo cuando también puedas responder:
- ¿Qué ocurre si la instancia termina durante el trabajo?
- ¿Qué estado durable permite que la siguiente instancia reanude o repita la unidad de trabajo?
- ¿Qué límite de coste evita que las instancias inactivas crezcan sin control?
- ¿Por qué este trabajo pertenece a un Service HTTP y no a un Cloud Run Job con reintentos, un worker pool u otro recurso?
La facturación por instancias proporciona CPU durante el ciclo de vida de la instancia. No proporciona una cola, un checkpoint, una política de reintentos, exclusión mutua ni una promesa de que la instancia permanecerá viva.
¿Qué no garantiza este modo?
Cuatro confusiones frecuentes pueden convertir un cambio de facturación en una falsa solución.
Una instancia activa no garantiza continuidad
El autoscaling, los despliegues, los fallos durante el arranque, la capacidad regional y las cuotas siguen afectando al ciclo de vida. Las instancias mínimas pueden reducir la probabilidad de empezar desde cero, pero son un objetivo de capacidad, no una promesa de que una instancia concreta seguirá viva.
La CPU asignada no vuelve durable el trabajo
Si el proceso termina, la memoria y el sistema de archivos escribible de la instancia no son un checkpoint para la siguiente instancia. Guarda el estado en almacenamiento durable y usa una clave de idempotencia cuando la unidad pueda repetirse. El artículo sobre cómo manejar SIGTERM en Cloud Run sin perder trabajo explica esa entrega.
Un 504 no te dice por sí solo si el trabajo terminó
La documentación de timeout de solicitudes de Cloud Run, consultada el 28/10/2026, indica que el timeout predeterminado es de 300 segundos, que el máximo documentado es de 3600 segundos y que un 504 cierra la conexión aunque el contenedor pueda seguir procesando la solicitud interrumpida. Esto requiere idempotencia y una forma de comprobar el estado fuera de la conexión.
No aumentes el timeout para esconder una cola, una dependencia lenta o un trabajo que debería ser un Job. Un timeout mayor cambia el límite de la solicitud, pero no crea una transacción distribuida.
Los health checks pueden cambiar la decisión
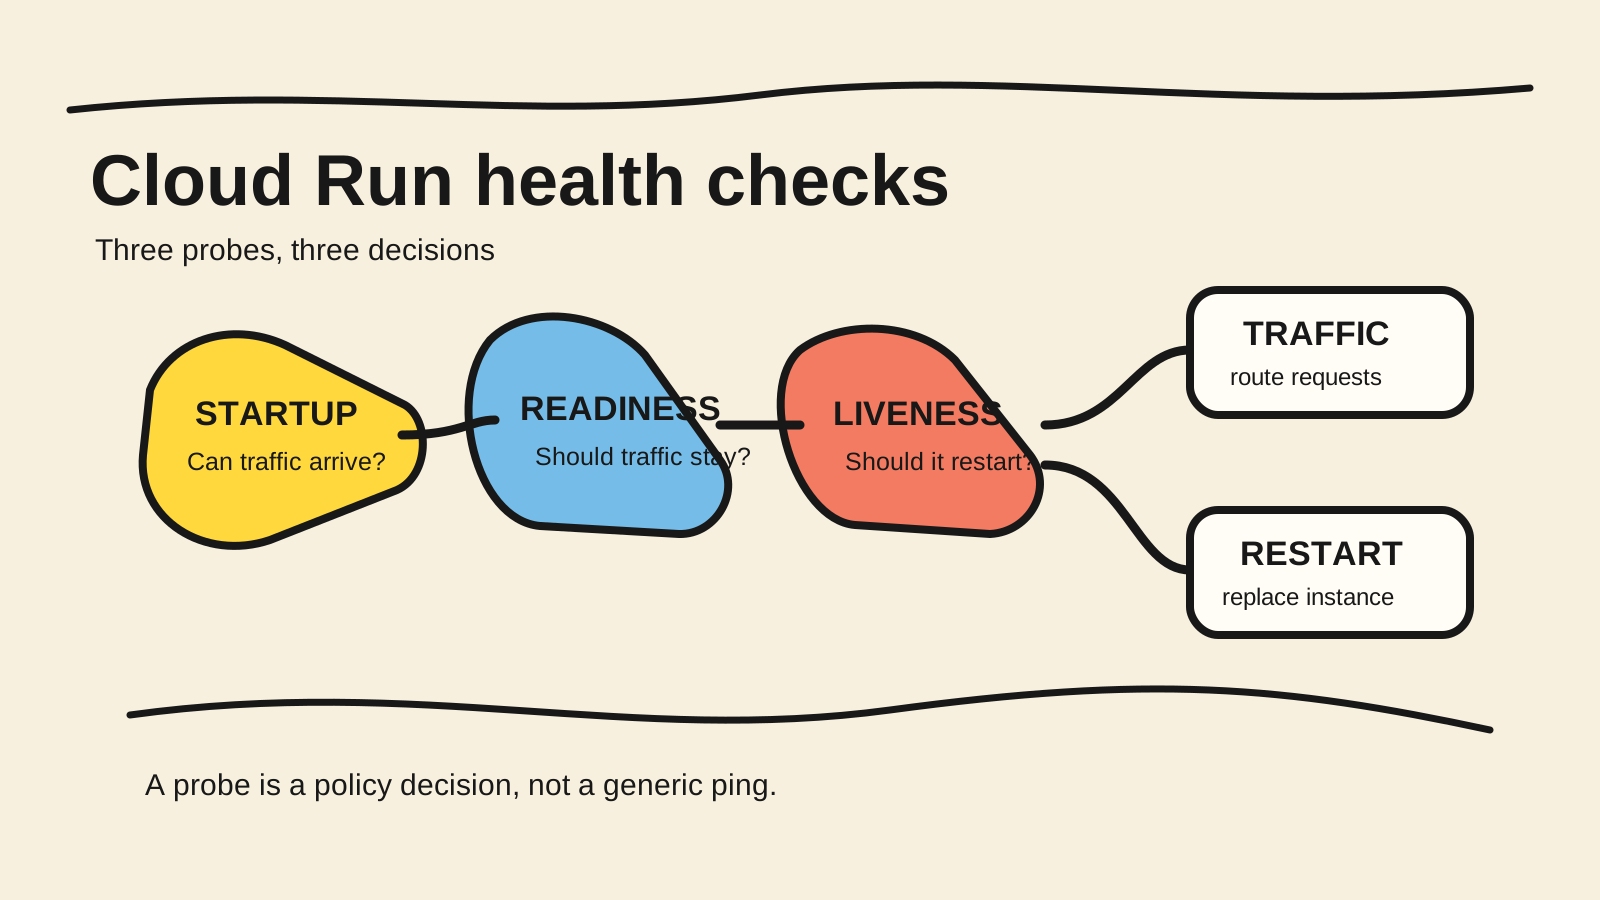
La documentación de facturación de Cloud Run indica que los health checks requieren facturación por instancias. La explicación de startup, liveness y readiness en Cloud Run ayuda a separar la función de la sonda del modo de facturación. Si una sonda necesita CPU fuera del procesamiento normal de solicitudes, trátalo como un requisito técnico que debes validar junto con el coste.
¿Service, Job, worker pool o instancia?
Elige quién es responsable del ciclo de vida del trabajo antes de elegir la facturación. La página de opciones de despliegue y modelo de recursos de Cloud Run, consultada el 28/10/2026, ayuda a separar servicios, jobs, worker pools e instancias.
| Forma del trabajo | Recurso que conviene investigar primero | ¿Por qué no empezar por la facturación? |
|---|---|---|
| Respuesta HTTP corta ligada a la solicitud | Cloud Run Service | El ciclo termina con la solicitud y puede escalar con el tráfico |
| Lote finito que debe terminar y puede repetirse | Cloud Run Job | El job expresa la ejecución, las tareas y los reintentos |
| Consumo continuo de una cola sin endpoint público | Cloud Run worker pool | El modelo representa el worker sin convertir una API en una cola improvisada |
| Proceso largo que necesita una instancia concreta | Instancia de Cloud Run | El ciclo de vida de la instancia es el objeto que intentas operar |
Un Service con facturación por instancias puede servir para un caso limitado, como una aplicación que inicia trabajo de fondo controlado. Es una mala elección si solo mantiene vivo un worker sin cola, checkpoint ni política de apagado.
¿Cómo cambiar el modo y verificar la revisión?
La documentación de facturación de Cloud Run muestra estos comandos para un servicio:
gcloud run services update SERVICE --cpu-throttling
gcloud run services update SERVICE --no-cpu-throttling
gcloud run services describe SERVICE --region REGION
--cpu-throttling selecciona el comportamiento basado en solicitudes. --no-cpu-throttling selecciona el comportamiento basado en instancias. El cambio crea una nueva revisión y la facturación por instancias requiere al menos 512 MiB de memoria, según la misma documentación.
El tercer comando no demuestra que el coste haya mejorado. Úsalo para inspeccionar la configuración de la revisión y registra región, CPU, memoria, concurrencia, instancias mínimas e imagen. Si el problema aparece durante los picos, separa la facturación de la concurrencia por instancia en Cloud Run. Después compara el mismo escenario de tráfico entre revisiones.
Haz una comprobación pequeña y reversible:
- Elige una ruta o workload que represente el problema.
- Registra solicitudes, errores, latencia, número de instancias y coste durante el periodo de comparación.
- Si existe trabajo asíncrono, registra el inicio, el checkpoint y la finalización fuera del contenedor.
- Cambia solo el modo de CPU y facturación.
- Comprueba si el trabajo de fondo terminó, se reintentó de forma segura o quedó abandonado.
- Revierte la revisión si el objetivo no mejora o el coste crece sin una razón operativa.
No uses un keep-alive artificial para impedir el scale-to-zero sin medir su efecto. Una solicitud periódica puede cambiar el tráfico y dificultar la atribución del coste.
Lista de comprobación
Hazte estas preguntas antes de cambiar la configuración:
- ¿La unidad de trabajo debe continuar después de enviar la respuesta?
- ¿Existe un estado durable que permita repetir o reanudar el trabajo?
- ¿El tráfico es esporádico, tiene picos, es continuo o se desconoce?
- ¿Una instancia inactiva puede seguir facturándose dentro del presupuesto?
- ¿Un health check u otro requisito necesita realmente CPU fuera de las solicitudes?
- ¿Un Job o worker pool expresaría mejor el ciclo que un Service?
- ¿Compararás la nueva revisión con la anterior usando la misma métrica?
Si no puedes responder las dos primeras preguntas, todavía no estás ante una decisión de facturación. Estás ante un problema de diseño del trabajo y del estado.
Conclusión
La facturación por solicitudes encaja con trabajo ligado a la solicitud y con tráfico que puede escalar desde cero. La facturación por instancias encaja con CPU necesaria durante todo el ciclo de vida de la instancia, incluido cierto trabajo asíncrono limitado. Ningún modo crea durabilidad, una cola o permanencia.
Empieza por el ciclo de vida del trabajo. Después elige un Service, Job, worker pool o instancia. Solo entonces cambia la facturación, compara una revisión con otra y comprueba el coste junto con la finalización real del trabajo.
Cómo se hizo este análisis
Samuel Fajreldines es el autor responsable de este artículo. La investigación comparó la documentación actual de Cloud Run, el inventario local de artículos para evitar solapamientos de intención y conversaciones públicas de practicantes para identificar preguntas y lenguaje. La matriz de decisión es una síntesis editorial original. Los comandos no se ejecutaron contra un proyecto de Cloud Run para este artículo, y no hay benchmark, caso de cliente ni precio calculado. La asistencia de IA apoyó el descubrimiento, la redacción, la generación de la imagen, la localización y la revisión de consistencia; no aportó experiencia de producción ni sustituyó la verificación de fuentes.