O agente enviou uma mensagem, alterou um registro ou recusou uma ferramenta. Quando alguém pergunta o que aconteceu, o time encontra apenas a conversa e um trace cheio de spans. Falta a ligação entre quem iniciou o run, qual autoridade estava ativa, qual decisão foi aprovada e qual sistema confirmou o efeito.
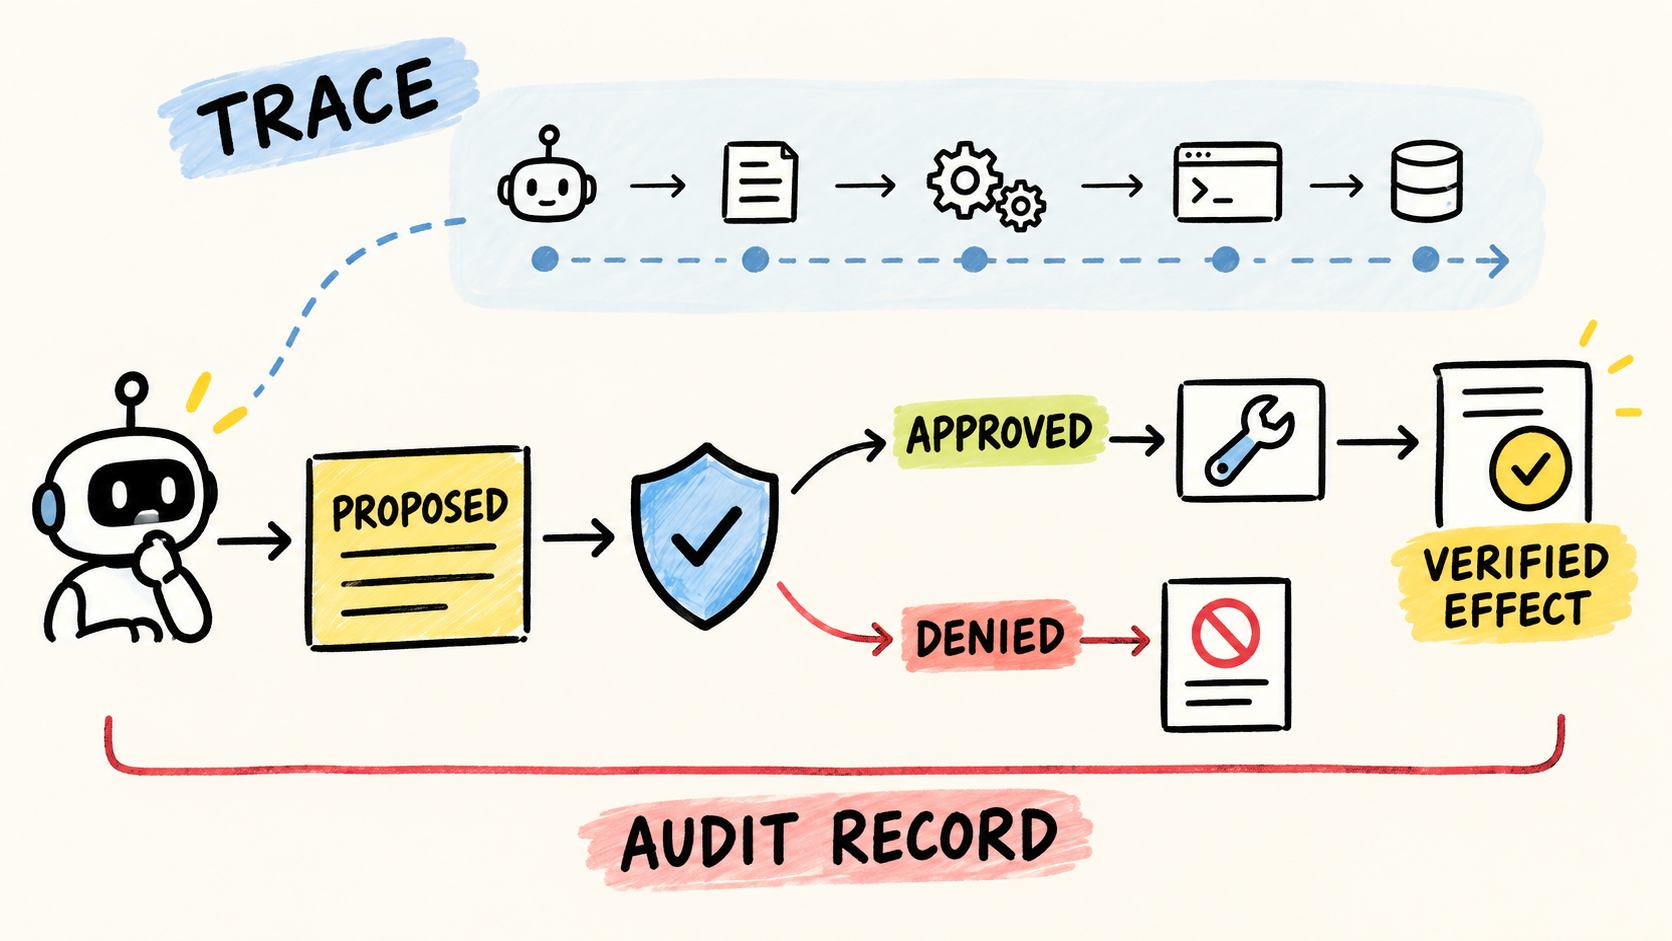
Para criar um log de auditoria de um agente de IA, registre eventos estruturados que conectem identidade, intenção, política, ação e resultado. Inclua tentativas bloqueadas, não apenas chamadas bem-sucedidas. O modelo pode propor uma ação, mas o runtime ou o sistema que a executa deve registrar o que foi permitido, o que começou e o que realmente foi confirmado.
Isso é diferente de guardar cada prompt. Um trace de tool calls com OpenTelemetry explica a ordem e a duração da execução. O log de auditoria precisa responder se aquela ação tinha autoridade, qual aprovação a cobria e qual evidência ficou depois dela.
Resposta curta
- Registre
runId,traceId, identidade humana ou de serviço, versão do agente e modelo.- Registre a ação proposta, a ferramenta, o alvo, a política aplicada e a decisão, incluindo
denied.- Ligue uma aprovação ao payload exato que foi aprovado, não apenas ao nome da ferramenta.
- Separe
completeddeunknown: um timeout não prova que o efeito não aconteceu.- Guarde referências, hashes e resultados redigidos quando o payload completo tiver dados sensíveis.
Um trace e um log de auditoria respondem a perguntas diferentes
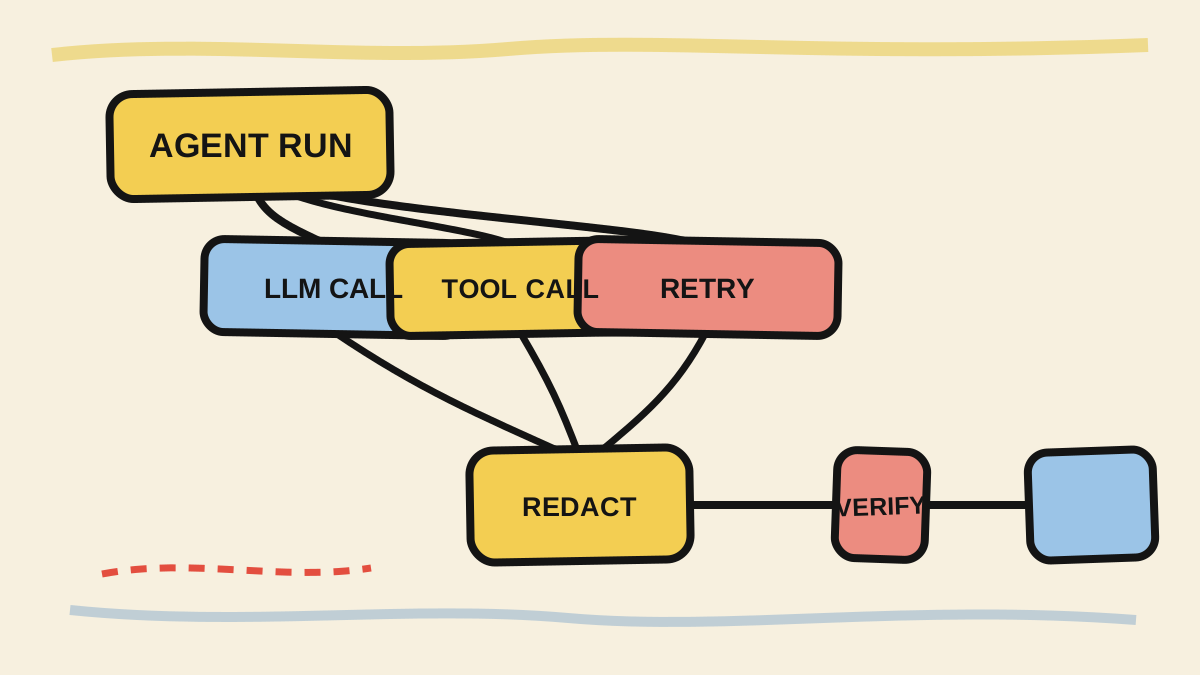
O trace responde: “em que ordem as operações ocorreram e onde o run falhou?”. O log de auditoria responde: “quem autorizou esta ação, qual política foi aplicada e qual resultado pode ser verificado?”. Um sistema pode produzir os dois a partir de uma mesma execução, mas não deve tratá-los como o mesmo registro.
A documentação do OpenAI Agents SDK sobre tracing descreve traces com gerações do modelo, tool calls, handoffs, guardrails e eventos personalizados. A documentação do Agents API sobre traces também organiza chamadas de ferramentas por agente, sessão, turn e span, com argumentos, resultados e status quando esses dados são registrados. Isso é útil para diagnóstico.
Auditoria acrescenta uma relação de responsabilidade. O evento precisa dizer em nome de quem a ação ocorreu, qual agente e versão estavam ativos, qual escopo de autoridade foi usado e se a ação foi proposta, permitida, negada, executada ou confirmada. O trace pode apontar para esse evento com traceId; ele não substitui o evento.
Também não confunda o resumo final do agente com a prova. O modelo pode afirmar que atualizou um pedido mesmo quando a ferramenta falhou, foi bloqueada ou terminou em um timeout cujo resultado ninguém consultou. O escritor do evento de resultado deve estar na fronteira que recebeu a resposta real da ferramenta ou que leu de volta o sistema externo.
Quais perguntas o registro precisa responder?
Comece pelo incidente que você gostaria de investigar seis semanas depois. Um bom registro permite responder às perguntas abaixo sem reconstruir a história a partir de cinco logs incompatíveis.
| Pergunta | Campos mínimos | Fonte preferida |
|---|---|---|
| Quem iniciou o trabalho? | actorId, tipo de identidade, runId |
gateway ou runtime |
| Qual agente tomou a decisão? | agentId, versão, modelId, versão da configuração |
runtime |
| Qual era o objetivo? | referência da tarefa ou intenção redigida | aplicação, não só o modelo |
| Qual ação foi proposta? | ferramenta, operação, alvo, actionHash |
runtime antes da execução |
| O que autorizou a ação? | escopo, regra, decisão e approvalId |
política ou gateway |
| A ação foi bloqueada? | decision: denied, regra, motivo categorizado |
fronteira de política |
| O que foi executado? | tentativa, request ID externo, início e fim | executor da ferramenta |
| Qual foi o efeito? | status, recibo, referência de recurso ou read-back | sistema que sofreu o efeito |
| O que ainda é incerto? | outcome: unknown, motivo e próximo passo |
runtime após timeout ou queda |
Esses campos não formam um padrão universal. São um contrato mínimo para ligar proposta, autorização, execução e consequência. O OWASP Securing Agentic Applications Guide inclui logging de planos, validações, tool calls, interações de aprovação, erros e mudanças de estado entre as práticas de operação segura. A lista acima transforma essa preocupação em uma fronteira que o time consegue implementar e testar.
Não registre “o agente decidiu” como se isso fosse uma identidade. A identidade vem do usuário, serviço ou credencial que iniciou a operação. O modelo e a versão explicam qual componente gerou a proposta. A política explica por que o executor aceitou ou recusou. São papéis diferentes.
Modele o ciclo da ação, incluindo o que não aconteceu
Um único evento tool_call: success é pequeno demais para uma ação que passa por aprovação, fila, retry e confirmação externa. Use estados que representem transições observáveis. Um conjunto possível é:
proposed -> approved -> started -> completed
                 \-> denied
started -> failed
started -> unknown -> reconciled
proposed significa que o agente sugeriu uma operação. approved significa que uma política ou pessoa autorizou aquele payload. denied é uma decisão útil e deve ser registrado mesmo quando nenhum sistema externo foi chamado. started marca que o executor ultrapassou a fronteira de autorização. completed só deve aparecer quando a ferramenta ou o sistema externo devolveu uma confirmação suficiente.
unknown é importante em operações com efeito. Se o worker perde a conexão depois de enviar uma requisição, o processo local sabe que perdeu a resposta, não que a operação falhou. O runtime pode consultar o sistema externo, usar um request ID ou aplicar uma operação idempotente antes de mudar unknown para reconciled ou failed.
Esse cuidado complementa o guia de pausar e retomar um agente de IA. O checkpoint guarda o estado necessário para continuar. O log de auditoria guarda as transições e evidências que explicam o que o runtime observou até a interrupção. Um não deve ser usado como substituto do outro.
Ligue a aprovação à ação exata
Uma aprovação com a frase “pode atualizar o CRM” é fraca demais para auditoria. O mesmo nome de ferramenta pode receber alvos, filtros e valores diferentes. A aprovação precisa apontar para uma representação estável da operação que será executada.
Uma implementação pode guardar a ação normalizada, um hash do payload redigido e o escopo que foi avaliado:
import { createHash, randomUUID } from "node:crypto";

type Decision = "proposed" | "approved" | "denied";
type Outcome = "started" | "completed" | "failed" | "unknown";

type AuditEvent = {
  id: string;
  createdAt: string;
  runId: string;
  traceId: string;
  actorId: string;
  agentId: string;
  agentVersion: string;
  eventType: "decision" | "execution";
  toolName: string;
  target: string;
  actionHash: string;
  decision?: Decision;
  outcome?: Outcome;
  policyRule?: string;
  approvalId?: string;
  externalRequestId?: string;
  evidenceRef?: string;
};

function hashAction(action: unknown): string {
  return createHash("sha256")
    .update(JSON.stringify(action))
    .digest("hex");
}

function makeAuditEvent(
  base: Omit<AuditEvent, "id" | "createdAt" | "actionHash">,
  action: unknown,
): AuditEvent {
  return {
    ...base,
    id: randomUUID(),
    createdAt: new Date().toISOString(),
    actionHash: hashAction(action),
  };
}
O código é ilustrativo. Ele mostra a forma do contrato, mas não implementa armazenamento append-only, autorização, redaction, controle de concorrência ou a confirmação do serviço externo. Em produção, a aprovação deve ser consumida pelo executor junto com o actionHash; se o payload mudar, a aprovação deixa de corresponder à ação.
Não use o hash como prova de que a ação foi executada. Ele prova, no máximo, que uma representação foi associada ao evento. O resultado precisa carregar o status que a ferramenta devolveu, um identificador externo ou uma leitura posterior do recurso. A diferença entre “enviei” e “o sistema confirmou” é justamente a parte que o incidente tentará esclarecer.
O runtime deve escrever o resultado, não o modelo
O modelo pode sugerir uma razão, uma ferramenta e argumentos. Ele não deve ser o autor da linha que afirma que um pagamento foi enviado, um arquivo foi apagado ou uma permissão foi alterada. O executor conhece o request ID, o código de retorno e a exceção. Um gateway de política conhece a decisão e o escopo. O sistema externo pode fornecer o recibo final.
Isso não significa descartar a saída do modelo. Guarde uma referência ou um resumo redigido quando ela for necessária para explicar a proposta. Apenas diferencie model_output de execution_result. O primeiro é uma entrada para revisão. O segundo é uma observação da fronteira que executou ou verificou a ação.
A documentação de observabilidade do Microsoft Agent Framework mostra por que essa separação importa: prompts, respostas, argumentos e resultados sensíveis ficam desligados por padrão, e habilitar esses dados pode expor informação confidencial. A configuração de telemetria não substitui uma política de retenção. Mesmo quando o trace contém um argumento, o audit log pode guardar apenas o hash, uma referência protegida e o conjunto mínimo para a revisão.
Uma divisão prática é:
- Modelo: propõe intenção, ferramenta e argumentos.
- Política: decide permitir, exigir aprovação ou negar.
- Executor: registra início, fim, erro, retry e request ID.
- Sistema externo: confirma a mudança ou permite uma consulta de reconciliação.
- Auditoria: junta as referências e expõe uma visão legível para revisão.
Essa divisão reduz a chance de uma narrativa plausível virar a única versão do que aconteceu.
O que não registrar por padrão
Um log de auditoria completo não é um depósito de prompts. Guardar tudo pode ampliar o vazamento que você pretendia investigar, encarecer a retenção e dar acesso a pessoas que só precisavam ver a decisão.
Comece bloqueando por padrão:
- tokens, cookies, chaves e cabeçalhos de autorização;
- prompts completos quando uma referência versionada ou um hash responde à pergunta;
- dados pessoais e financeiros que não sejam necessários para identificar o alvo;
- corpo inteiro de respostas externas grandes;
- raciocínio privado do modelo como se fosse uma explicação verificável.
Em seu lugar, use identificadores, classificação de dados, tamanho, status, hash, referência de artefato redigido e uma política de acesso. Mantenha o conteúdo completo em armazenamento separado somente quando a finalidade, a retenção e o controle de acesso estiverem definidos. Redigir na tela do dashboard é tarde demais: o dado já pode ter passado pelo transporte, pelo exportador e pelo armazenamento.
Não prometa “log imutável” só porque a aplicação usa JSONL. Append-only é uma propriedade do armazenamento e da autorização, não do formato do arquivo. Se a revisão exigir proteção contra alteração, defina quem pode escrever, quem pode ler, como a integridade será verificada e por quanto tempo o registro existe. Este artigo não transforma essas escolhas em conformidade jurídica.
Como testar se o log conta a história certa?
Faça a auditoria falhar em um ambiente controlado. Escolha uma ferramenta com efeito fictício e verifique cada transição, não apenas a resposta final do agente.
- Execute uma ação permitida e confira
proposed,approved,startedecompleted. - Tente uma ação fora do escopo e confirme que
deniedexiste sem uma chamada externa. - Mude um argumento depois da aprovação e verifique que o
actionHashnão corresponde mais. - Faça a ferramenta devolver erro e confirme
failed, com o segredo removido da mensagem. - Corte a conexão depois do envio e confirme
unknown, sem converter o timeout em “não executou”. - Faça uma reconciliação por request ID e registre o recibo ou o motivo de continuar incerto.
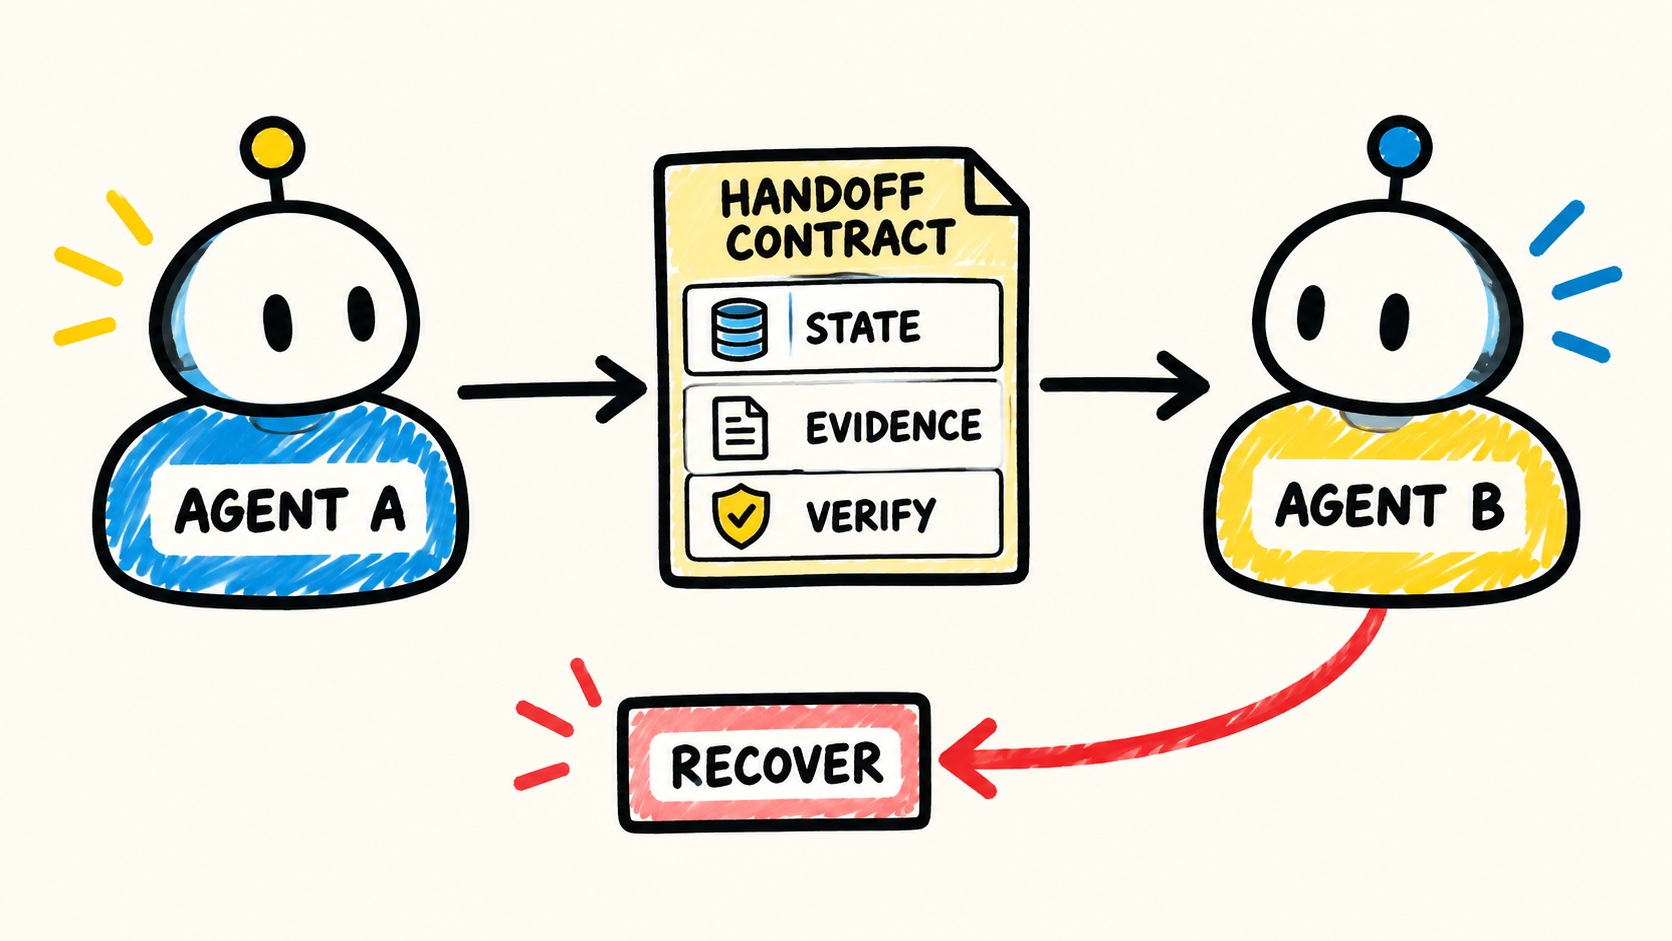
- Passe por um handoff e confira que
runId,traceId, autoridade e versão do agente continuam ligados. - Envie um argumento sensível e confirme que o exportador recebe a forma redigida prevista.
O teste mais importante é feito por uma pessoa que não escreveu o runtime. Dê a ela um runId e uma pergunta concreta, como “qual agente tentou alterar este registro, qual regra permitiu e o que o sistema confirmou?”. Se ela precisar ler o código para entender a sequência, o registro ainda é telemetria interna, não uma trilha de auditoria útil.
Para operações que podem ser repetidas, combine esse teste com a verificação do efeito de uma tool call antes de tentar de novo e com os testes de idempotência de uma API sem efeitos duplicados. O log deve registrar a tentativa e a reconciliação, mas não conserta sozinho um executor que repete efeitos.
Trace, log, métrica ou checkpoint?
Use cada sinal para a pergunta que ele consegue responder:
| Sinal | Pergunta principal | Não substitui |
|---|---|---|
| Trace | Qual foi a ordem e onde o tempo ou erro apareceu? | prova de autorização ou estado externo |
| Log de auditoria | Quem propôs, permitiu, negou e executou a ação? | armazenamento do estado do run |
| Métrica | Quantas falhas, negações ou ações ocorreram? | explicação de um caso individual |
| Checkpoint | De onde o runtime pode continuar? | evidência de que um efeito externo foi confirmado |
| Recibo externo | Qual sistema confirmou qual mudança? | contexto completo da decisão |
O OpenTelemetry mantém convenções para traces, eventos e sinais de GenAI, mas convenção de telemetria não define automaticamente a política de auditoria da sua aplicação. Use os IDs de trace e span para correlação quando isso for seguro. Mantenha o contrato de auditoria estável mesmo que você troque o backend de observabilidade.
Perguntas frequentes
Preciso guardar o prompt inteiro para auditar um agente?
Não. Guarde uma referência versionada, um hash ou um resumo redigido quando isso bastar para identificar o contexto. Preserve o conteúdo completo somente quando a finalidade e a política de acesso justificarem. O registro precisa explicar a decisão sem transformar todos os dados vistos pelo agente em cópia permanente.
Um trace do OpenTelemetry já é um audit log?
Não necessariamente. Um trace organiza operações, duração, relações e erros. Um audit log acrescenta identidade, autoridade, decisão de política, aprovação, ação exata e resultado verificável. Você pode produzir ambos juntos e ligá-los com traceId, mas não deve assumir que um dashboard de traces conserva a evidência ou a retenção necessárias para uma revisão.
Devo registrar ações negadas?
Sim, quando a tentativa ajuda a responder o que o agente ou usuário tentou fazer e qual regra a bloqueou. Uma negação pode ser o evento mais importante de um incidente de prompt injection ou de uma configuração errada. Registre a categoria do motivo e a referência da política sem copiar dados sensíveis desnecessários.
O log pode provar a intenção do modelo?
Não. Ele pode registrar a saída que propôs a ação, a versão do modelo e os dados de contexto selecionados. Isso ajuda a investigar, mas não transforma uma justificativa gerada depois em prova causal. A autorização, a execução e o efeito devem ser registrados por componentes que controlam essas fronteiras.
Conclusão
Um agente não fica auditável porque produz mais texto. Ele fica auditável quando cada ação relevante deixa uma ligação verificável entre identidade, autoridade, política, execução e efeito.
Comece com um evento pequeno. Registre o que foi proposto, o que foi permitido ou negado, o que começou e o que o sistema confirmou. Preserve unknown quando a resposta sumir. Redija o conteúdo que não precisa estar no registro e teste a história com uma pessoa que não conhece o código.
O trace explica o caminho. O checkpoint permite continuar. O audit log sustenta a pergunta sobre responsabilidade. Misturar essas funções cria registros grandes e ainda deixa a dúvida principal sem resposta.
Como esta análise foi feita
Samuel Fajreldines é o autor responsável por este artigo. A pesquisa comparou a documentação atual do OpenAI Agents SDK, do OpenAI Agents API, do Microsoft Agent Framework, do OpenTelemetry e do OWASP com discussões públicas recentes e o cluster existente do site. O contrato de eventos e o checklist de verificação são síntese editorial. O código TypeScript é ilustrativo e não foi executado contra um agente ou backend de auditoria. A assistência de IA apoiou descoberta, redação, geração da imagem, localização e revisão de consistência; não forneceu experiência de produção nem substituiu a verificação das fontes. O autor também usa o RemoteCode como ferramenta de trabalho.
Fontes consultadas
- OpenAI Agents SDK, “Tracing”, consultado em 2026-10-01
- OpenAI API, “Agents API tracing”, consultado em 2026-10-01
- Microsoft, “Agent Framework observability”, consultado em 2026-10-01
- OpenTelemetry, “Generative AI semantic conventions”, consultado em 2026-10-01
- OWASP GenAI Security Project, “Securing Agentic Applications Guide”, consultado em 2026-10-01
- Obot, “What to log when an agent calls a tool”, consultado em 2026-10-01