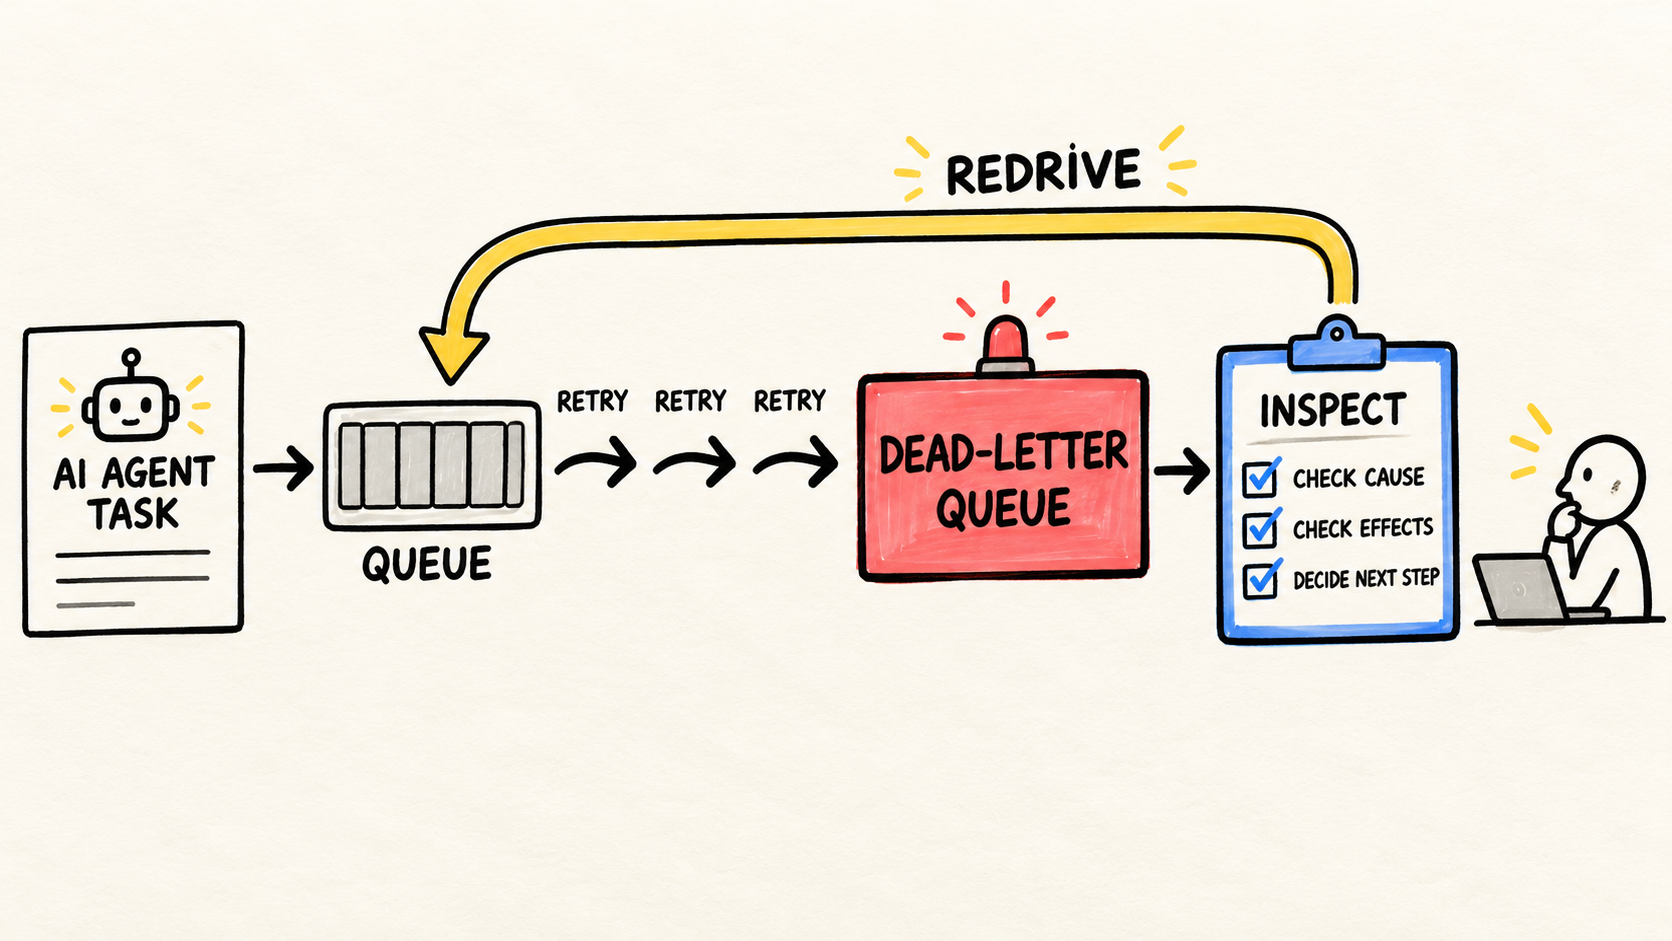
Uma tarefa de agente de IA falha, volta para a fila e falha de novo. Depois, o worker pode repetir a mesma chamada, descartar a mensagem ou deixar alguém descobrir o problema tarde demais. O risco maior é não saber se uma tentativa anterior já alterou o sistema externo.
Depois de um limite de tentativas, coloque a tarefa em uma dead-letter queue (DLQ) e preserve a evidência necessária para uma decisão. A DLQ não deve ser um depósito de mensagens esquecidas. Ela é uma quarentena: alguém ou uma política explícita precisa decidir se a tarefa será corrigida, retomada, compensada ou rejeitada.
Esse estado complementa a execução durável de agentes de IA com filas e workflows. A execução durável guarda progresso e checkpoints; a DLQ organiza o que fazer quando o progresso não pode continuar com segurança.
Resposta curta
- Limite as tentativas no nível da tarefa e do worker.
- Diferencie falha transitória, falha permanente e efeito externo incerto.
- Ao esgotar o limite, grave tarefa, causa, tentativas, checkpoint e possíveis efeitos em uma DLQ.
- Faça redrive somente depois de verificar a causa e a idempotência da operação.
- Se não for possível provar que repetir é seguro, encaminhe para reparo, compensação ou decisão humana.
O que uma dead-letter queue resolve em um agente de IA?
Uma DLQ resolve o problema de destino para uma tarefa que não deve continuar no caminho normal. Ela evita que uma mensagem venenosa consuma tentativas indefinidamente e evita que um operador precise reconstruir o caso a partir de logs espalhados.
Ela não resolve sozinha o significado da falha. Uma fila sabe que a entrega não foi confirmada. Ela não sabe se uma ferramenta chegou a criar um pedido antes de a conexão cair, se o modelo produziu um argumento inválido ou se o estado de negócio mudou parcialmente. Essa interpretação continua sendo responsabilidade do contrato do agente e do sistema que executou a ferramenta.
As bibliotecas de agentes já têm limites de loop que protegem uma execução individual. A documentação do OpenAI Agents JS descreve maxTurns e informa o valor padrão de 10 no momento da consulta; a documentação do Vercel AI SDK descreve um limite padrão de 20 passos para ToolLoopAgent. Esses limites encerram a execução. Eles não substituem a retenção e a investigação da tarefa encerrada. O artigo sobre como evitar um loop infinito em um agente trata do limite durante o loop; aqui, o foco é o que acontece depois. (OpenAI Agents JS, Vercel AI SDK, consultados em 08/10/2026.)
Qual falha deve ir para a DLQ?
Não envie apenas exceções com a mesma etiqueta. A política precisa separar a chance de uma nova tentativa funcionar da chance de repetir um efeito perigoso.
| Situação | Exemplo | Próximo estado | Redrive automático? |
|---|---|---|---|
| Transitória e sem efeito confirmado | timeout antes de receber resposta | retry com atraso | talvez, dentro do orçamento |
| Permanente e sem efeito | schema inválido ou ferramenta removida | DLQ para correção | não |
| Efeito externo incerto | timeout depois de uma chamada de pagamento | DLQ para consulta ou compensação | não |
| Limite de política | muitas etapas ou chamadas repetidas | DLQ ou cancelamento | não |
| Estado recuperável | falha depois de um checkpoint válido | workflow de retomada | somente com contrato de resume |
Uma falha transitória não é definida somente pelo código HTTP. O mesmo timeout pode acontecer antes ou depois de um serviço externo confirmar a mutação. Guarde a posição da tarefa, o identificador de idempotência e o recibo do efeito quando existirem. Sem isso, o worker transforma incerteza em duplicata.
A documentação do Temporal recomenda distinguir erros permanentes de erros transitórios e permite marcar erros como não recuperáveis ou limitar tentativas. A decisão do framework é um insumo para o seu contrato, não uma prova de que uma ferramenta específica é segura para repetir. (Temporal, políticas de retry, consultado em 08/10/2026.)
O que guardar no registro da tarefa?
O corpo da DLQ precisa ser suficiente para um operador reproduzir a decisão sem executar o agente às cegas. Um registro útil costuma conter:
- Identidade:
taskId,runId, tipo de tarefa, tenant e chave de idempotência. - Entrada controlada: referência para o payload ou snapshot necessário, sem copiar segredos ou dados que não precisam ficar na fila.
- Histórico: número de tentativas, timestamps, versões do agente, modelo, prompt ou política relevante e nomes das ferramentas chamadas.
- Causa classificada: timeout, limite, erro de validação, permissão, dependência indisponível ou efeito incerto.
- Checkpoint e artefatos: último progresso confirmado, saída estruturada, recibo da ferramenta e trace relacionado.
- Próxima ação:
retry,resume,repair,compensate,rejectouhuman_review, com responsável e motivo.
O registro não deve incluir uma transcrição completa por padrão. Retenha um ponteiro para o artefato protegido e aplique a política de retenção do produto. O guia sobre o log de auditoria de um agente ajuda a separar evidência operacional de uma conversa que não prova o efeito. Logs detalhados também precisam de controle de acesso, porque uma falha pode carregar dados do cliente ou argumentos de ferramenta.
Redrive, resume, reparo ou compensação?
Essas palavras não são sinônimas. O redrive cria uma nova tentativa da mensagem. O resume continua a partir de um checkpoint. O reparo muda a entrada ou a configuração antes de tentar. A compensação desfaz ou neutraliza um efeito que já aconteceu.
Use esta ordem antes de mover uma tarefa para a fila normal:
- Descubra onde a falha ocorreu. Foi antes da chamada, durante a chamada ou depois de uma confirmação parcial?
- Consulte o sistema externo. Um timeout não confirma nem nega uma mutação. Verifique pelo identificador de idempotência, recibo ou consulta segura.
- Classifique a causa. Corrija schema, permissão ou dado inválido antes do redrive; não aumente o limite para esconder o diagnóstico.
- Escolha o ponto de partida. Retome do checkpoint se o workflow o garante. Faça redrive do começo somente se cada efeito for idempotente ou se o agente puder provar que ele ainda não ocorreu.
- Registre a decisão. O próximo operador precisa saber por que a tarefa voltou, foi compensada ou foi rejeitada.
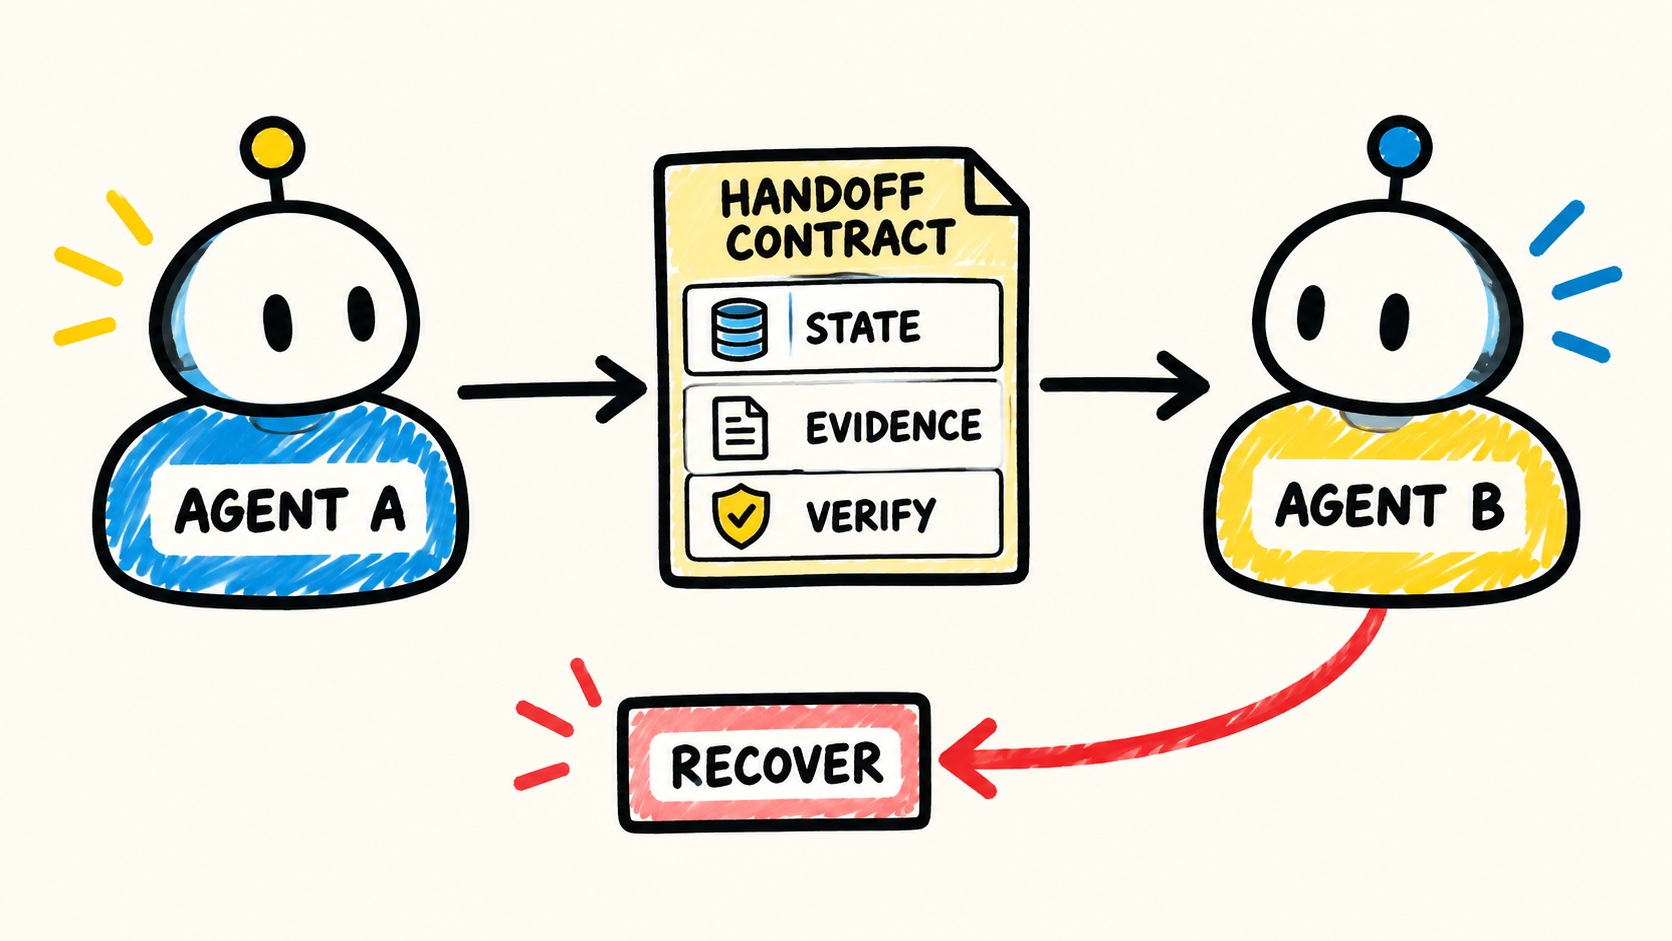
O contrato de verificação de tool calls antes de um retry é a referência mais próxima para o caso de efeito incerto. A DLQ amplia essa verificação para o momento em que a política de tentativas já foi esgotada.
Como os provedores ajudam, e onde param?
O recurso de DLQ do provedor reduz trabalho operacional, mas não cria semântica de recuperação para o agente.
- O Amazon SQS encaminha mensagens para uma DLQ quando o
maxReceiveCountconfigurado é atingido. A própria documentação recomenda analisar o conteúdo e configurar alarmes; retenção e ordem dependem da configuração da fila. (AWS, dead-letter queues, consultado em 08/10/2026.) - O Google Cloud Pub/Sub encaminha mensagens não entregues para um dead-letter topic e acompanha tentativas de entrega de forma aproximada. A aplicação ainda precisa decidir como interpretar a tarefa e como redriveá-la. (Google Cloud, dead-letter topics, consultado em 08/10/2026.)
Em ambos os casos, “foi para a DLQ” é apenas um evento de infraestrutura. O contrato do agente deve continuar carregando o taskId, o estado do efeito externo e o próximo passo permitido. Não trate a contagem de entregas do broker como a contagem completa de turnos, chamadas de ferramenta ou efeitos.
Um contrato pequeno para a decisão
O exemplo abaixo é ilustrativo. Ele não chama uma fila nem decide se um pagamento é idempotente. O objetivo é tornar explícita a informação que a política precisa receber antes de escolher o próximo estado.
type NextAction = "retry" | "resume" | "repair" | "compensate" | "reject" | "human_review";

type Failure = {
  attempts: number;
  maxAttempts: number;
  effect: "none_confirmed" | "confirmed" | "unknown";
  checkpoint: boolean;
  retryable: boolean;
  inputFixed: boolean;
};

export function decideNext(failure: Failure): NextAction {
  if (failure.effect === "unknown") return "human_review";
  if (failure.effect === "confirmed") return "compensate";
  if (failure.checkpoint) return "resume";
  if (failure.retryable && failure.attempts < failure.maxAttempts) return "retry";
  if (failure.inputFixed) return "repair";
  return "reject";
}
O contrato fica incompleto se effect for sempre preenchido como none_confirmed porque o worker não encontrou um recibo. “Não encontrei confirmação” é diferente de “provei que não houve efeito”. Quando essa diferença importar, use unknown e faça a tarefa parar. Se o run também passou por compactação, o checklist do que preservar no contexto antes de continuar evita que o checkpoint perca a fronteira entre fato confirmado e hipótese.
Como verificar a DLQ antes de liberar redrive?
Faça o check com uma fixture controlada e inclua os casos em que a ferramenta pode ter sido executada. Uma matriz mínima deve provar que:
- um timeout antes da chamada pode seguir o caminho de retry dentro do orçamento;
- um timeout depois de uma mutação vai para
human_reviewou consulta de idempotência; - um erro de schema não consome retries indefinidamente;
- um checkpoint válido retoma do passo correto, sem repetir efeitos anteriores;
- um redrive repetido mantém o mesmo identificador de idempotência;
- o operador vê causa, versão, artefatos e responsável sem precisar do transcript completo.
O teste do redrive não precisa executar um modelo real para provar as transições determinísticas. Ele precisa executar a integração real em um ambiente controlado quando a propriedade depende do broker, do sistema externo ou da ferramenta. Não há aqui um benchmark ou um teste de produção: o contrato é uma proposta verificável, não um resultado medido.
Falhas comuns que a DLQ não corrige
Usar a DLQ como lixeira
Se ninguém possui o alerta, a fila apenas esconde a falha. Defina retenção, alerta, responsável, prazo de triagem e uma saída para tarefas que não podem ser redriveadas.
Fazer redrive em lote
Um lote pode misturar erro de autenticação, dado inválido e efeito externo incerto. Redrive por classe de causa e preserve o histórico da decisão. Uma tarefa corrigida não é prova de que todas as outras são seguras.
Apagar o payload para cumprir retenção
Retenção curta pode remover justamente a evidência que explica o incidente. Retenção longa pode ampliar risco de dados. Separe o envelope operacional de artefatos sensíveis e defina a regra com segurança e negócio.
Confundir limite de turnos com recuperação
maxTurns ou um limite de passos evita um loop local. Não informa o que aconteceu com uma chamada que perdeu a resposta. Para essa dúvida, você precisa de idempotência, recibo, consulta ou revisão.
Perguntas frequentes
Toda falha de agente precisa ir para uma DLQ?
Não. Falhas comprovadamente transitórias podem seguir o retry dentro de um orçamento. A DLQ é o destino para o que esgotou o caminho normal ou precisa de uma decisão diferente antes de continuar.
Uma DLQ substitui checkpoints?
Não. O checkpoint explica de onde um workflow pode continuar. A DLQ explica por que a tarefa saiu do caminho normal e qual decisão está pendente. Os dois mecanismos se complementam.
Posso redrivear automaticamente depois de corrigir a causa?
Somente se o contrato provar que a nova execução é segura, a causa foi corrigida e a tarefa não tem efeito externo incerto. Caso contrário, mantenha revisão explícita e registre a autorização.
Quanto tempo devo manter uma tarefa na DLQ?
O tempo depende do risco, dos acordos operacionais e da retenção dos dados. Defina o prazo com o responsável pelo sistema e preserve os artefatos necessários para investigar uma decisão. Não use um número universal sem conhecer o processo.
Conclusão
Uma tarefa que falha repetidamente precisa de um estado melhor que “tente mais uma vez”. A dead-letter queue cria esse estado, mas só é útil quando preserva a história da execução, o possível efeito externo e a próxima ação autorizada.
Comece classificando falhas, limite tentativas, registre checkpoints e trate efeito desconhecido como desconhecido. Depois, teste redrive, resume, reparo e compensação com fixtures que exercitem as transições perigosas. O sistema não precisa eliminar todo erro. Precisa impedir que uma falha difícil vire um loop infinito, uma mensagem perdida ou uma duplicata silenciosa.
Como este artigo foi produzido
Samuel Fajreldines é o autor responsável por este artigo. A pesquisa comparou documentação atual de OpenAI Agents JS, Vercel AI SDK, AWS, Google Cloud e Temporal com resultados públicos e discussões recentes de praticantes. O código é uma decisão TypeScript ilustrativa e não foi apresentado como teste de produção. A assistência de IA ajudou na organização da pesquisa, redação, geração da imagem e localização; não executou um agente, não mediu uma fila e não forneceu experiência operacional que o autor não demonstrou. O autor também usa RemoteCode como ferramenta de trabalho; isso não é uma alegação de desempenho para este artigo.
Fontes consultadas
- OpenAI Agents JS, “Running agents”, consultado em 08/10/2026.
- Vercel AI SDK, “Loop control”, consultado em 08/10/2026.
- Google Cloud, “Dead-letter topics”, consultado em 08/10/2026.
- AWS, “Using Amazon SQS dead-letter queues”, consultado em 08/10/2026.
- Temporal, “Retry policies”, consultado em 08/10/2026.