Cuando un agente falla después de llamar a una API, leer una base de datos o cambiar un sistema externo, repetir el prompt rara vez reproduce el fallo. El modelo puede responder de otra manera, la API puede haber cambiado y la ejecución puede haber observado otro estado.
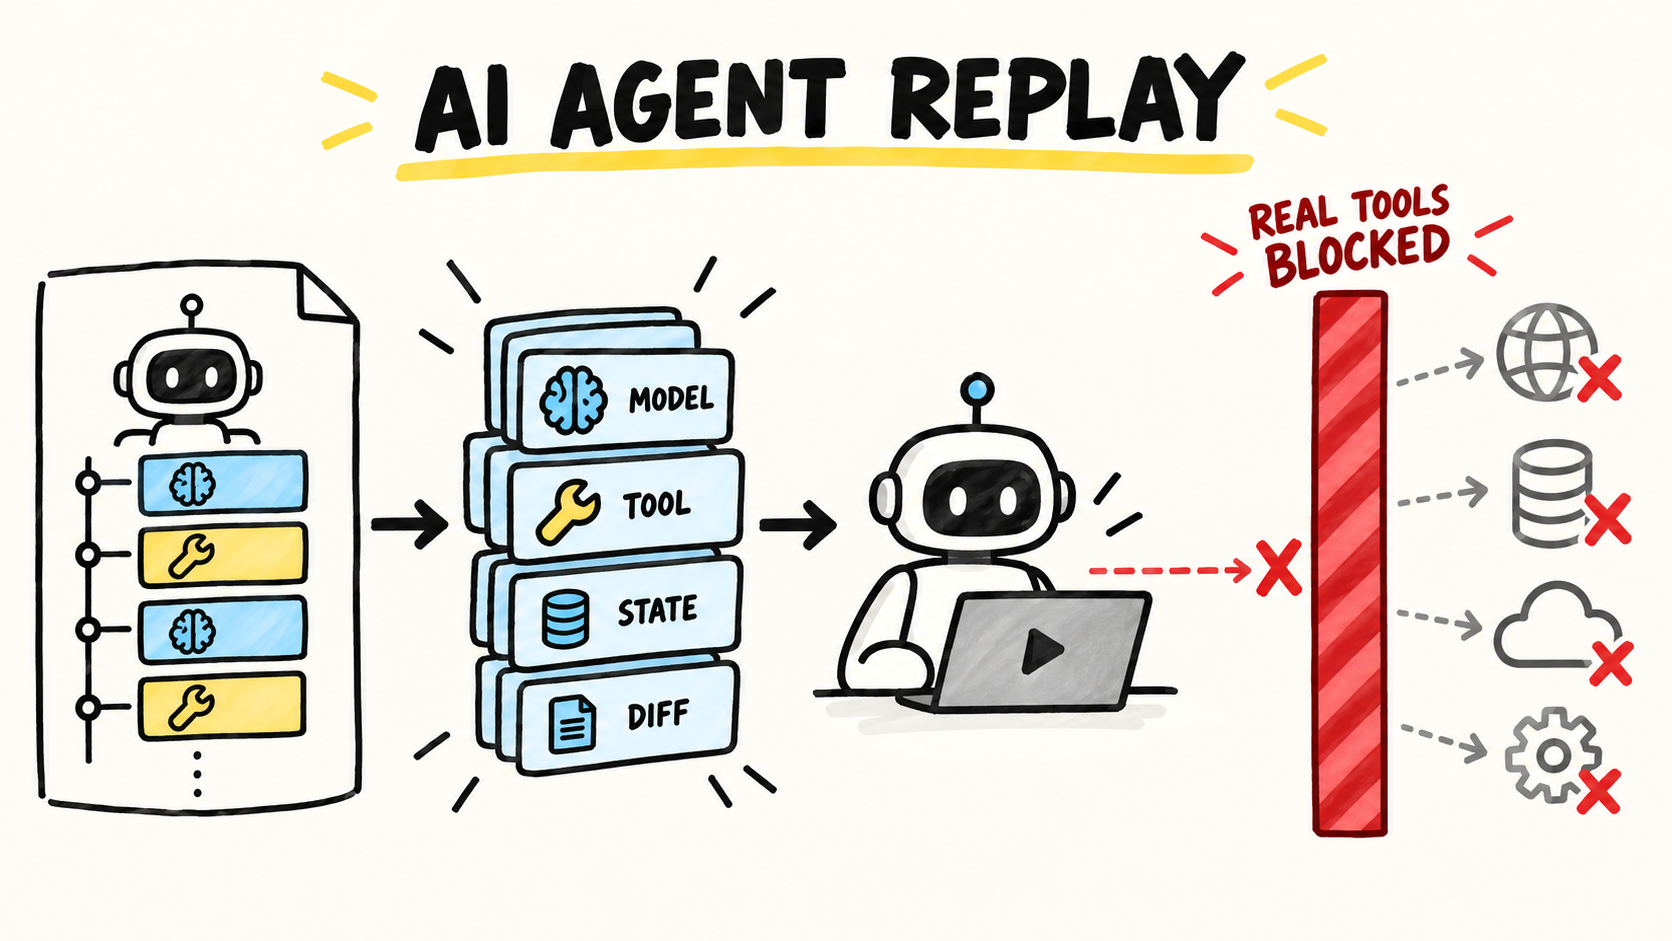
El replay resuelve un problema más concreto: reconstruir una ejecución a partir de eventos grabados, sustituir el modelo y las herramientas por respuestas registradas y detener cualquier intento de producir efectos reales. Así puedes inspeccionar la primera divergencia sin convertir el diagnóstico en otra operación de producción.
Este artículo explica el mecanismo, un formato mínimo de cassette y una fixture ejecutable en JavaScript. Para separar estado, herramientas y recuperación, relaciónalo con la ejecución durable para agentes de IA. Replay diagnostica una ejecución conocida; no reanuda una ejecución interrumpida.
Respuesta corta: registra las entradas y salidas de cada frontera relevante, entrega al replay solo esos eventos, haz que cada adapter de herramienta real falle explícitamente y compara la ejecución hasta su primera divergencia.
Replay no es reanudar una ejecución
Tres problemas relacionados necesitan contratos diferentes:
| Mecanismo | Pregunta que responde | ¿Qué ocurre con el mundo externo? |
|---|---|---|
| Observabilidad | ¿Qué ocurrió y en qué etapa? | La ejecución original ya puede haber producido efectos. |
| Replay | ¿Cómo reproduzco el comportamiento observado? | Las respuestas externas vienen de fixtures o cassettes. |
| Recuperación | ¿Cómo continúo después de una interrupción? | El sistema necesita checkpoints, efectos confirmados y una política de retry. |
Un trace ayuda a localizar una etapa, pero no siempre basta para volver a ejecutarla. Los traces de OpenTelemetry describen spans y atributos para observar operaciones. Un cassette de replay necesita algo más: los datos necesarios para responder de nuevo en las fronteras que el agente atravesaría.
Por eso un log de auditoría no debe convertirse automáticamente en una fixture. Un registro de auditoría de un agente de IA puede minimizarse o redactarse para rendición de cuentas, mientras que el replay necesita datos suficientes para reproducir una decisión. Pueden compartir eventos, pero sus controles de acceso y retención tienen objetivos distintos.
Qué registrar durante la ejecución
Empieza por las fronteras que pueden cambiar el siguiente paso. En una ejecución típica son:
- la entrada normalizada del agente y la configuración que afecta al planning;
- la petición y respuesta del modelo, incluyendo su identidad y las opciones relevantes;
- el nombre, los argumentos, el resultado o el error de cada herramienta;
- resultados de búsqueda, documentos recuperados y lecturas de estado que cambian la decisión;
- reloj, valores aleatorios e identificadores generados solo cuando la ejecución depende de ellos.
No registres todo por reflejo. El payload bruto de una herramienta puede contener un token, datos personales o un secreto. Crea una política que separe el valor necesario para reproducir la decisión del que debe eliminarse, ocultarse o sustituirse por un marcador. Las convenciones semánticas GenAI de OpenTelemetry pueden ayudar a nombrar las partes del evento, pero no sustituyen tu política de privacidad ni convierten un trace en un cassette listo.
Cada evento necesita una identidad estable y un orden verificable. Un formato inicial puede ser:
{
  "runId": "run-2026-10-15-001",
  "events": [
    {
      "seq": 1,
      "kind": "model",
      "requestHash": "sha256:...",
      "response": { "tool": "lookupOrder", "args": { "id": "ord-7" } }
    },
    {
      "seq": 2,
      "kind": "tool",
      "name": "lookupOrder",
      "argsHash": "sha256:...",
      "response": { "status": "ready" }
    }
  ]
}
El hash ayuda a descubrir que el replay recibió una entrada distinta. No es una prueba de integridad por sí solo: define el algoritmo, normaliza los datos antes de calcularlo y protege el cassette frente a cambios no autorizados.
Cómo bloquear herramientas reales durante el replay
El bloqueo debe estar en el camino de ejecución, no solo en una convención del nombre del test. Un adapter de producción que pueda enviar un correo, crear un pedido o borrar un registro debe ser inalcanzable cuando el modo es replay.
La fixture siguiente usa el módulo de tests de Node, cuya API oficial permite ejecutarla con node --test. El agente recibe un adapter real, pero el replay nunca lo llama. En su lugar, consume la secuencia grabada y falla en cuanto el paso esperado no coincide con el evento disponible.
const assert = require("node:assert/strict");
const test = require("node:test");

const cassette = [
  { kind: "model", response: { tool: "lookupOrder", args: { id: "ord-7" } } },
  { kind: "tool", name: "lookupOrder", response: { status: "ready" } },
  { kind: "model", response: { final: "El pedido está listo." } },
];

function createReplay(events) {
  let cursor = 0;

  return {
    next(expectedKind) {
      const event = events[cursor];
      if (!event || event.kind !== expectedKind) {
        throw new Error(
          `primera divergencia en el evento ${cursor}: se esperaba ${expectedKind}`,
        );
      }
      cursor += 1;
      return event;
    },
    done() {
      assert.equal(cursor, events.length, "el replay dejó eventos sin consumir");
    },
  };
}

async function runInReplay(replay, realTool) {
  const plan = replay.next("model");
  const recordedTool = replay.next("tool");

  assert.equal(recordedTool.name, plan.response.tool);
  assert.deepEqual(recordedTool.response, { status: "ready" });

  // Este argumento permite detectar una llamada real accidental.
  void realTool;

  const final = replay.next("model");
  replay.done();
  return final.response.final;
}

test("el replay usa el cassette y no llama a la herramienta real", async () => {
  let realCalls = 0;
  const realTool = async () => {
    realCalls += 1;
    throw new Error("se alcanzó la herramienta real durante el replay");
  };

  const result = await runInReplay(createReplay(cassette), realTool);

  assert.equal(result, "El pedido está listo.");
  assert.equal(realCalls, 0);
});
El ejemplo tiene dos propiedades importantes. La primera es negativa: si se llama a la herramienta real, el test debe fallar. La segunda es diagnóstica: el cursor señala el primer evento que dejó de coincidir. Un fallo al final de la ejecución puede ser solo la consecuencia de una divergencia ocurrida muchos pasos antes.
En un agente de producción, createReplay suele ser un dispatcher más completo. Debe verificar la identidad de la operación, los argumentos normalizados, la versión del schema y la secuencia. Si falta una respuesta grabada, el modo seguro es fallar con contexto, no hacer fallback silencioso a la API real.
Cómo encontrar la primera divergencia
Compara eventos en un orden que conserve la causalidad. Una diferencia en el texto final suele aportar poca información. Una diferencia en los argumentos de una herramienta, en un resultado de búsqueda o en el estado que alimentó la decisión suele ser más útil.
Registra al menos:
- la posición del evento;
- el tipo de frontera, como
model,tool,retrievalostate; - la identidad de la operación;
- una representación redactada de la entrada esperada y la recibida;
- el origen de la respuesta, como
cassette,fixtureolive, conliveprohibido durante el replay.
No compares automáticamente todos los campos volátiles. Una marca de tiempo, un ID de trace o un identificador aleatorio pueden cambiar sin cambiar el comportamiento. Pero ignorar los argumentos de una herramienta puede ocultar justo el defecto que buscas. Define la equivalencia por tipo de evento y documenta qué campos son semánticos.
Después de cambiar el agente, haz replay de los casos importantes y agrupa los fallos por su primera divergencia. Las pruebas de regresión de agentes sin comparar texto exacto ayudan a convertir esa diferencia en una aserción de comportamiento duradera. El replay aporta el camino concreto; la prueba de regresión evita que la corrección desaparezca en el siguiente cambio.
Retención, redacción y forks seguros
Un cassette puede contener más información que el log que normalmente conservas. Antes de persistirlo, define:
- qué campos son secretos, personales o regulados;
- quién puede leer, exportar e invalidar el cassette;
- durante cuánto tiempo sigue siendo útil para el diagnóstico;
- cómo se marcan las versiones de prompt, schema y herramientas;
- cómo impedir que un cassette editado parezca la ejecución original.
Para investigar una hipótesis, prefiere crear un fork inmutable. El replay original debe seguir siendo la referencia del incidente. Los cambios del fork deben aparecer como una nueva entrada, con la razón del cambio y el resultado observado. Así “la ejecución que ocurrió” queda separada de “el comportamiento que quería probar”.
Si el cassette proviene de una ejecución que produjo efectos reales, el replay no deshace esos efectos. Solo evita nuevos efectos. Para entender ese límite, observa una ejecución del agente y sus tool calls y mantén la traza de auditoría separada del material usado para simular.
Cuándo el replay debe convertirse en una prueba de regresión
No todos los cassettes deben entrar en la suite. Promueve uno cuando represente un fallo importante, una decisión de negocio sensible o una frontera que ya se rompió. Elimina los datos que no hagan falta para la aserción y mantén la expectativa en el nivel del comportamiento:
- se eligió la herramienta correcta;
- los argumentos respetaron el contrato;
- una respuesta de error llevó al fallback esperado;
- no ocurrió ningún efecto prohibido;
- se alcanzó el estado final relevante.
No congeles una respuesta del modelo como verdad eterna. Un replay puede probar cómo reacciona el sistema ante una respuesta concreta, pero no demuestra que el modelo seguirá produciendo esa respuesta en producción. Separa las pruebas del dispatcher, las pruebas de contrato de las herramientas y las evaluaciones del comportamiento del modelo cuando la pregunta cambie.
Qué no demuestra este método
El replay es una aproximación controlada, no una copia del mundo. No demuestra que:
- una API externa seguirá disponible o mantendrá el mismo contrato;
- el estado real de la base de datos o del servicio seguirá coincidiendo;
- latencia, concurrencia y límites de tasa tendrán el mismo efecto;
- el modelo producirá la misma salida fuera del cassette;
- una herramienta con efectos laterales sea segura para ejecutar de nuevo.
La investigación reciente sobre replay determinista en sistemas de agentes de IA aborda las fuentes de no determinismo entre el modelo, las APIs externas y el entorno. Proyectos open source como agentrr también hacen explícita la idea de capturar las fronteras del modelo, las herramientas, el reloj y la aleatoriedad para ejecutar offline. Estas referencias ayudan a validar el mecanismo, pero no sustituyen las pruebas de tus adapters ni una política de datos adecuada para tu sistema.
Preguntas rápidas
¿Puedo hacer replay usando solo un trace?
A veces, pero no por defecto. Si el trace contiene todas las entradas y salidas necesarias, puede ser la base del cassette. Si solo contiene nombres de spans, duraciones e IDs, todavía faltan respuestas.
¿Debo llamar al modelo real durante el replay?
No cuando el objetivo es reproducir una ejecución concreta. Llamar al modelo otra vez convierte el replay en una nueva ejecución sujeta a otra salida. Haz una prueba separada cuando quieras medir el comportamiento actual del modelo ante la misma entrada.
¿Cómo impido que se escape una herramienta real?
Haz que el adapter de producción falle por defecto en modo replay, inyecta implementaciones de cassette y conserva una prueba que cuente o prohíba llamadas reales. La protección también debe existir en CI, no solo en la máquina del desarrollador.
Cómo se produjo este artículo
Soy Samuel Fajreldines, autor de este sitio. La parte ejecutable se diseñó como una fixture local, sin llamadas a un proveedor de modelos, una base de datos ni una API externa. La prueba comprueba que se consume la secuencia grabada, que se conserva la respuesta final y que no se llama al adapter real. Eso prueba el contrato del ejemplo, no la seguridad de un runtime de producción.
Cuando una sesión necesita seguir visible entre máquinas y sesiones, uso RemoteCode como herramienta del autor. No se usó para ejecutar la fixture y no es evidencia del rendimiento del método.
Fuentes consultadas
- OpenTelemetry: traces, consultado el 15 de octubre de 2026.
- OpenTelemetry: convenciones semánticas GenAI, consultado el 15 de octubre de 2026.
- Node.js: test runner, consultado el 15 de octubre de 2026.
- Deterministic Replay for AI Agent Systems, consultado el 15 de octubre de 2026.
- agentrr: deterministic record and replay, consultado el 15 de octubre de 2026.
Las conversaciones de comunidades de desarrolladores ayudaron a identificar el lenguaje del problema, sobre todo la diferencia entre cachear respuestas de herramientas y reanudar una sesión. Se usaron como señales de discurso, no como prueba técnica.