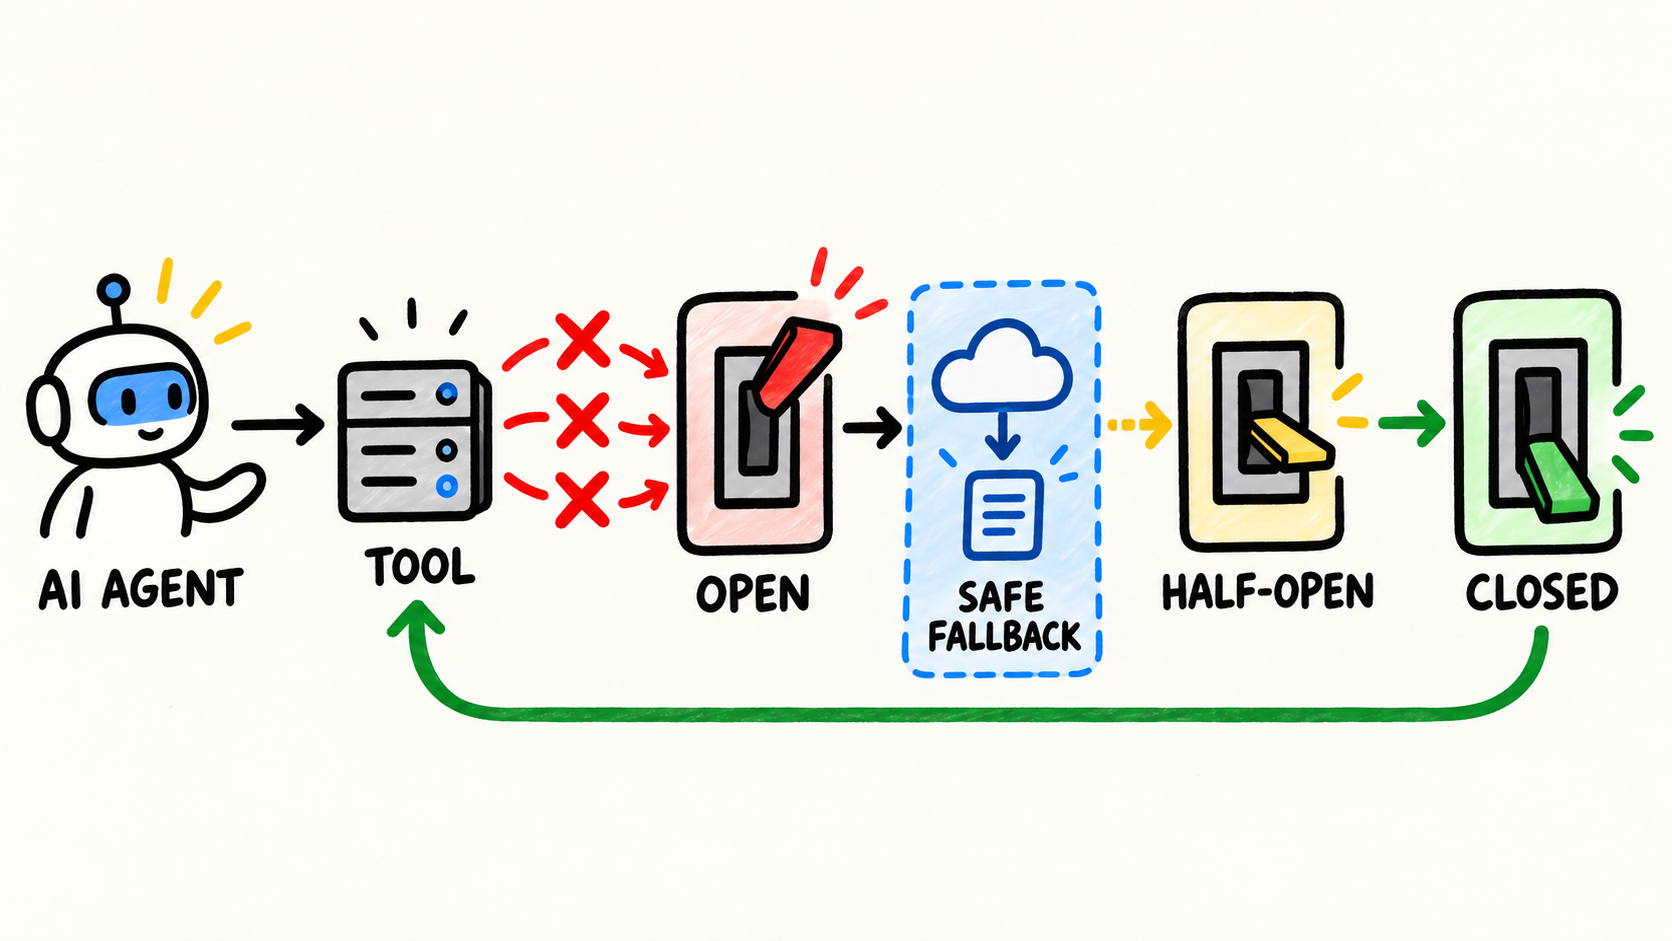
Una tool de agente falla, el runtime vuelve a intentarlo y la dependencia sigue devolviendo un timeout o 503. El modelo recibe otro error, elige la misma tool y el ciclo consume tiempo sin obtener información nueva.
Retry y circuit breaker resuelven problemas distintos. El retry repite un fallo que puede ser temporal. El circuit breaker detiene las llamadas cuando las señales indican que el siguiente intento probablemente también fallará. En un agente, esa decisión debe estar en el límite de la tool, antes de la llamada externa, no solo en el prompt. El artículo sobre cómo evitar que un agente entre en un bucle infinito cubre el problema general; aquí el foco está en la dependencia que falla.
Respuesta breve
- Mantén un breaker separado para cada dependencia que pueda fallar de forma independiente.
- Cuenta solo fallos clasificados, como timeouts, indisponibilidad y límites de velocidad, no errores de validación del pedido.
- En estado abierto, rechaza la llamada rápido y devuelve un resultado estructurado que el agente pueda explicar o derivar.
- Después del cooldown, permite una sola sonda en
half-open.- Cierra el circuito después de una sonda exitosa y vuelve a abrirlo si la dependencia continúa fallando.
Retry y circuit breaker son guardas diferentes
Un retry tiene sentido cuando existe una posibilidad razonable de que la siguiente llamada funcione. Un circuit breaker sirve cuando el fallo parece correlacionado: un servicio no está disponible, una cola está saturada o una API rechaza solicitudes. La guía de AWS sobre el patrón Circuit breaker, consultada el 22 de octubre de 2026, describe el breaker como una forma de impedir retries repetidos contra una dependencia que ya está fallando.
Las guardas pueden trabajar juntas. Un retry corto puede tratar un error transitorio dentro de una llamada protegida. Si la clasificación indica que la dependencia sigue indisponible, el breaker debe bloquear el siguiente intento. La guía de AWS sobre Retry with backoff, consultada el 22 de octubre de 2026, también separa los fallos transitorios de los casos en que conviene fallar rápido.
En el runtime de un agente hay una tercera capa: el modelo puede ver el error de la tool y pedir otra vez la misma acción. Por eso el breaker debe envolver el camino que decide si la tool puede ejecutarse. Debe devolver una razón estable cuando se bloquea la llamada, en lugar de ser un contador oculto dentro del cliente HTTP.
Un retry pregunta: "¿Lo intento una vez más?". Un circuit breaker pregunta: "¿Esta dependencia debe recibir alguna llamada ahora?". Si mezclas las dos preguntas, el agente puede interpretar el circuito abierto como un error temporal y recrear el retry que la guarda intentaba detener.
¿Qué ocurre en cada estado?
La documentación de Microsoft sobre el patrón Circuit Breaker, consultada el 22 de octubre de 2026, modela el breaker como una máquina con estados closed, open y half-open. El modelo sirve para una tool de agente, pero el resultado también necesita el contexto operativo que puedan usar el modelo y la persona que llama.
| Estado | Decisión antes de la tool | Transición |
|---|---|---|
closed |
Permitir la llamada y observar el resultado | Los fallos clasificados se acumulan; el éxito limpia la secuencia |
open |
Rechazar sin llamar a la dependencia | Después del cooldown, pasar a half-open |
half-open |
Permitir una sonda; rechazar sondas simultáneas | El éxito cierra; el fallo vuelve a abrir |
El estado debe pertenecer a una dependencia, no a todo el agente. Si la búsqueda está caída, eso no significa que la base de datos o una tool de lectura de archivos también esté indisponible. Un breaker global convierte un fallo localizado en una caída innecesaria de todo el agente.
También debes decidir quién puede ejecutar la sonda. Una sola solicitud controlada deja espacio para que la dependencia se recupere. Liberar un lote completo cuando termina el cooldown recrea el pico justo cuando el servicio está volviendo.
¿Qué fallos deben abrir el circuito?
No abras el circuito por cualquier excepción. Un 400 causado por argumentos inválidos, una regla de autorización o una entrada rechazada por el schema no demuestra que la dependencia esté enferma. Contarlo como una caída puede bloquear una tool sana y ocultar un problema en el contrato de la llamada.
Clasifica el fallo antes de actualizar el breaker. Los timeouts, fallos de conexión, respuestas 429 y 5xx pueden ser candidatos, según el contrato del proveedor. Los errores de autenticación, recursos inexistentes y argumentos inválidos suelen necesitar corrección o escalamiento, no una sonda automática. La clasificación debe ser específica para la dependencia y estar documentada junto a la tool.
El número de fallos y el cooldown del ejemplo no son recomendaciones universales. Son parámetros de una fixture local. Una API lenta, una cola de trabajo y un proveedor de modelos se recuperan en plazos distintos. Mide la dependencia antes de escoger una política y empieza con una configuración que pueda cambiar sin hacer un redeploy.
¿Cómo implementar un circuit breaker para una tool?
Una implementación pequeña es más fácil de revisar cuando recibe el reloj por inyección. Así, la prueba puede avanzar el tiempo sin sleep, y la transición a half-open no depende de la velocidad de la máquina.
El wrapper siguiente protege una operación, permite una sonda y mantiene la decisión fuera del modelo. El método shouldCount representa la clasificación propia de la aplicación. En producción, registra también la dependencia, runId, transición y motivo, sin enviar secretos ni el resultado completo de la tool a los logs.
type CircuitState = "closed" | "open" | "half-open";

type BreakerOptions = {
  failureThreshold: number;
  cooldownMs: number;
  now?: () => number;
  shouldCount: (error: unknown) => boolean;
};

export class CircuitOpenError extends Error {
  constructor(public readonly retryAfterMs: number) {
    super("tool dependency is temporarily unavailable");
    this.name = "CircuitOpenError";
  }
}

export class ToolCircuit {
  private state: CircuitState = "closed";
  private failures = 0;
  private openedAt = 0;
  private probeInFlight = false;

  constructor(private readonly options: BreakerOptions) {}

  getState(): CircuitState {
    if (this.state === "open" && this.remainingCooldown() === 0) {
      this.state = "half-open";
    }
    return this.state;
  }

  async run<T>(operation: () => Promise<T>): Promise<T> {
    const state = this.getState();

    if (state === "open") {
      throw new CircuitOpenError(this.remainingCooldown());
    }

    if (state === "half-open") {
      if (this.probeInFlight) {
        throw new CircuitOpenError(this.options.cooldownMs);
      }
      this.probeInFlight = true;
    }

    try {
      const result = await operation();
      this.failures = 0;
      this.state = "closed";
      return result;
    } catch (error) {
      if (this.options.shouldCount(error)) {
        this.failures += 1;
        if (state === "half-open" || this.failures >= this.options.failureThreshold) {
          this.state = "open";
          this.openedAt = this.options.now?.() ?? Date.now();
        }
      }
      throw error;
    } finally {
      if (state === "half-open") {
        this.probeInFlight = false;
      }
    }
  }

  private remainingCooldown(): number {
    if (this.state !== "open") return 0;
    const now = this.options.now?.() ?? Date.now();
    return Math.max(0, this.options.cooldownMs - (now - this.openedAt));
  }
}
El método no hace retry ni llama al modelo. Solo decide si la operación externa puede empezar. Esa separación vuelve la política observable y evita que un catch oculto dentro de la tool haga creer al agente que la llamada se ejecutó cuando fue rechazada antes del efecto.
¿Cómo devolver un fallback que el agente pueda tratar?
Un error del breaker no debe parecer un error de argumentos. El executor puede convertir CircuitOpenError en un resultado estructurado, con estado temporal, nombre de la dependencia y siguiente acción permitida. El mensaje que recibe el modelo debe decir que la tool no está disponible, no sugerir un retry inmediato.
type ToolResult =
  | { status: "ok"; value: unknown }
  | { status: "blocked"; reason: "dependency_open"; retryAfterMs: number };

declare function searchService(query: string): Promise<unknown>;

async function callSearchTool(circuit: ToolCircuit, query: string): Promise<ToolResult> {
  try {
    const value = await circuit.run(() => searchService(query));
    return { status: "ok", value };
  } catch (error) {
    if (error instanceof CircuitOpenError) {
      return {
        status: "blocked",
        reason: "dependency_open",
        retryAfterMs: error.retryAfterMs,
      };
    }
    throw error;
  }
}
El fallback puede pedir al agente que responda con lo que ya sabe, use una tool independiente o derive la tarea. No debe prometer que la búsqueda se repetirá de inmediato. Si la operación es necesaria para continuar, persiste el estado y retoma después con una política explícita. La guía sobre ejecución durable para agentes de IA cubre ese límite entre checkpoint y reanudación.
¿Cómo probar las transiciones sin esperar de verdad?
La prueba principal no necesita un proveedor de modelos ni una API real. Usa una operación falsa que falle de forma controlada y un reloj que la prueba pueda avanzar. El objetivo es demostrar el contrato del breaker, no la disponibilidad de la dependencia.
El código siguiente es una fixture ilustrativa compatible con TypeScript, no un cliente listo para producción.
import { strict as assert } from "node:assert";

const clock = { value: 0 };
const counted = (error: unknown) => error instanceof Error && error.message === "down";
const circuit = new ToolCircuit({
  failureThreshold: 2,
  cooldownMs: 100,
  now: () => clock.value,
  shouldCount: counted,
});

const down = async () => { throw new Error("down"); };

await assert.rejects(() => circuit.run(down));
await assert.rejects(() => circuit.run(down));
assert.equal(circuit.getState(), "open");

let calls = 0;
await assert.rejects(() => circuit.run(async () => {
  calls += 1;
  return "should not run";
}));
assert.equal(calls, 0);

clock.value = 100;
assert.equal(circuit.getState(), "half-open");
assert.equal(await circuit.run(async () => "recovered"), "recovered");
assert.equal(circuit.getState(), "closed");
Una cobertura de producción debe añadir cuatro casos: un error no clasificable no abre el circuito, dos sondas simultáneas no pasan juntas, una sonda fallida vuelve a open y un éxito limpia la secuencia de fallos. Si el runtime tiene varias instancias del worker, el estado debe vivir en almacenamiento compartido o cada instancia tendrá una visión distinta de la dependencia.
¿Cómo combinar breaker, retry, timeout y presupuesto?
Estos controles no son sustitutos. Un timeout termina una llamada que tardó demasiado. Un retry decide si un fallo transitorio merece otro intento. Un breaker decide si la dependencia debe recibir la siguiente llamada. Un presupuesto limita lo que una ejecución puede gastar en tokens, tiempo o tools. El artículo sobre cancelar un agente cuando una tool se bloquea cubre timeouts y cancelación; el artículo sobre evitar tool calls duplicadas al cambiar de LLM cubre la repetición durante el failover.
Un orden práctico es aplicar el deadline de la ejecución, revisar el breaker, ejecutar la tool con timeout, clasificar el fallo y solo después decidir si cabe un retry corto. Cuando el breaker se abre, el retry debe detenerse. Cuando se agota el presupuesto, registra stop_reason y no rodees la guarda llamando a la misma tool por otro camino.
Registra los cambios de estado y las llamadas bloqueadas. La guía sobre trazar tool calls de un agente de IA con OpenTelemetry ayuda a relacionar el evento del breaker con runId y la dependencia. Sin esa traza, el equipo solo ve una respuesta incompleta y no sabe si falló el servicio, se abrió el circuito o el modelo siguió intentando después de la apertura.
Checklist del circuit breaker antes de liberar
- ¿El breaker protege una dependencia en lugar de todo el agente?
- ¿La clasificación separa timeouts, límites de velocidad,
5xx, autenticación, validación y recursos inexistentes? - ¿La llamada se rechaza antes de cualquier efecto externo cuando el estado es
open? - ¿
half-openpermite una sonda controlada sin liberar un lote completo? - ¿El modelo recibe un resultado que explica la indisponibilidad sin pedir un retry inmediato?
- ¿La prueba usa un reloj falso y demuestra éxito, fallo, cooldown y concurrencia?
- ¿El estado compartido es consistente cuando trabaja más de un worker?
- ¿Los logs registran dependencia, transición, motivo,
runIdy duración sin secretos? - ¿El fallback define una acción: responder, usar una alternativa, pausar o derivar?
No elijas el umbral porque un ejemplo de internet usó el mismo número. Observa la dependencia detrás de la tool, clasifica los fallos que realmente indican indisponibilidad y prueba la transición antes de permitir efectos importantes. El breaker debe hacer el fallo más pequeño y legible, no convertir cualquier error en silencio.
Cómo se produjo este artículo
Samuel Fajreldines es el autor responsable. La investigación comparó las orientaciones actuales de Microsoft y AWS sobre circuit breakers y retries con documentación de agentes y discusiones públicas recientes. Las discusiones se usaron solo para lenguaje y fallos recurrentes. Una fixture equivalente en JavaScript se ejecutó localmente con un reloj falso y una operación en memoria; el código TypeScript anterior es una adaptación ilustrativa y no llamó a un modelo, proveedor ni servicio externo.
Usé RemoteCode como herramienta del autor para conservar el contexto entre sesiones. Apoyó la investigación y el borrador, pero no ejecutó la fixture ni aportó evidencia de producción.
Fuentes consultadas
- Microsoft Learn, "Circuit Breaker pattern", consultada el 2026-10-22
- AWS Prescriptive Guidance, "Circuit breaker pattern", consultada el 2026-10-22
- AWS Prescriptive Guidance, "Retry with backoff pattern", consultada el 2026-10-22
- Microsoft Learn, "Develop an agentic RAG solution with Azure", consultada el 2026-10-22