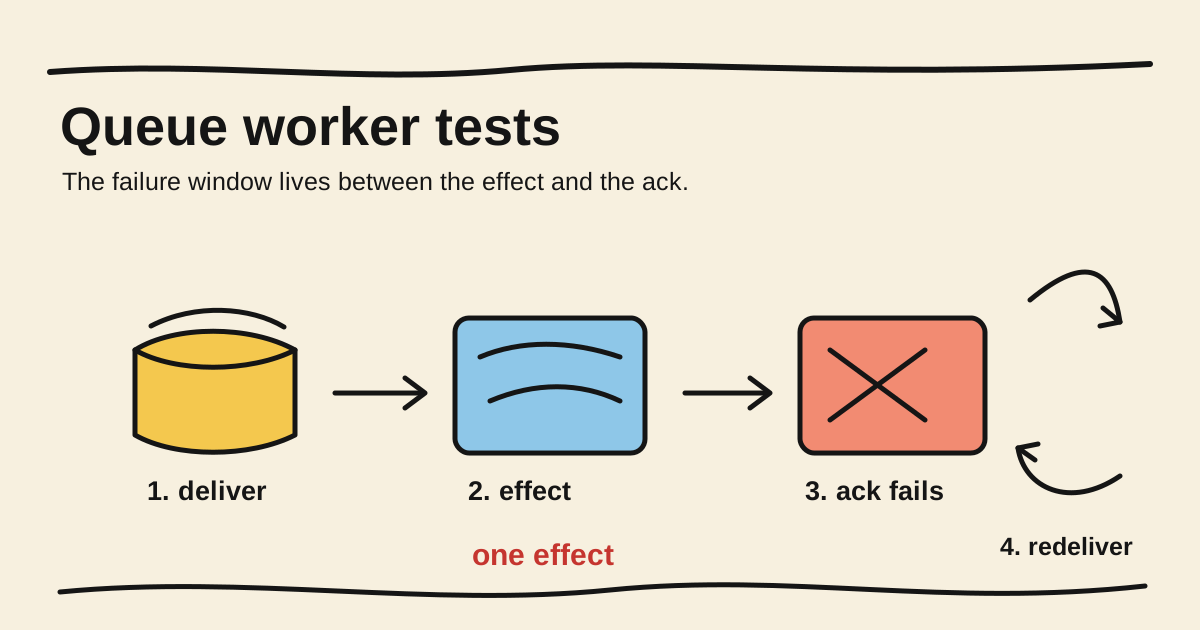
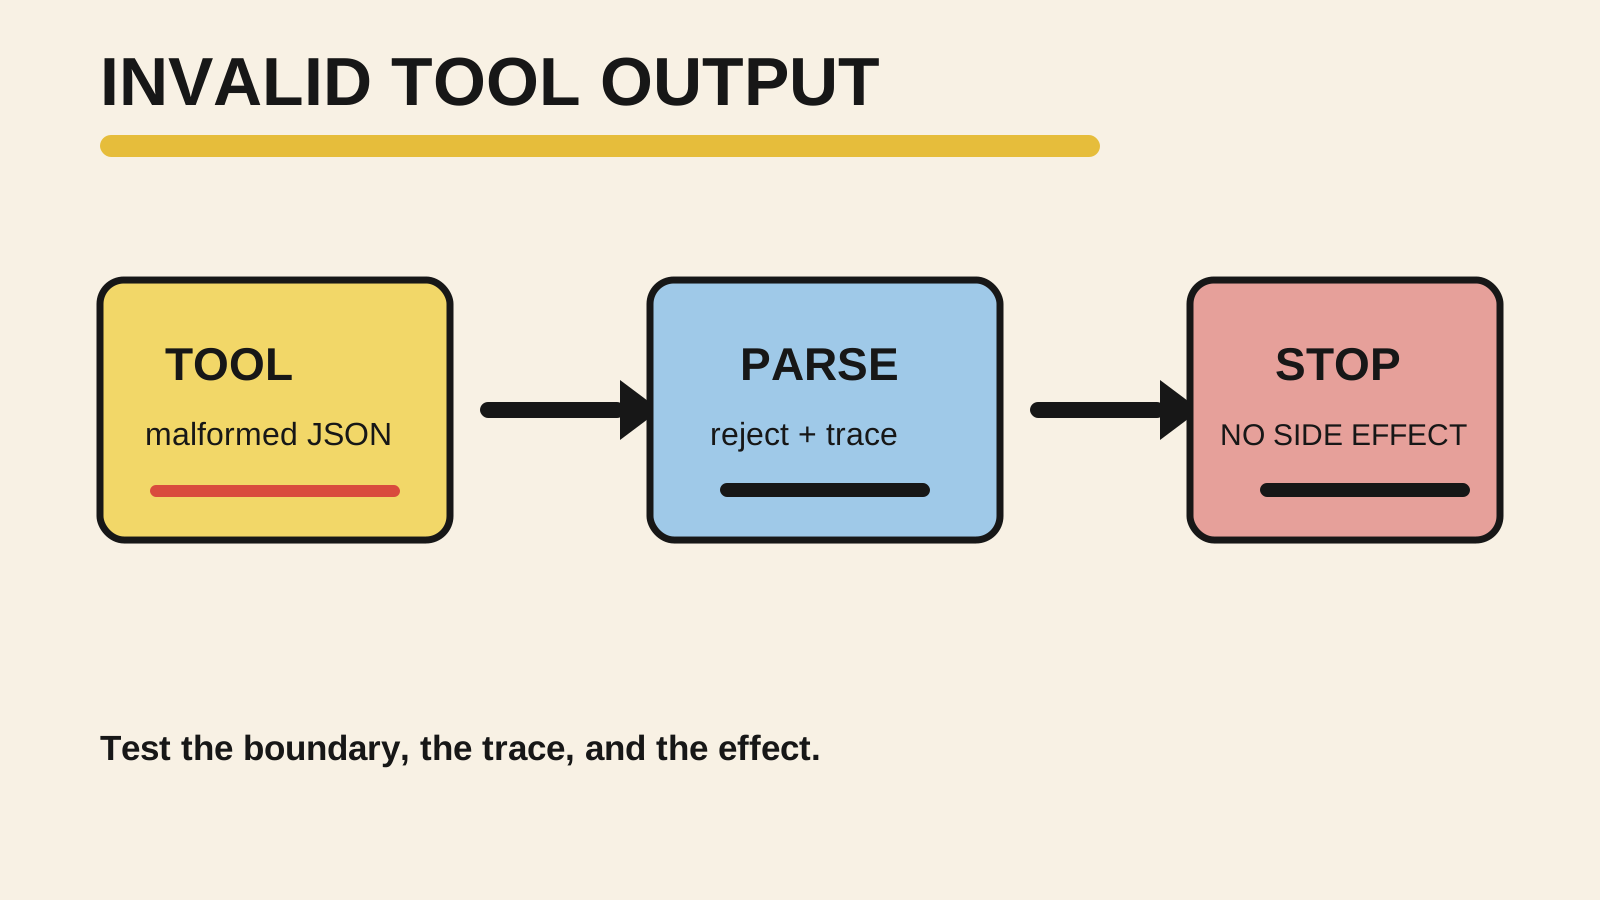
Uma tool pode retornar HTTP 200 e ainda entregar um resultado que o agente não pode usar. O corpo pode ser JSON malformado, ter o tipo errado ou omitir o campo que autoriza a próxima etapa. Para testar esse caso, injete a resposta defeituosa na fronteira da tool e verifique o caminho inteiro, não apenas a frase final do agente.
O teste precisa provar quatro coisas: o parser rejeitou o valor, o trace registrou o motivo, a política de recuperação tomou uma decisão conhecida e nenhuma tool com efeito externo foi chamada. O guia sobre validar tool calls em TypeScript trata do contrato de entrada. Aqui, a pergunta é como testar o que acontece depois que uma tool devolve uma saída que não cumpre o contrato.
Esse recorte também é menor que um eval completo. A avaliação de trajetória de um agente olha para o caminho geral. Para a fronteira de persistência depois de uma proposta, veja como validar a saída antes de salvar. Este teste fixa uma falha de tool e torna a consequência observável: o envio seguinte não pode acontecer.
Resposta curta
- Injete o payload inválido no adaptador da tool, sem depender de uma API ou de um modelo real.
- Separe JSON malformado de JSON válido com schema errado.
- Registre o erro no trace e verifique a política de parada ou recuperação.
- Conte as chamadas da próxima tool e confirme que o efeito ficou em zero.
O que o teste precisa provar?
Não comece pelo texto que o agente mostrou ao usuário. Comece pela fronteira que transforma a resposta da tool em dados internos. O teste deve responder perguntas diferentes:
- O texto pode ser interpretado como JSON?
- O valor interpretado tem o shape que o runtime exige?
- O agente deve parar, pedir correção, tentar novamente ou encaminhar?
- Alguma tool posterior recebeu autorização para produzir um efeito?
JSON.parse() transforma uma string em um valor JavaScript e falha quando a string não representa JSON válido (MDN, JSON.parse()). Isso resolve somente a primeira pergunta. {"accountId":"acct-1"} é JSON válido, mas ainda pode ser insuficiente se o contrato também exige status.
Uma avaliação de agente costuma separar tarefa, tentativa, grader, trace e resultado no ambiente. A Anthropic descreve essas partes em seu guia de evals para agentes, incluindo a diferença entre o que aparece no transcript e o estado final que existe fora dele. Para este caso, o estado final é simples: uma resposta inválida não pode alcançar o efeito de envio.
Injete a falha no lugar certo
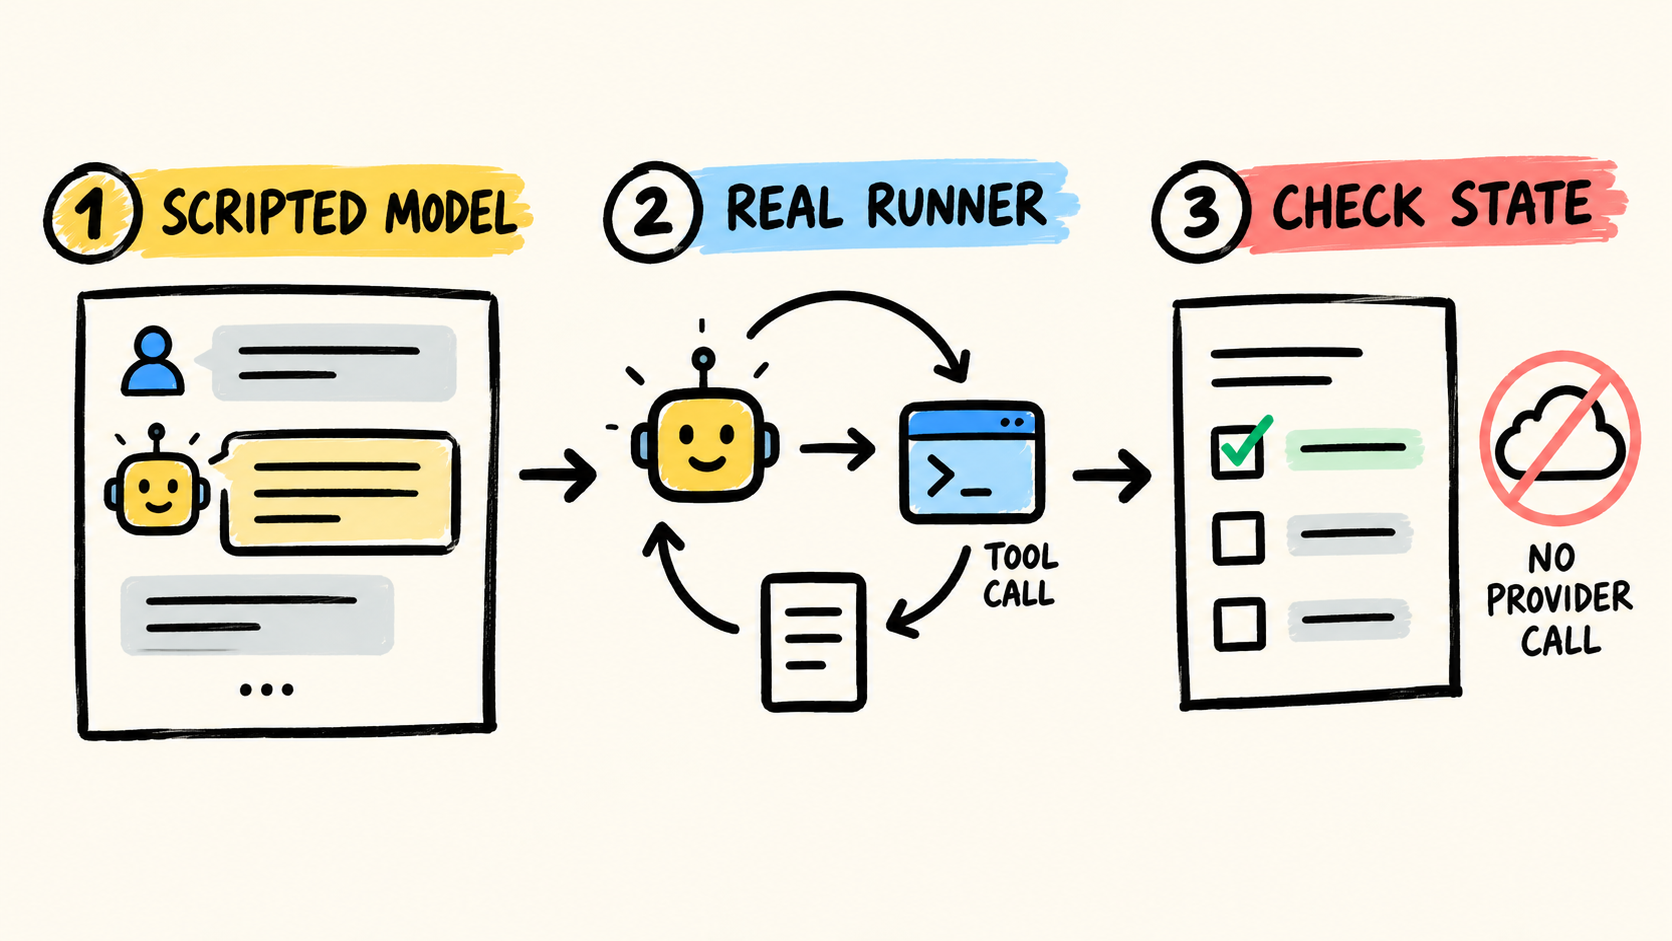
Um mock no nível do modelo não testa a fronteira da tool. Ele pode devolver diretamente o resultado que o código espera e deixar o parser, o trace ou o dispatcher fora do caminho. O ponto de injeção precisa ser o adaptador que o runner realmente chama.
No exemplo, o agente consulta uma conta. Se a conta exigir revisão, ele chama sendEmail. O teste controla lookupAccount, mas mantém o parser, a decisão e a contagem do efeito reais dentro da fixture.
async function runAgent({ lookupAccount, sendEmail }) {
  const trace = [];
  trace.push({ kind: "tool_call", name: "lookup_account" });
  const raw = await lookupAccount({ accountId: "acct-1" });

  try {
    const account = parseAccount(raw);
    trace.push({ kind: "tool_result", name: "lookup_account", status: "valid" });

    if (account.status === "needs_review") {
      await sendEmail({ accountId: account.accountId });
    }

    return { status: "completed", trace };
  } catch (error) {
    trace.push({ kind: "tool_error", name: "lookup_account", code: error.code });
    return { status: "blocked", trace };
  }
}
O trace da fixture não tenta reproduzir o formato de um provedor. Ele registra somente os eventos que o contrato local precisa verificar. Em produção, use o formato de observabilidade que já existe no seu runtime. A documentação da OpenAI sobre avaliação de workflows de agentes usa traces para registrar chamadas de modelo, tools, guardrails e handoffs, e recomenda graders estruturados para encontrar falhas do workflow.
O importante é que sendEmail não esteja escondida dentro do mock de lookupAccount. Se o teste controla as duas funções de tal forma que nunca existe um caminho entre elas, ele não consegue provar que uma resposta inválida bloqueia o efeito.
Faça o caso ser executável com node:test
O runner nativo do Node.js permite executar o caso sem instalar um framework adicional. A documentação do Node.js node:test inclui o runner, asserções e recursos de mocking. A fixture abaixo usa apenas node:test e node:assert/strict.
import { test } from "node:test";
import assert from "node:assert/strict";

class ToolOutputError extends Error {
  constructor(code) {
    super(code);
    this.code = code;
  }
}

function parseAccount(raw) {
  let value;
  try {
    value = JSON.parse(raw);
  } catch {
    throw new ToolOutputError("invalid_json");
  }

  if (
    !value ||
    typeof value !== "object" ||
    typeof value.accountId !== "string" ||
    typeof value.status !== "string"
  ) {
    throw new ToolOutputError("invalid_shape");
  }

  return value;
}

// Inclua runAgent do exemplo anterior no mesmo arquivo.
test("JSON malformado para antes do efeito", async () => {
  let sent = 0;
  const result = await runAgent({
    lookupAccount: async () => '{"accountId":"acct-1"',
    sendEmail: async () => { sent += 1; },
  });

  assert.equal(result.status, "blocked");
  assert.equal(sent, 0);
  assert.deepEqual(result.trace.at(-1), {
    kind: "tool_error",
    name: "lookup_account",
    code: "invalid_json",
  });
});

test("JSON válido com shape errado também é rejeitado", async () => {
  let sent = 0;
  const result = await runAgent({
    lookupAccount: async () => JSON.stringify({ accountId: "acct-1" }),
    sendEmail: async () => { sent += 1; },
  });

  assert.equal(result.status, "blocked");
  assert.equal(sent, 0);
  assert.equal(result.trace.at(-1).code, "invalid_shape");
});

test("saída válida chega ao efeito somente com a pré-condição", async () => {
  let sent = 0;
  const result = await runAgent({
    lookupAccount: async () => JSON.stringify({
      accountId: "acct-1",
      status: "needs_review",
    }),
    sendEmail: async () => { sent += 1; },
  });

  assert.equal(result.status, "completed");
  assert.equal(sent, 1);
});
Salve o trecho em um arquivo .mjs que também contenha runAgent e execute:
node --test invalid-tool-output.test.mjsNa minha execução local de 10 de novembro de 2026, com Node.js v25.5.0, os três casos passaram. Isso é uma prova da fixture em memória: ela alcança as três decisões que o código declara. Não é um teste do provedor de modelo, de uma API externa ou da entrega de e-mail.
Asserte o erro, o caminho e o efeito
Um teste fraco verifica somente que uma exceção foi lançada. Isso pode deixar o runtime sem uma saída tratável. Outro teste fraco verifica apenas status: "blocked", mas não confirma se uma chamada de escrita já aconteceu antes do bloqueio.
Use asserções em camadas:
- Erro de fronteira:
invalid_jsoneinvalid_shapesão códigos diferentes. O operador precisa saber se deve investigar transporte, parser ou contrato. - Traço: o trace contém a chamada original e o evento de erro. Isso ajuda a distinguir uma tool que falhou de uma tool que nunca foi registrada.
- Política: a execução termina como
blocked, é encaminhada ou entra em uma tentativa limitada, conforme o contrato. Não aceite uma mensagem final como substituto dessa decisão. - Efeito externo: o contador de
sendEmail, uma lista de comandos ou uma fixture de banco permanece inalterado quando a pré-condição não foi provada.
Esse formato também evita exigir uma sequência rígida quando há mais de um caminho seguro. O teste precisa fixar a invariável, como "não enviar sem uma conta válida", e não necessariamente cada frase que o modelo poderia escrever. Quando a escolha do modelo fizer parte do risco, acrescente um eval com o modelo e um grader separado. O teste local continua responsável pela fronteira determinística.
Amplie a matriz sem misturar as camadas
Depois dos três casos básicos, acrescente falhas que respondam a perguntas diferentes:
| Cenário | O que injetar | O que verificar |
|---|---|---|
| JSON malformado | String truncada ou aspas sem fechar | Parser rejeita, trace registra invalid_json, efeito fica em zero |
| JSON com shape errado | Campo obrigatório ausente ou tipo inesperado | Schema rejeita antes do dispatcher seguinte |
| JSON válido, valor errado | status desconhecido ou ID incompatível |
Runtime não transforma validade sintática em autorização |
| Erro de transporte | Timeout ou conexão recusada | Política diferencia falha de rede de resposta inválida |
| Recuperação | Segunda resposta válida após uma falha | Retry é limitado e a tool de efeito não duplica a operação |
| Modelo real | Tool error devolvido ao modelo | O agente escolhe parar ou corrigir dentro do limite esperado |
O teste de unidade pode usar funções em memória. Um teste de contrato deve conferir o formato que o adaptador realmente recebe. Um teste de integração pode conectar uma API de teste e verificar o sistema de registro. Um eval com modelo real deve observar o trace e o estado, porque o modelo pode responder de modo plausível sem ter corrigido o problema.
Não transforme a tabela em uma lista de mocks para sempre. Cada caso deve ficar perto da fronteira que ele pretende proteger. O post sobre como testar regressões em agentes sem comparar texto exato ajuda quando o problema deixa de ser um payload específico e passa a ser um comportamento que precisa continuar estável.
Falhas que deixam o teste verde
Validar somente o parser
assert.throws(() => JSON.parse(raw)) prova que o parser reconhece a entrada ruim. Não prova que o runner registra o erro, encerra o turno ou impede a próxima tool. Mantenha a chamada do parser dentro do caminho que o agente usa.
Mockar o runner inteiro
Se o mock devolve diretamente { status: "blocked" }, o teste não exercita a decisão. Substitua o modelo ou o adaptador externo, mas deixe o dispatcher, o parser, o trace e a asserção de efeito reais.
Conferir somente a resposta final
Uma frase como "não consegui concluir" não informa se o agente já enviou o e-mail antes de escrevê-la. Conte a operação, confira a fixture externa e registre a sequência de eventos.
Retentar qualquer erro do mesmo jeito
Uma saída inválida pode ser corrigível, mas o retry precisa ter orçamento e uma nova entrada verificável. Se cada tentativa reenviar a mesma resposta malformada, o teste deve terminar com um limite explícito, não com um loop.
Usar uma ferramenta de escrita no caso de unidade
Para testar a política, um sendEmail falso com contador é suficiente. Deixe SMTP, banco ou fila para o teste que precisa provar a integração. Assim, um caso local não dispara efeitos reais por acidente.
Checklist para o CI
- A falha é injetada na fronteira que o runner realmente chama?
- O conjunto separa JSON malformado, shape errado, valor inválido e erro de transporte?
- O trace registra a tool, o motivo e o
runIdsem guardar segredo ou payload sensível? - O teste verifica a política de parada, retry limitado ou encaminhamento?
- Existe uma asserção sobre a tool de efeito e sobre o estado externo?
- O caso continua determinístico sem depender de rede, relógio ou chamada de modelo?
- O teste de contrato cobre o formato real do adaptador?
- Existe pelo menos um eval separado para decisões que dependem do modelo?
- O caso falha quando o código chama a tool de efeito antes de validar a resposta?
Um teste de saída inválida é pequeno, mas protege uma fronteira importante. Ele não precisa saber se o modelo é bom. Precisa mostrar que o sistema não transforma uma resposta que não pode provar em permissão para alterar o mundo.
Como este artigo foi produzido
Samuel Fajreldines é o autor responsável. A pesquisa comparou a documentação atual de avaliação de agentes da OpenAI e da Anthropic com a documentação do runner node:test e discussões públicas recentes. As discussões ajudaram a escolher a linguagem de falha; não foram usadas como prova técnica.
Executei localmente uma fixture em memória com Node.js v25.5.0. Ela injeta JSON malformado, JSON com shape incompleto e uma resposta válida. O resultado observado foi de três testes aprovados. A fixture não chamou um modelo, um provedor, uma conta externa ou um serviço de e-mail.
Usei o RemoteCode como ferramenta do autor para organizar contexto e revisar a estrutura. Ele não executou os testes nem forneceu evidência de produção.