Quando um agente falha depois de chamar uma API, consultar um banco ou alterar um sistema externo, repetir o prompt raramente reproduz a falha. O modelo pode responder diferente, a API pode ter mudado e a própria execução pode ter consumido outro estado.
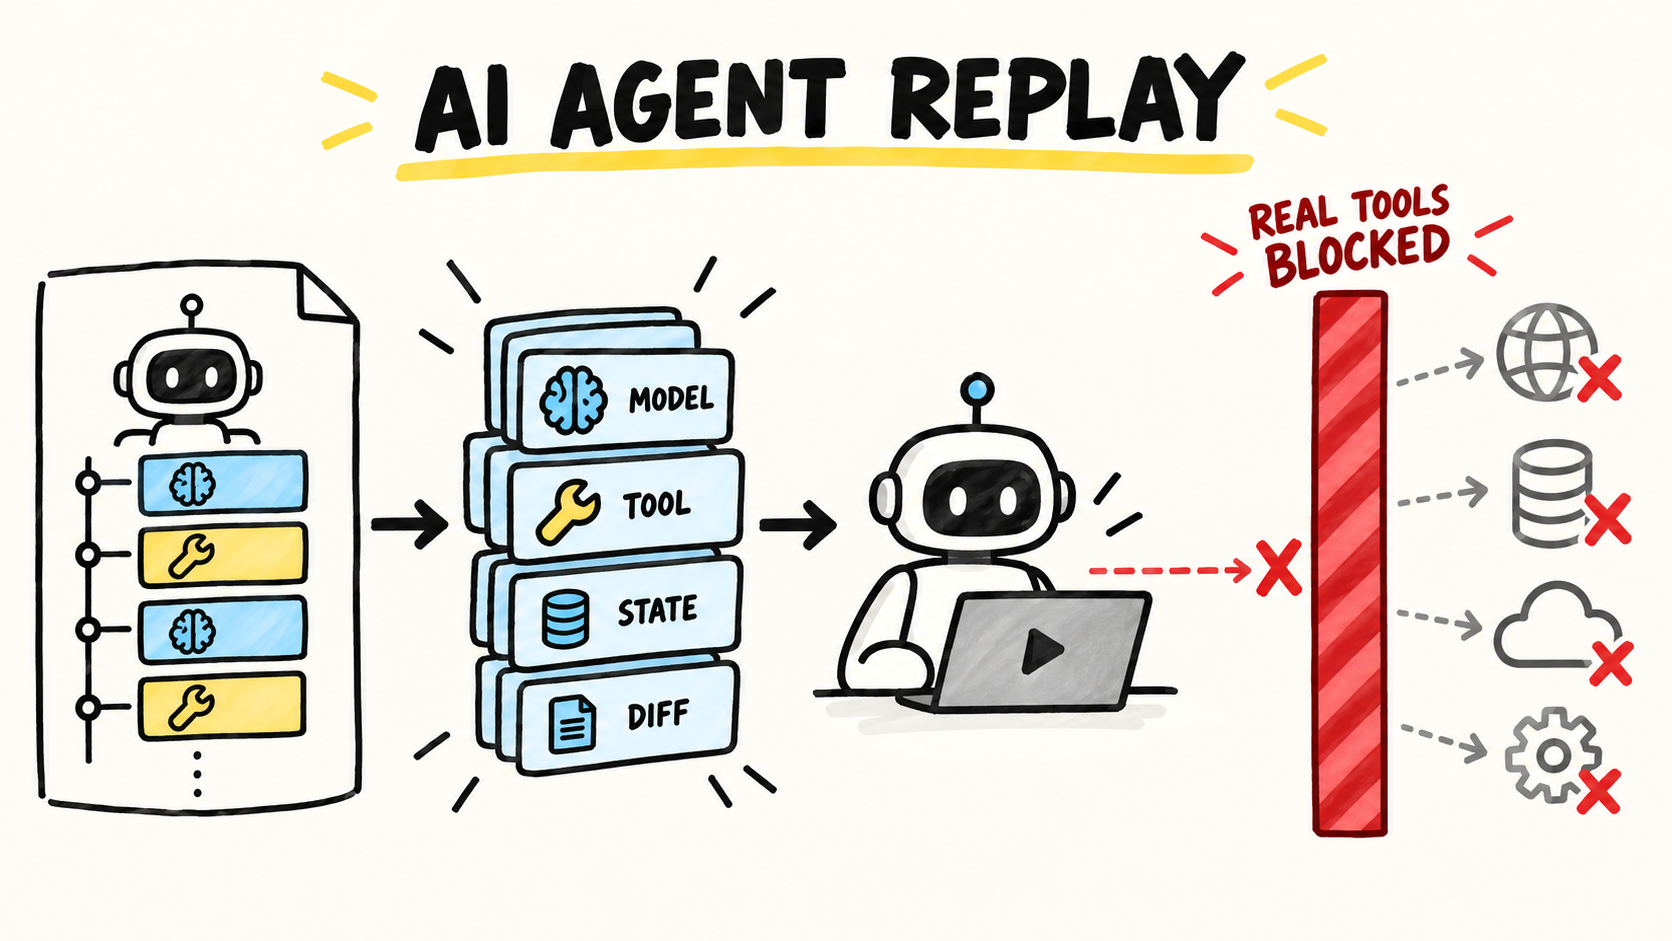
O replay resolve um problema mais específico: reconstruir uma execução a partir dos eventos gravados, substituir o modelo e as tools por respostas registradas e interromper a tentativa de alcançar efeitos reais. Assim, você consegue inspecionar a primeira divergência sem transformar o diagnóstico em uma nova operação de produção.
Este artigo mostra o mecanismo, o formato mínimo de um cassette e um fixture executável em JavaScript. Para organizar a fronteira entre estado, ferramentas e retomada, vale relacionar este fluxo ao modelo de execução durável para agentes de IA. Replay é diagnóstico de uma execução conhecida; não é retomada de uma execução interrompida.
Resposta curta: grave as entradas e saídas de cada fronteira relevante, dê ao replay somente esses eventos, faça qualquer adapter de tool real falhar explicitamente e compare a execução até a primeira divergência.
Replay não é retomar uma execução
Há três problemas parecidos que precisam de contratos diferentes:
| Mecanismo | Pergunta que responde | O que acontece com o mundo externo? |
|---|---|---|
| Observabilidade | O que aconteceu e em que etapa? | A execução original já pode ter produzido efeitos. |
| Replay | Como reproduzo o comportamento observado? | As respostas externas vêm de fixtures ou cassetes. |
| Retomada | Como continuo depois de uma interrupção? | O sistema precisa conhecer checkpoints, efeitos confirmados e política de retry. |
Um trace ajuda a localizar uma etapa, mas não é necessariamente suficiente para reexecutá-la. As convenções de traces do OpenTelemetry descrevem spans e atributos para observar operações. Um cassette de replay precisa ir além: guardar os dados necessários para responder novamente às fronteiras que o agente atravessaria.
Isso também explica por que um log de auditoria não deve ser usado automaticamente como fixture. O registro de auditoria de um agente de IA pode ser minimizado ou redigido para prestação de contas, enquanto o replay precisa de dados suficientes para reproduzir uma decisão. Os dois podem compartilhar eventos, mas têm objetivos e controles de retenção diferentes.
O que gravar durante a execução
Comece pelas fronteiras que podem mudar o próximo passo. Em uma execução típica, elas são:
- a entrada normalizada do agente e a configuração que influencia o planejamento;
- a requisição e a resposta do modelo, incluindo o identificador do modelo e as opções relevantes;
- o nome, os argumentos, o resultado ou o erro de cada tool;
- resultados de busca, recuperação de documentos e leituras de estado que mudam a decisão;
- relógio, números aleatórios e identificadores gerados, somente quando a execução depende deles.
Não grave tudo por reflexo. O payload bruto de uma tool pode conter token, dado pessoal ou segredo. Crie uma política que separe o valor necessário para reproduzir a decisão do valor que deve ser removido, mascarado ou substituído por um marcador. A convenção de atributos GenAI do OpenTelemetry é útil para nomear partes do evento, mas não substitui sua política de privacidade nem torna um trace um cassette pronto.
Um evento precisa ter uma identidade estável e uma ordem verificável. Um formato inicial pode ser:
{
  "runId": "run-2026-10-15-001",
  "events": [
    {
      "seq": 1,
      "kind": "model",
      "requestHash": "sha256:...",
      "response": { "tool": "lookupOrder", "args": { "id": "ord-7" } }
    },
    {
      "seq": 2,
      "kind": "tool",
      "name": "lookupOrder",
      "argsHash": "sha256:...",
      "response": { "status": "ready" }
    }
  ]
}
O hash ajuda a descobrir que o replay recebeu uma entrada diferente. Ele não é uma prova de integridade sozinho: defina o algoritmo, normalize os dados antes do hash e proteja o cassette contra alterações não autorizadas.
Como bloquear tools reais no replay
O bloqueio precisa estar no caminho de execução, e não apenas em uma convenção no nome do teste. Um adapter real que pode enviar e-mail, criar pedido ou apagar registro deve ser impossível de alcançar quando o modo é replay.
O fixture abaixo usa o módulo de testes do Node, cuja API oficial permite executar o caso com node --test. O agente recebe um adapter real, mas o replay nunca o chama. Em vez disso, consome a sequência gravada e falha assim que a etapa esperada não corresponde ao evento disponível.
const assert = require("node:assert/strict");
const test = require("node:test");

const cassette = [
  { kind: "model", response: { tool: "lookupOrder", args: { id: "ord-7" } } },
  { kind: "tool", name: "lookupOrder", response: { status: "ready" } },
  { kind: "model", response: { final: "O pedido está pronto." } },
];

function createReplay(events) {
  let cursor = 0;

  return {
    next(expectedKind) {
      const event = events[cursor];
      if (!event || event.kind !== expectedKind) {
        throw new Error(
          `primeira divergência no evento ${cursor}: esperado ${expectedKind}`,
        );
      }
      cursor += 1;
      return event;
    },
    done() {
      assert.equal(cursor, events.length, "o replay deixou eventos sem consumir");
    },
  };
}

async function runInReplay(replay, realTool) {
  const plan = replay.next("model");
  const recordedTool = replay.next("tool");

  assert.equal(recordedTool.name, plan.response.tool);
  assert.deepEqual(recordedTool.response, { status: "ready" });

  // Esta função existe para tornar uma chamada acidental detectável.
  void realTool;

  const final = replay.next("model");
  replay.done();
  return final.response.final;
}

test("replay usa o cassette e não chama a tool real", async () => {
  let realCalls = 0;
  const realTool = async () => {
    realCalls += 1;
    throw new Error("tool real alcançada durante o replay");
  };

  const result = await runInReplay(createReplay(cassette), realTool);

  assert.equal(result, "O pedido está pronto.");
  assert.equal(realCalls, 0);
});
Há duas propriedades importantes nesse exemplo. A primeira é negativa: se a tool real for chamada, o teste precisa falhar. A segunda é diagnóstica: o cursor aponta o primeiro evento que deixou de combinar. Um erro no final da execução pode ser apenas consequência de uma divergência que aconteceu muitos passos antes.
Em um agente de produção, o createReplay normalmente é um dispatcher mais completo. Ele deve verificar a identidade da operação, os argumentos normalizados, a versão do schema e a sequência. Se uma resposta gravada não existir, o modo seguro é falhar com contexto, não fazer fallback silencioso para a API real.
Como encontrar a primeira divergência
Compare eventos em uma ordem que preserve causalidade. Uma diferença no texto final costuma ser pouco informativa. Uma diferença no argumento de uma tool, no resultado de uma busca ou no estado que alimentou a decisão costuma ser mais útil.
Registre pelo menos:
- a posição do evento;
- o tipo de fronteira, como
model,tool,retrievaloustate; - a identidade da operação;
- uma representação redigida da entrada esperada e recebida;
- a origem da resposta, como
cassette,fixtureoulive, sendoliveproibido no replay.
Não compare automaticamente todo campo volátil. Timestamp, token de rastreamento e identificador aleatório podem divergir sem mudar o comportamento. Por outro lado, ignorar o argumento de uma tool pode esconder justamente o defeito que você procura. Defina equivalência por tipo de evento e documente quais campos são semânticos.
Depois de uma mudança no agente, faça um replay dos casos importantes e agrupe as falhas pela primeira divergência. O teste de regressão de agentes sem comparar texto exato ajuda a transformar essa diferença em uma asserção de comportamento. O replay fornece o caminho concreto; o teste de regressão impede que a correção desapareça na próxima alteração.
Retenção, redaction e fork seguro
Um cassette pode conter mais informação do que o log que você costuma guardar. Antes de persistir, defina:
- quais campos são secretos, pessoais ou regulados;
- quem pode ler, exportar e invalidar o cassette;
- por quanto tempo ele é útil para o diagnóstico;
- como marcar a versão do prompt, do schema e das tools;
- como impedir que uma edição do cassette pareça uma execução original.
Para investigar uma hipótese, prefira criar um fork imutável. O replay original deve continuar sendo referência do incidente. A alteração do fork precisa aparecer como uma nova entrada, com a causa da mudança e o resultado observado. Isso evita confundir “a execução que ocorreu” com “o comportamento que eu gostaria de testar”.
Se o cassette foi produzido por uma execução que continha efeitos reais, o replay não desfaz esses efeitos. Ele apenas evita novos efeitos. Para entender e verificar esse limite, observe a execução do agente e suas tool calls e mantenha a trilha de auditoria separada do material usado para simulação.
Quando o replay deve virar teste de regressão
Nem todo cassette merece entrar na suíte. Promova-o quando ele representar uma falha importante, uma decisão de negócio sensível ou uma fronteira que já quebrou antes. Remova dados que não são necessários para a asserção e mantenha a expectativa no nível do comportamento:
- a tool correta foi escolhida;
- os argumentos respeitaram o contrato;
- uma resposta de erro levou ao fallback esperado;
- nenhum efeito proibido ocorreu;
- o estado final relevante foi alcançado.
Não congele uma resposta do modelo como verdade eterna. Um replay pode testar a reação do sistema a uma resposta específica, mas não prova que o modelo continuará produzindo aquela resposta em produção. Separe o teste do dispatcher, o teste de contrato da tool e a avaliação do comportamento do modelo quando a pergunta for outra.
O que este método não prova
Replay é uma aproximação controlada, não uma cópia do mundo. Ele não prova que:
- a API externa continuará disponível ou com o mesmo contrato;
- o estado real do banco ou do serviço ainda será igual;
- latência, concorrência e limites de taxa terão o mesmo efeito;
- o modelo produzirá a mesma saída fora do cassette;
- uma tool side effecting é segura para executar novamente.
A pesquisa recente sobre replay determinístico em sistemas de agentes trata justamente das fontes de não determinismo que ficam entre o modelo, as APIs externas e o ambiente. Projetos de código aberto como agentrr também tornam explícita a ideia de capturar fronteiras de modelo, tool, relógio e aleatoriedade para uma execução offline. Essas referências ajudam a validar o desenho do mecanismo, mas não substituem os testes do seu adapter nem uma política de dados adequada ao seu sistema.
Perguntas rápidas
Posso fazer replay só com o trace?
Às vezes, não como regra. Se o trace contém todas as entradas e saídas necessárias, ele pode ser a base do cassette. Se contém apenas duração, nomes de spans e identificadores, ainda faltam respostas para reconstruir a decisão.
Devo chamar o modelo real durante o replay?
Não quando o objetivo é reproduzir uma execução específica. Chamar o modelo novamente transforma o replay em uma nova execução sujeita a outra saída. Faça um teste separado quando quiser medir o comportamento atual do modelo diante da mesma entrada.
Como evito que uma tool real escape?
Faça o adapter de produção falhar por padrão em modo replay, injete implementações de cassette e mantenha um teste que conte ou proíba chamadas reais. A proteção precisa existir também em CI, não apenas na máquina do desenvolvedor.
Como este artigo foi produzido
Sou Samuel Fajreldines, autor deste site. A parte executável foi desenhada como um fixture local, sem chamada a provedor de modelo, banco ou API externa. O teste verifica que a sequência gravada é consumida, que a resposta final é preservada e que o adapter real não é chamado. Isso prova o contrato do exemplo, não a segurança de um runtime de produção.
Quando uma sessão precisa continuar visível entre máquinas e sessões, uso o RemoteCode como ferramenta do autor. Essa ferramenta não foi usada para executar o fixture nem é evidência de desempenho do método descrito aqui.
Fontes consultadas
- OpenTelemetry: traces, consultado em 15 de outubro de 2026.
- OpenTelemetry: convenções semânticas para GenAI, consultado em 15 de outubro de 2026.
- Node.js: test runner, consultado em 15 de outubro de 2026.
- Deterministic Replay for AI Agent Systems, consultado em 15 de outubro de 2026.
- agentrr: deterministic record and replay, consultado em 15 de outubro de 2026.
As discussões em comunidades de desenvolvedores ajudaram a identificar a linguagem do problema, especialmente a diferença entre cachear respostas de tools e retomar uma sessão. Elas foram usadas como sinal de discurso, não como prova técnica.