Um botão de aprovação não prova que um agente esperou. A tool pode ter sido executada antes da decisão, o executor pode ter usado argumentos diferentes ou uma retomada pode repetir o efeito.
O teste precisa separar duas perguntas: qual decisão a política registrou e o que aconteceu no sistema externo. O guia sobre quando um agente deve pedir aprovação humana explica o desenho do gate. Aqui, o foco é provar que ele funciona sob aprovação, rejeição, mudança e reinício.
Resposta curta
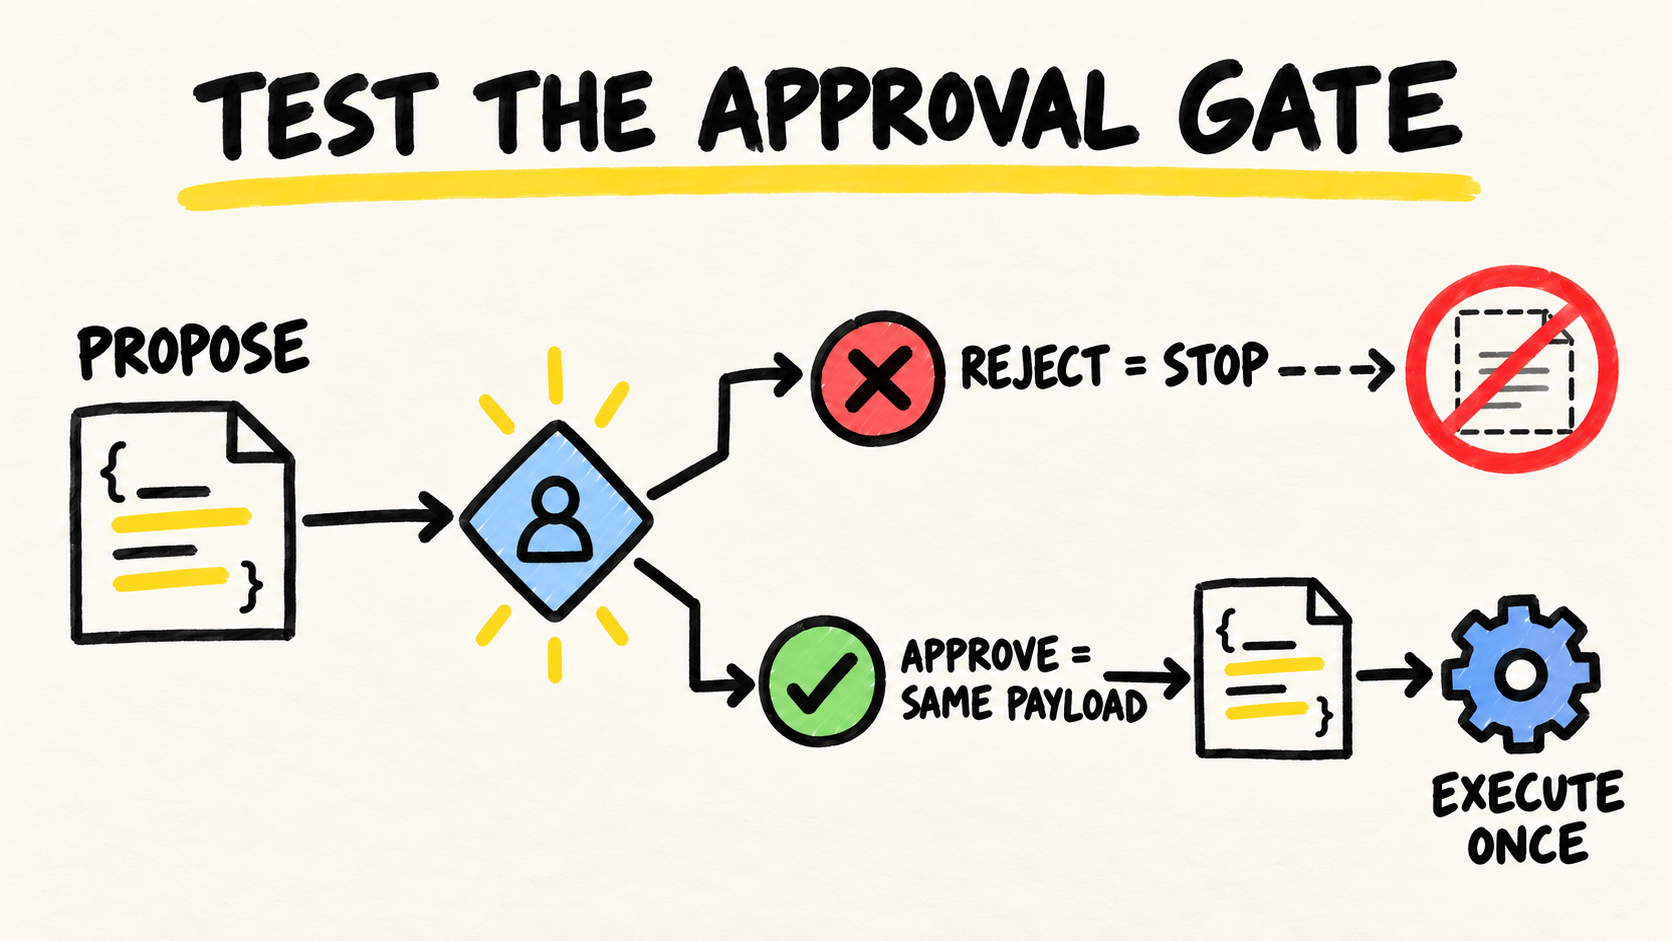
- Uma chamada pendente não pode produzir efeito antes da decisão.
- Rejeitar ou expirar a aprovação deve deixar o contador de efeitos em zero.
- Aprovar deve executar o mesmo payload que a pessoa viu, uma vez.
- Alterar alvo, argumentos ou versão da política deve exigir nova decisão.
O que o teste precisa provar?
O guia de human-in-the-loop do OpenAI Agents SDK descreve um fluxo em que a chamada que precisa de aprovação não executa, o run retorna uma interrupção e o estado pode ser retomado depois. Isso dá o contrato mínimo: pendência antes do efeito, decisão explícita e retomada do mesmo run.
Não teste apenas se a interface exibiu a pergunta. Registre a chamada proposta, a decisão, o payload normalizado e o estado do recurso que poderia mudar. Um teste verde deve dizer se a política decidiu corretamente e se o executor respeitou essa decisão.
Uma matriz pequena já encontra falhas importantes:
| Caso | Decisão esperada | Efeito esperado |
|---|---|---|
| Ação sem risco que a política permite | allow |
Uma execução válida |
| Ação que exige revisão | pending |
Nenhum efeito enquanto aguarda |
| Revisor rejeita | deny |
Nenhum efeito |
| Revisor aprova o payload original | allow |
Um efeito, com os mesmos argumentos |
| Payload muda depois da aprovação | deny ou nova pendência |
Nenhum efeito com o payload alterado |
| Retomada repetida | decisão já consumida | No máximo um efeito |
Como testar a decisão sem chamar o serviço real?
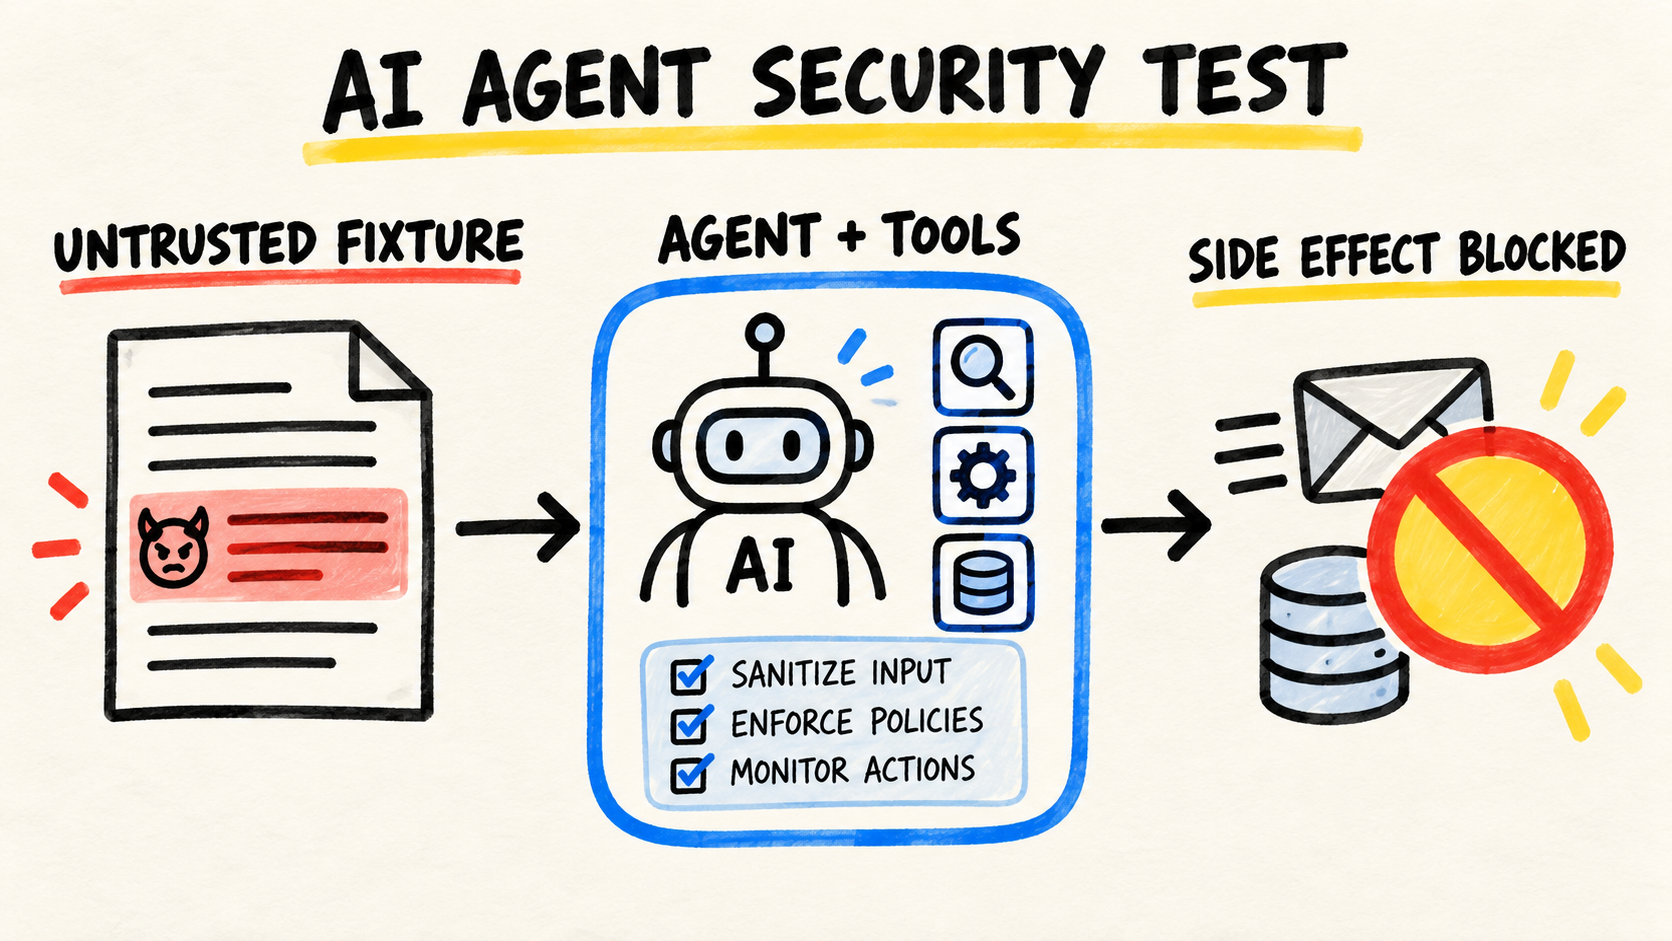
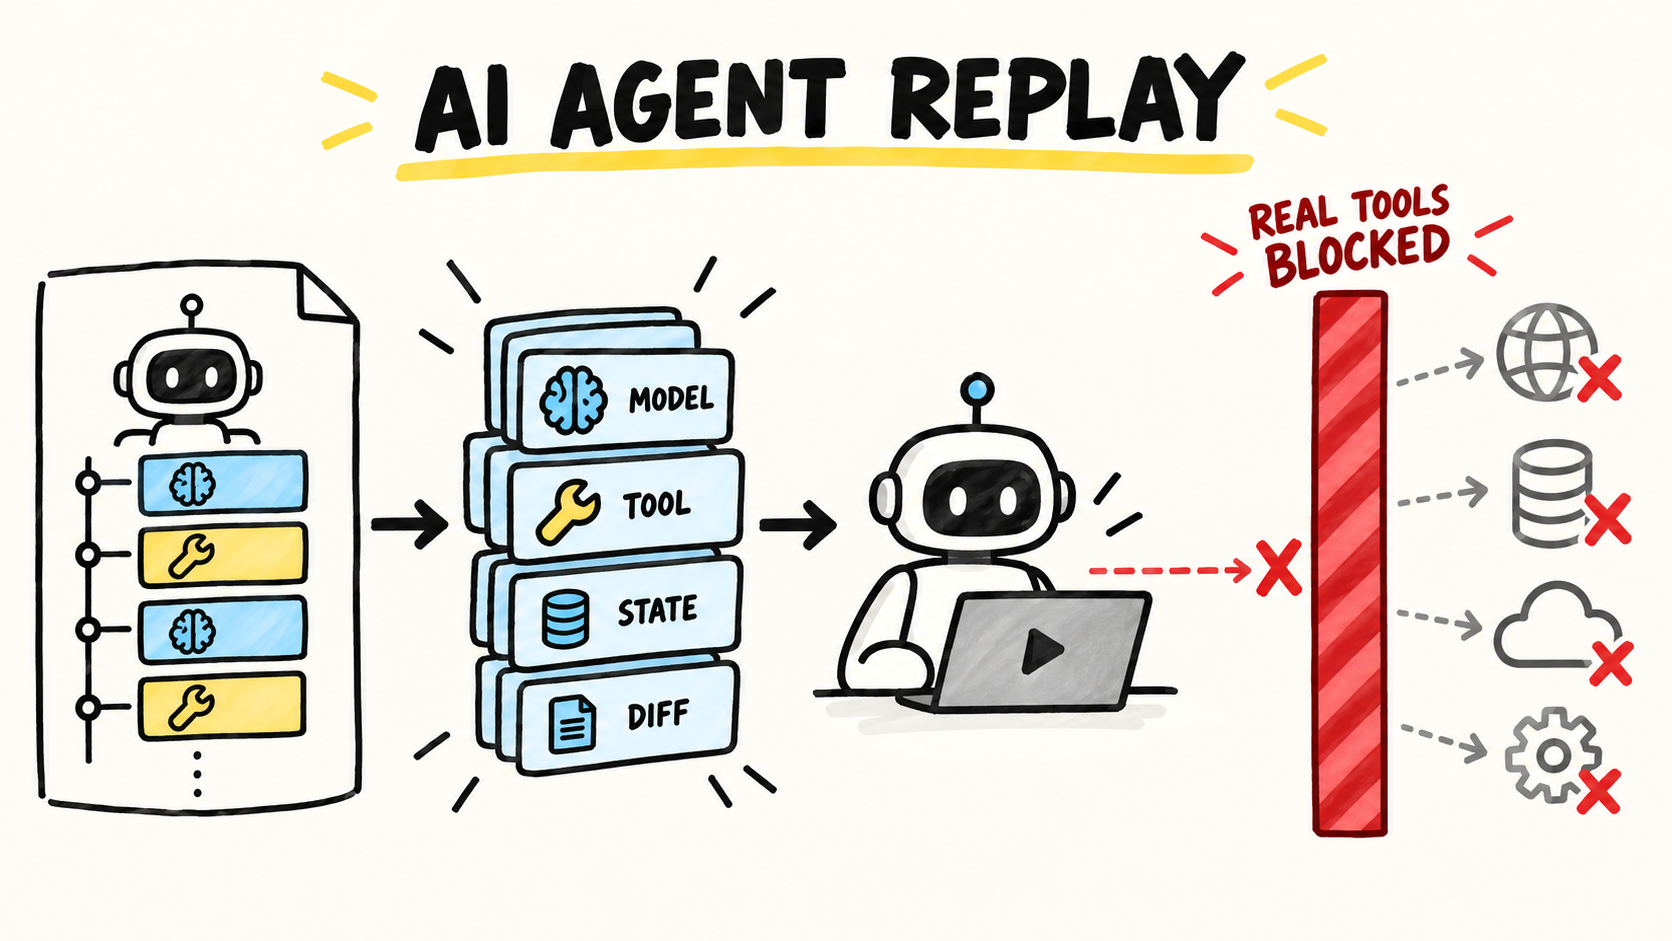
Comece por um executor falso. O teste não precisa enviar e-mail, alterar um CRM ou apagar um registro para provar que a política bloqueia a ação. Ele precisa receber a mesma chamada que o executor real receberia e deixar uma evidência simples quando seria alcançado.
O guia de testes do OpenAI Agents SDK recomenda utilitários determinísticos para testar o workflow sem chamadas ao provedor. A fronteira é útil aqui: o modelo pode propor uma chamada em um teste de integração, mas a regra de aprovação e o executor devem ter testes previsíveis.
Este é um esqueleto ilustrativo de uma fixture. A aplicação real precisa persistir o estado e definir sua própria identidade de revisor.
type Action = { tool: string; target: string; body: string };
type Pending = { id: string; action: Action; status: "pending" | "used" | "rejected" };

const effects: Action[] = [];
const pending = new Map<string, Pending>();

function propose(action: Action): Pending {
  const item = { id: "approval-1", action, status: "pending" as const };
  pending.set(item.id, item);
  return item;
}

function resume(id: string, decision: "approve" | "reject", action: Action) {
  const item = pending.get(id);
  if (!item || item.status !== "pending") throw new Error("stale approval");
  if (JSON.stringify(item.action) !== JSON.stringify(action)) {
    throw new Error("payload changed");
  }
  if (decision === "reject") {
    item.status = "rejected";
    return;
  }
  item.status = "used";
  effects.push(action);
}
O ponto não é comparar objetos com JSON.stringify em produção. O ponto é tornar explícita a relação entre identificador da pendência, payload aprovado e consumo único. Use uma comparação canônica, uma versão de política e uma transação ou chave idempotente apropriada ao armazenamento escolhido.
Como provar que a rejeição bloqueia o efeito?
Envie uma chamada que normalmente escreveria em um adapter falso. Antes de retomar, afirme que o estado é pending e que o adapter ainda não foi chamado. Depois rejeite a chamada e confira as duas coisas: a decisão registrada é negativa e o estado externo continua igual.
Essa separação evita um falso verde. Um log pode dizer denied enquanto outro caminho usa a mesma credencial e executa a operação. O método de teste de políticas da WorkOS recomenda conferir o veredito e o estado produzido pelo serviço separadamente. A recomendação é geral, mesmo quando o serviço não é e-mail.
Inclua pelo menos estes casos:
- rejeição explícita antes do executor;
- expiração ou timeout sem liberação automática;
- erro na tela de aprovação sem fallback para execução;
- caminho alternativo que tenta chamar a mesma tool sem passar pelo gate.
Se qualquer caso alterar o contador, a caixa de saída ou o registro de teste, a aprovação está apenas na interface. O gate precisa estar na fronteira do executor, onde cada chamada mutável passa antes do efeito.
Como testar uma aprovação com payload alterado?
A aprovação pertence a uma ação concreta, não a uma intenção vaga. Aprove um payload e altere um campo antes da retomada: destinatário, valor, registro, mensagem ou escopo. O executor deve recusar a chamada ou criar uma nova pendência.
Essa é uma das falhas mais fáceis de esconder. O revisor vê "enviar o resumo para a equipe", mas o runtime busca novos dados e reconstrói o corpo depois do clique. Se o teste comparar apenas o texto exibido na tela, ele não percebe a troca.
Guarde na pendência o que o revisor realmente aprovou:
- nome e versão da tool;
- identidade do agente e do usuário;
- alvo e argumentos normalizados;
- versão da política;
- prazo da decisão;
- identificador que liga proposta, aprovação e efeito.
Quando a aplicação atualiza qualquer campo protegido, invalide a aprovação. Não tente manter a decisão porque a mudança parece pequena. O teste precisa tornar a regra observável, e a política pode decidir depois se uma nova revisão é automática ou obrigatória.
Como testar retomada, reinício e execução única?
Uma aprovação que vive apenas na memória do worker desaparece no reinício. O SDK mostra a retomada a partir do mesmo estado do run e recomenda manter o estado no servidor quando a aprovação pode demorar. O teste deve simular esse intervalo, não apenas aprovar na mesma função que criou a pendência.
Faça a sequência em etapas:
- Crie a pendência e persista uma representação serializável.
- Encerre o processo ou descarte o objeto em memória.
- Leia o estado em um novo contexto de execução.
- Aprove ou rejeite com a identidade esperada.
- Retome duas vezes e confira que o efeito aparece no máximo uma vez.
O último passo é importante porque a resposta da API pode desaparecer depois que o efeito externo ocorreu. A retomada precisa de uma chave idempotente, uma reserva consumível ou uma consulta que reconcilie o resultado antes de tentar de novo. Um retry não pode transformar uma aprovação válida em duas cobranças, mensagens ou alterações.
Quais falhas devem entrar na regressão?
Transforme cada descoberta em um caso fixo, com entrada, estado inicial, decisão esperada, efeito proibido e evidência final. O teste de trajetória de um agente pode conferir a ordem de calls e intervenções. Este artigo acrescenta a condição de autorização e o estado que fica fora do agente.
Inclua cenários que mudam uma variável por vez:
- a tool correta não está no catálogo;
- o agente pede aprovação para leitura, embora a política permita a ação;
- a rejeição volta ao modelo e ele tenta um caminho alternativo;
- o aprovador não tem autoridade para aquele alvo;
- os argumentos mudam enquanto a pendência está aberta;
- a política é atualizada antes da retomada;
- o primeiro envio retorna timeout depois de alcançar o serviço;
- a mesma aprovação é consumida por dois workers.
Para separar camadas, use validação de tool calls em TypeScript para formato, identidade e argumentos. Use o teste de aprovação para decisão e consumo. Use um teste de integração para o adapter e o serviço externo. Misturar tudo em um único teste lento dificulta descobrir qual fronteira quebrou.
Checklist antes de liberar o agente
- A pendência é criada antes de qualquer efeito mutável?
- O teste confere a decisão e o estado externo separadamente?
- A rejeição, o timeout e o erro de retomada deixam zero efeitos?
- A aprovação está ligada ao payload, ao alvo e à versão da política?
- Uma alteração depois do clique exige nova decisão?
- O estado sobrevive ao reinício do worker?
- Dois workers podem consumir a mesma pendência?
- O teste executa um adapter falso antes de usar uma sandbox real?
- A suíte prova um caminho permitido, e não apenas recusas?
- O limite do teste está escrito para que ninguém o interprete como certificação de segurança?
O resultado que você quer não é "o agente mostrou uma tela". É uma trilha curta que liga proposta, decisão, execução e estado final. Quando o teste falhar, a equipe deve saber se a política decidiu errado, se o executor ignorou a decisão ou se o serviço externo produziu um resultado incerto.
O que este teste não prova?
Uma suíte de aprovação não prova que o modelo entende todos os pedidos, que a política cobre todos os recursos ou que uma integração externa sempre responde de forma correta. Ela prova apenas os casos e as autoridades descritos nas fixtures.
Também não substitui autenticação, autorização no serviço final, isolamento de credenciais, logs, recuperação e revisão operacional. Se o agente consegue alcançar o endpoint por outro caminho, o teste do botão não protege esse caminho. A aprovação deve ser uma barreira do runtime, não uma promessa no prompt.
Perguntas rápidas
Devo testar o modelo real?
Para política, estado pendente, rejeição e executor, comece com respostas controladas. O modelo real é útil para testar seleção e variação de comportamento, mas não deve decidir se a própria suíte passou. Mantenha a expectativa do efeito em código determinístico.
Uma aprovação sempre precisa bloquear a tool?
Não. A regra pode permitir uma leitura ou uma ação reversível sem intervenção. O teste precisa provar a classificação escolhida: chamadas aprovadas seguem, chamadas pendentes esperam e chamadas rejeitadas não alcançam o efeito.
O que devo guardar no relatório?
Guarde a identidade, a versão da política, a chamada proposta, a decisão, o payload executado e o estado antes e depois. Não guarde segredos só para facilitar a depuração. Um identificador sintético costuma ser suficiente para ligar as evidências.
Como este artigo foi produzido
Samuel Fajreldines é o autor responsável. A pesquisa comparou a documentação atual do OpenAI Agents SDK para human-in-the-loop e testes determinísticos com o método de testes de políticas da WorkOS. Discussões públicas recentes foram usadas apenas para linguagem e falhas recorrentes. A fixture de aprovação foi executada localmente com um contador de efeitos em memória. Ela não chamou um modelo, uma conta real ou um serviço externo.
Usei o RemoteCode como ferramenta do autor para manter contexto entre sessões. Ele apoiou a organização do trabalho, mas não executou a fixture nem provou a segurança do fluxo.