Um agente não deve ser retomado simplesmente carregando a conversa e pedindo ao modelo para continuar. A conversa registra o que foi dito. Ela não prova se uma tool terminou, se o sistema externo aplicou o efeito ou se a resposta se perdeu depois da aplicação.
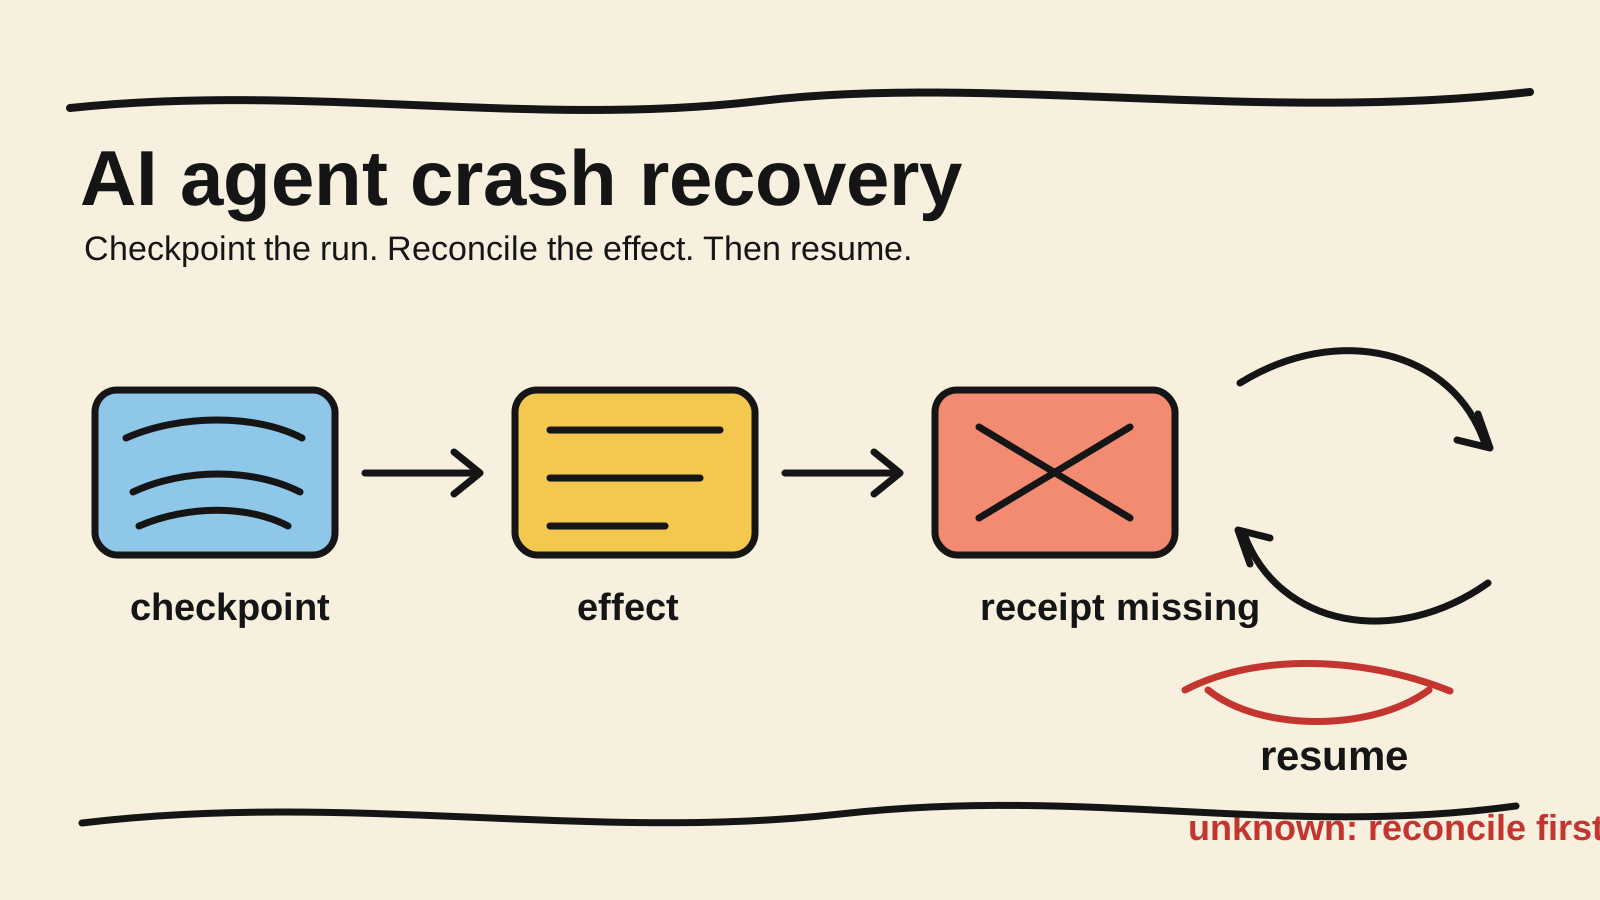
Depois de um crash, carregue o último checkpoint confirmado, recupere a intenção e o resultado de cada etapa, e trate a primeira operação sem recibo como uma decisão de recuperação. Se o provedor aceita uma chave de idempotência, consulte ou repita usando a mesma chave. Se não há como descobrir o que aconteceu, marque o resultado como desconhecido e pare antes de produzir outra alteração.
Este artigo é um spoke de execução durável para agentes de IA. O owner explica quando uma fila, um checkpoint ou um workflow faz sentido. Aqui, o foco é a falha entre o efeito externo e o registro local, com uma fixture Node.js que você pode interromper e reiniciar.
Resposta curta
- Grave a decisão do modelo antes de executar as tools.
- Grave o resultado de cada tool antes de iniciar a próxima etapa.
- Gere uma chave estável por efeito e use a mesma chave em uma repetição.
- Depois de um crash, consulte o sistema externo antes de decidir se a operação deve ser repetida.
- Se o resultado continuar desconhecido e a repetição puder causar dano, pause a execução para reconciliação humana ou operacional.
Por que o histórico da conversa não recupera a execução?
Imagine que o agente recebeu uma solicitação, pediu create_ticket e o processo morreu logo depois de o sistema de tickets aceitar a operação. O histórico pode conter a chamada da tool, mas não contém necessariamente o ID do ticket nem uma confirmação que sobreviva ao processo.
Se o worker reiniciado envia a conversa inteira ao modelo, ele pode escolher outra ação. Mesmo que escolha a mesma tool, uma nova requisição pode criar um segundo ticket. O problema não é apenas perder contexto. É confundir uma intenção registrada com um efeito confirmado.
O guia da AWS sobre execução durável para agentes descreve o mecanismo como step, checkpoint e replay: o resultado de cada etapa fica fora do processo e a recuperação continua a partir dos registros. A documentação de tarefas dos Cloudflare Agents acrescenta um limite importante: uma etapa interrompida pode ser executada novamente, então o efeito externo precisa aceitar uma chave estável ou uma leitura de progresso durável.
Isso também explica por que um trace não é um recibo. Um trace ajuda a investigar o caminho. O recibo, o ID retornado pelo provedor ou uma consulta no sistema que sofreu a mudança ajudam a decidir o que pode acontecer depois.
Qual estado deve sobreviver ao processo?
O registro de recuperação não precisa guardar toda a conversa no mesmo documento. Ele precisa guardar o suficiente para o runtime decidir a próxima etapa sem depender da memória do worker:
| Registro | Para que serve |
|---|---|
runId e versão do fluxo |
Reencontra a execução e evita continuar com uma definição incompatível |
| turno e chamadas do modelo | Reproduz a intenção já escolhida sem pedir ao modelo para escolher de novo |
| ID da chamada e argumentos | Identifica a operação lógica que pode ser repetida |
| chave de idempotência | Liga tentativas da mesma operação no sistema externo |
| resultado ou recibo | Permite pular uma etapa que já terminou |
status unknown |
Impede que uma falha de comunicação seja tratada como ausência de efeito |
| lease ou fencing token | Evita dois workers avançarem a mesma execução ao mesmo tempo |
O registro deve ser escrito em um armazenamento que sobreviva à morte do processo. Um arquivo atômico serve para uma fixture local. Em produção, use um banco, um volume durável ou o armazenamento do seu motor de workflows, com controle de concorrência e política de retenção.
O Microsoft Agent Framework documenta checkpoints como snapshots que incluem estado dos executors, mensagens pendentes, requisições e respostas. A mesma página exige que o workflow reconstruído preserve a topologia e as identidades dos executors. A ideia vale fora desse framework: o checkpoint precisa ser compatível com o código que vai interpretá-lo depois do deploy.
O que fazer em cada janela de crash?
O ponto da falha muda a recuperação. Não use um único retry para todas as situações.
| Ponto da falha | O que você sabe | Próxima ação |
|---|---|---|
| Antes de enviar a tool | O efeito não foi solicitado | Envie usando a chave da operação persistida |
| Depois de enviar, sem resposta | O efeito pode ter acontecido | Consulte por chave ou pelo estado do destino |
| Depois do efeito, antes do checkpoint | O efeito existe, mas o registro local não sabe | Consulte ou repita com a mesma chave; nunca gere uma chave nova |
| Depois de salvar o recibo | O efeito e a etapa estão confirmados | Reutilize o resultado e avance |
| Sem consulta confiável e com risco de duplicação | O estado permanece ambíguo | Marque unknown, pause e peça reconciliação |
Um retry é uma nova tentativa de uma operação. Retomada é a continuação de uma execução a partir do último estado confirmado. Um retry pode fazer parte da retomada, mas só depois que o runtime classifica o efeito.
Como implementar um journal mínimo em Node.js?
O exemplo abaixo usa dois arquivos para tornar as fronteiras visíveis. agent-run.json é o journal do runtime. effects.json representa o armazenamento do provedor externo, que reconhece a mesma chave de operação. O modelo foi substituído por um plano fixo para que o teste não dependa de rede, tokens ou uma decisão não determinística.
Salve o conteúdo como agent-recovery.mjs:
import { existsSync, readFileSync, renameSync, writeFileSync } from "node:fs";

const RUN_FILE = "agent-run.json";
const EFFECTS_FILE = "effects.json";
const runId = "ticket-77";

const plan = [
  [{ id: "c1", tool: "create_ticket", args: { title: "Login falha" } }],
  [{ id: "c2", tool: "send_email", args: { to: "dana@example.com" } }],
  [],
];

function load(file, fallback) {
  return existsSync(file) ? JSON.parse(readFileSync(file, "utf8")) : fallback;
}

function saveAtomically(file, value) {
  const temporary = `${file}.tmp`;
  writeFileSync(temporary, JSON.stringify(value, null, 2));
  renameSync(temporary, file);
}

function model(turns) {
  return plan[turns] ?? [];
}

function providerLookup(key) {
  const effects = load(EFFECTS_FILE, {});
  return effects[key] ?? null;
}

function providerExecute(tool, args, key) {
  const effects = load(EFFECTS_FILE, {});
  if (effects[key]) return effects[key];

  const result = {
    providerId: `${tool}-1`,
    tool,
    args,
    confirmedAt: "fixture",
  };

  // Um provedor real deve persistir essa chave junto com o efeito.
  effects[key] = result;
  saveAtomically(EFFECTS_FILE, effects);
  return result;
}

async function run() {
  const state = load(RUN_FILE, { runId, turns: [] });

  for (let turnIndex = 0; ; turnIndex += 1) {
    if (!state.turns[turnIndex]) {
      state.turns[turnIndex] = {
        calls: model(turnIndex),
        results: {},
      };
      // A decisão do modelo fica registrada antes de qualquer efeito.
      saveAtomically(RUN_FILE, state);
    }

    const turn = state.turns[turnIndex];
    for (const call of turn.calls) {
      if (turn.results[call.id]) {
        console.log(`skip ${call.tool}: resultado já salvo`);
        continue;
      }

      const key = `${runId}:${turnIndex}:${call.id}`;
      const known = providerLookup(key);
      const result = known ?? providerExecute(call.tool, call.args, key);

      if (process.env.CRASH_AFTER_EFFECT === "1" && !known) {
        console.log(`crash depois do efeito: ${call.tool}`);
        process.kill(process.pid, "SIGKILL");
      }

      turn.results[call.id] = result;
      saveAtomically(RUN_FILE, state);
      console.log(`${call.tool}: ${known ? "recibo consultado" : "efeito aplicado"}`);
    }

    if (turn.calls.length === 0) {
      console.log("execução concluída");
      return;
    }
  }
}

run().catch((error) => {
  console.error(error);
  process.exitCode = 1;
});
Há duas propriedades importantes no exemplo. Primeiro, a saída do modelo é salva antes da primeira tool. O restart não chama o modelo para descobrir novamente qual era o plano. Segundo, providerLookup consulta o sistema externo antes de providerExecute. Quando o processo morre depois de providerExecute e antes de salvar agent-run.json, a próxima execução encontra o recibo em effects.json e grava esse resultado no journal sem criar um segundo efeito.
O arquivo effects.json é uma simulação. Ele representa uma garantia que o seu provedor precisa oferecer, como idempotência por chave, consulta de status ou uma tabela de operações. Um arquivo local controlado pelo mesmo processo não prova a atomicidade de um sistema distribuído.
Como provocar o crash e verificar a retomada?
Execute o primeiro processo com a falha injetada:
rm -f agent-run.json effects.json
CRASH_AFTER_EFFECT=1 node agent-recovery.mjs || true
A primeira execução grava o efeito do ticket e termina antes de gravar o recibo no journal. Agora reinicie o mesmo run:
node agent-recovery.mjs
node agent-recovery.mjs
Na segunda execução, create_ticket deve aparecer como recibo consultado, e send_email deve ser aplicado uma vez. Na terceira, as duas chamadas já têm resultados no journal. A saída final deve conter execução concluída, enquanto effects.json deve conter uma entrada para cada chave.
Esse teste prova três decisões do harness: o plano não foi recalculado depois do crash, o efeito incerto foi reconciliado por uma chave estável e o resultado recuperado foi salvo antes de continuar. Ele não prova que um provedor real trata a chave de forma idempotente, que dois workers não podem executar juntos ou que uma transação externa é atômica.
Quando um lease e uma versão do fluxo são necessários?
O exemplo pressupõe um único processo por execução. Em produção, um deploy pode iniciar um worker novo enquanto o anterior ainda está preso em uma chamada de rede. Se os dois leem o mesmo checkpoint, a chave de idempotência reduz o risco, mas não substitui a exclusão do dono da execução.
Use um lease com expiração e um token de fencing quando mais de um worker puder disputar o mesmo run. O worker precisa renovar o lease, validar o token antes de avançar o checkpoint e perder a capacidade de gravar quando o lease expirar. A atualização também deve conferir a versão esperada do estado para rejeitar uma gravação atrasada.
Fixe a versão do fluxo por run. Uma execução iniciada com uma descrição de tool, formato de argumento ou regra de transição diferente pode não ser compatível com o journal antigo. O Microsoft Foundry mostra esse princípio em um agente resiliente: o servidor armazena a resposta, cria checkpoints por estágio e, depois do restart, ignora o estágio já checkpointado. A opção de resiliência precisa ser ativada explicitamente no exemplo da documentação.
Também separe o contexto do agente do estado operacional. Uso RemoteCode como ferramenta própria quando preciso manter continuidade entre sessões de Codex e Claude Code. Ela pode reduzir contexto repetido, mas não substitui o journal, o lease, a idempotência ou a consulta do efeito externo.
Quando parar em vez de repetir?
Pare quando você não consegue responder a uma destas perguntas:
- Qual operação lógica está sendo recuperada?
- O sistema externo oferece uma chave de idempotência ou uma consulta confiável?
- O efeito pode ser observado sem produzir outra alteração?
- O worker antigo perdeu o lease e não pode continuar gravando?
- A aprovação, o orçamento e a versão do fluxo ainda valem?
Se a resposta for não e a operação puder enviar uma mensagem, criar um registro, alterar uma permissão ou movimentar dinheiro, unknown é um estado melhor que failed. failed sugere que nada aconteceu. unknown mantém a obrigação de reconciliar antes de tentar.
Essa regra complementa como verificar se uma tool call teve efeito antes de repetir. O artigo anterior trata da consulta de uma chamada. Aqui, a consulta faz parte do protocolo completo de restart, que começa no checkpoint e termina com o resultado recuperado ou uma pausa explícita. Para uma tarefa que depende de um broker e de redelivery, veja também como testar um worker sem duplicar efeitos.
Um workflow como Temporal, Step Functions, LangGraph ou um runtime semelhante pode assumir parte do journal e do replay. Isso reduz código de infraestrutura, mas não torna uma API externa exatamente uma vez. Verifique as semânticas de retry, o armazenamento, o comportamento da etapa interrompida e a forma de passar uma chave ao provedor antes de confiar no nome do produto.
Como este artigo foi produzido
Samuel Fajreldines é o autor responsável por este texto. A pesquisa combinou documentação atual da AWS, Microsoft e Cloudflare, inspeção dos resultados de busca, leitura de discussões públicas recentes e comparação com o cluster de execução durável existente. A fixture foi executada localmente com Node.js e usa apenas arquivos temporários e um provedor falso. Nenhum pagamento, email, ticket real ou API externa foi acionado.
Usei assistência de IA para descobrir fontes, comparar páginas, organizar um primeiro rascunho, criar a ilustração SVG e revisar a consistência entre os idiomas. A assistência não executou um agente real, não mediu um sistema de produção e não substitui a verificação das garantias do provedor que você usa.
Fontes consultadas
- AWS, "From Agent Loop to Durable Execution: An Architecture Guide for Production Agents", consultado em 5 de novembro de 2026.
- Microsoft Learn, "Deploy a crash-resilient long-running agent", atualizado em 14 de outubro de 2026 e consultado em 5 de novembro de 2026.
- Microsoft Learn, "Microsoft Agent Framework Workflows: Checkpoints", consultado em 5 de novembro de 2026.
- Cloudflare Agents, "Tasks", consultado em 5 de novembro de 2026.