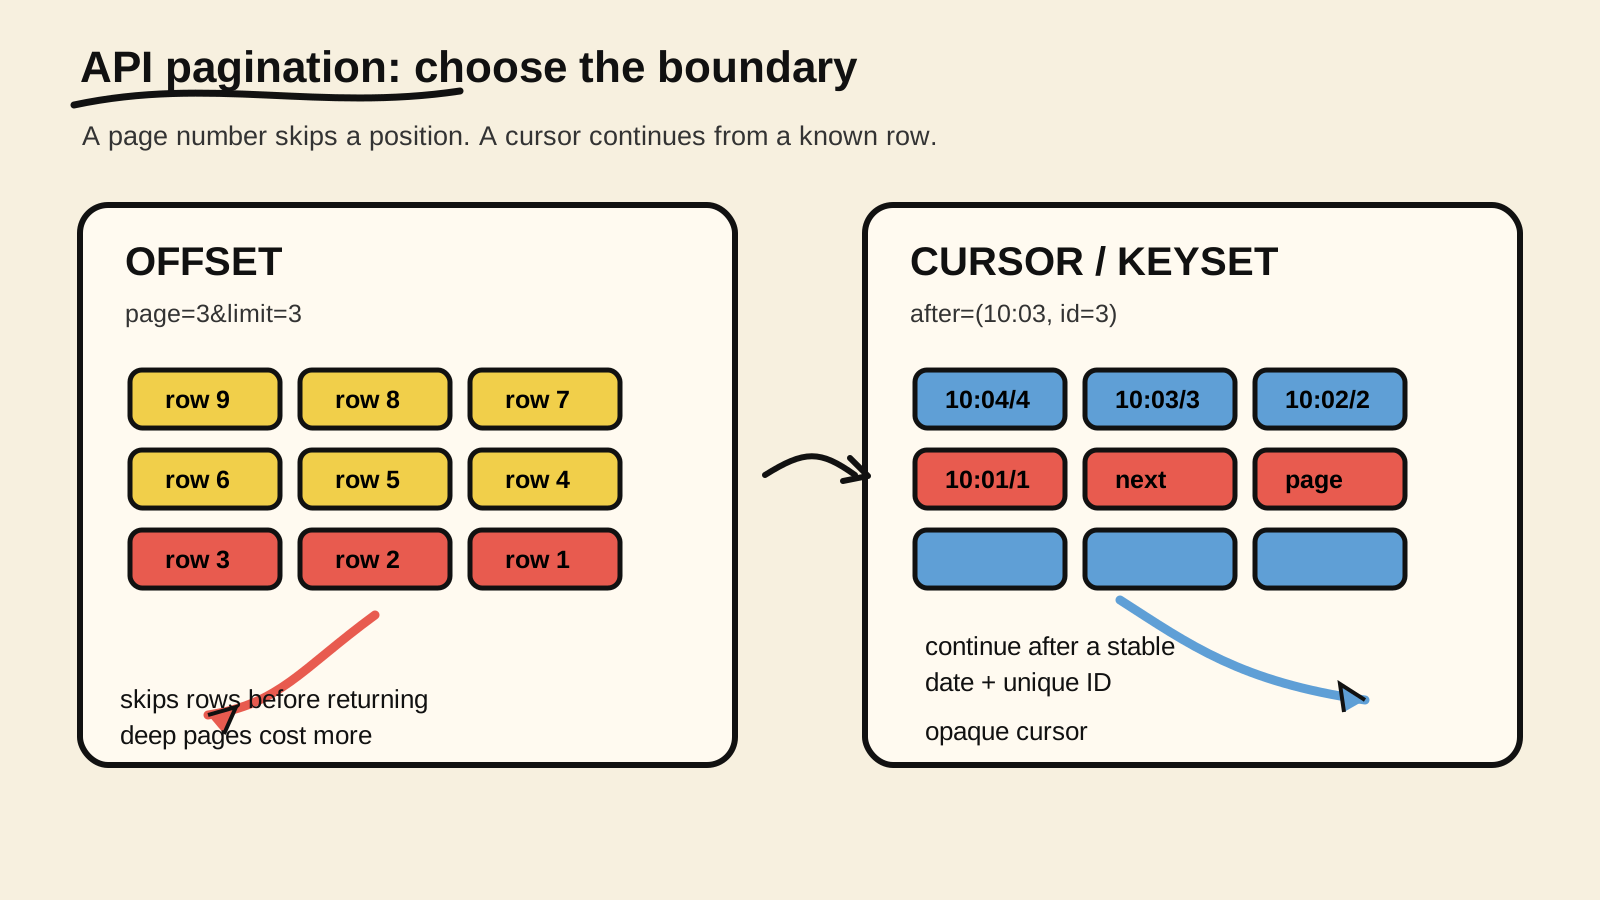
A escolha entre OFFSET e cursor depende de como o cliente percorre a lista. Se ele precisa abrir a página 37, o offset é simples e direto. Se ele vai buscar a próxima parte de um feed, exportar registros ou sincronizar uma tabela que continua mudando, um cursor baseado na ordenação costuma proteger melhor a continuidade.
Não existe uma opção universalmente melhor. OFFSET expressa uma posição numérica. Cursor, também chamado de keyset ou seek pagination, expressa a posição relativa à última linha recebida. A decisão fica segura quando a API mantém a mesma ordenação, usa uma chave de desempate única e trata o cursor como um contrato opaco.
Esta página organiza a subárea de paginação estável em APIs. O guia de uma API GraphQL escalável com Node.js menciona paginação por cursor como uma escolha de desempenho, mas não cobre o contrato entre endpoint, banco e cliente. Aqui, a pergunta é mais estreita: qual modelo escolher e como evitar que uma lista mutável repita ou pule registros?
Resposta curta
- Use
OFFSETpara listas pequenas ou estáveis e interfaces que precisam saltar para uma página específica.- Use cursor para feeds, exportações, sincronizações e listas que mudam durante a leitura.
- Ordene por uma chave única, como
(created_at, id), e não apenas por uma data que pode empatar.- Gere cursores opacos no servidor e vincule-os ao filtro, à ordenação e à versão do contrato.
- Verifique a paginação com inserções e exclusões entre requisições; uma página curta não prova que chegou ao fim.
A diferença prática entre offset e cursor
Na paginação por offset, o cliente pede algo como page=3&limit=20, e o servidor transforma isso em OFFSET 40 LIMIT 20. O banco precisa considerar as primeiras 40 linhas para devolver as próximas 20. A documentação do PostgreSQL explica que as linhas ignoradas pelo OFFSET ainda precisam ser calculadas e que um offset grande pode ficar ineficiente (PostgreSQL, "LIMIT and OFFSET").
Na paginação por cursor, o cliente envia a posição que recebeu da página anterior:
GET /posts?limit=20&after=eyJ2IjoxLCJjcmVhdGVkQXQiOiIyMDI2LTExLTA3VDEwOjAwOjAwWiIsImlkIjo0MjF9O servidor traduz esse cursor para uma condição na ordenação. Em uma lista decrescente por data e ID, a consulta pode ser:
CREATE INDEX posts_feed_order_idx
  ON posts (created_at DESC, id DESC);

SELECT id, title, created_at
FROM posts
WHERE (created_at, id) < ($1::timestamptz, $2::bigint)
ORDER BY created_at DESC, id DESC
LIMIT $3;
O operador < não é uma regra universal. Ele corresponde a esta ordenação descendente. Se a consulta for ascendente, a condição e o índice precisam acompanhar a direção. O ponto é substituir "pule N linhas" por "continue depois desta posição ordenada".
Quando o offset é a escolha certa?
Offset continua sendo uma boa escolha quando o caso de uso pede acesso aleatório e a coleção não é grande ou não muda com frequência. Uma tabela administrativa que permite ir diretamente para a página 10 pode preferir page e limit porque o cliente entende o número da página e o total pode ser útil na interface.
Use offset quando estas propriedades forem verdadeiras:
| Sinal do produto | Por que offset pode caber |
|---|---|
| A pessoa precisa saltar para uma página específica | A posição numérica é parte da navegação |
| A lista é pequena ou é um relatório fechado | O custo de pular linhas é limitado |
| O resultado é estável durante a leitura | A mudança entre páginas não desloca a janela |
O endpoint já tem clientes que dependem de page |
A compatibilidade pode valer mais que a migração imediata |
Mesmo nesse cenário, defina ORDER BY com uma ordenação única. O PostgreSQL alerta que LIMIT sem uma ordem previsível pode produzir subconjuntos inconsistentes, porque SQL não promete uma ordem implícita. O offset não cria uma ordem; ele apenas pula uma parte do resultado ordenado.
Quando o cursor é melhor?
Cursor é a opção mais forte quando o cliente percorre a lista para frente ou para trás e não precisa de acesso aleatório por número de página. O Microsoft Learn descreve keyset pagination como a alternativa que usa os valores da última linha em uma cláusula WHERE. A mesma documentação aponta duas limitações importantes: keyset não resolve saltos arbitrários e precisa de uma ordenação totalmente única.
Os casos típicos são feeds, históricos de eventos, exportações, sincronizações incrementais e workers que retomam uma leitura. Neles, a pergunta não é "qual é a página 37?". É "qual registro vem depois do último que confirmei?". Se a tabela recebe uma inserção enquanto o cliente trabalha, o cursor continua comparando com a posição recebida, enquanto um offset pode deslocar a janela.
O cursor também é útil quando a API quer mudar a implementação do banco sem expor detalhes ao cliente. O guia de paginação do GraphQL recomenda cursores opacos e observa que o cursor pode esconder se a implementação usa um ID, um offset ou outra representação. A opacidade não resolve a consistência sozinha, mas impede que o cliente dependa do formato interno.
A ordenação precisa ser única
O erro mais comum em uma implementação de cursor é ordenar apenas por created_at. Dois registros podem ter o mesmo timestamp. Se o cursor guarda só esse valor, a consulta seguinte não consegue separar com precisão o registro já visto do registro que ainda deve aparecer.
Use uma chave composta que termine em um campo único:
SELECT id, created_at, title
FROM posts
WHERE (created_at, id) < ($1::timestamptz, $2::bigint)
ORDER BY created_at DESC, id DESC
LIMIT 20;
O par (created_at, id) define uma ordem total para o conjunto. A documentação de paginação do EF Core usa a mesma ideia ao combinar data e ID, e o perfil de cursor do JSON:API exige que o servidor acrescente restrições de ordenação até produzir uma ordem única (JSON:API, "Cursor Pagination").
O índice deve acompanhar a consulta. Sem ele, trocar offset por uma cláusula WHERE mais complexa pode apenas mover o custo para outro lugar. Confirme com EXPLAIN (ANALYZE, BUFFERS) no banco e com o volume que o endpoint realmente recebe. Este artigo não traz benchmark de um banco específico.
O cursor é um contrato da API, não um ID exposto
Um cursor pode conter a versão do contrato, os valores da ordenação e uma impressão dos filtros usados na primeira requisição:
type PostCursor = {
  v: 1;
  sort: "created_at_desc_id_desc";
  createdAt: string;
  id: number;
  filterHash: string;
};

export function encodeCursor(cursor: PostCursor): string {
  return Buffer.from(JSON.stringify(cursor)).toString("base64url");
}

export function decodeCursor(value: string): PostCursor {
  let parsed: unknown;

  try {
    parsed = JSON.parse(Buffer.from(value, "base64url").toString("utf8"));
  } catch {
    throw new Error("cursor inválido");
  }

  if (
    !parsed ||
    typeof parsed !== "object" ||
    (parsed as Record<string, unknown>).v !== 1 ||
    (parsed as Record<string, unknown>).sort !== "created_at_desc_id_desc" ||
    typeof (parsed as Record<string, unknown>).createdAt !== "string" ||
    !Number.isSafeInteger((parsed as Record<string, unknown>).id) ||
    typeof (parsed as Record<string, unknown>).filterHash !== "string"
  ) {
    throw new Error("cursor incompatível");
  }

  return parsed as PostCursor;
}
O exemplo é ilustrativo e ainda precisa de validação de data, tamanho máximo, assinatura ou outra proteção adequada ao risco do endpoint. Não aceite o id do cursor como autorização. Ele é apenas uma posição; a consulta ainda precisa aplicar tenant, permissões e filtros atuais.
O hash dos filtros evita que um cliente use o cursor de status=published em uma requisição para status=draft. Outra opção é rejeitar filtros incompatíveis explicitamente. Quando a ordenação muda, incremente a versão do cursor em vez de tentar interpretar silenciosamente o formato antigo.
Verifique a janela entre duas páginas
Uma implementação não está validada porque duas requisições consecutivas retornaram os itens esperados. Insira e remova registros entre as requisições e confira se a caminhada mantém a propriedade que o produto precisa: sem duplicata, sem salto ou apenas sem repetir efeitos em um exportador.
Esta fixture em JavaScript executa a parte essencial da regra sem depender de um banco. Ela usa a mesma ordenação (createdAt, id) do SQL:
import test from "node:test";
import assert from "node:assert/strict";

function compareDesc(a, b) {
  return b.createdAt.localeCompare(a.createdAt) || b.id - a.id;
}

function pageAfter(rows, cursor, limit) {
  const ordered = [...rows].sort(compareDesc);
  const start = cursor
    ? ordered.findIndex(
        (row) =>
          row.createdAt === cursor.createdAt && row.id === cursor.id,
      ) + 1
    : 0;
  const items = ordered.slice(start, start + limit);
  const last = items.at(-1);

  return {
    items,
    nextCursor: last
      ? { createdAt: last.createdAt, id: last.id }
      : null,
  };
}

test("does not repeat a row when a newer row arrives", () => {
  const rows = [
    { id: 4, createdAt: "2026-11-07T10:04:00.000Z" },
    { id: 3, createdAt: "2026-11-07T10:03:00.000Z" },
    { id: 2, createdAt: "2026-11-07T10:02:00.000Z" },
    { id: 1, createdAt: "2026-11-07T10:01:00.000Z" },
  ];

  const first = pageAfter(rows, null, 2);
  const second = pageAfter(
    [...rows, { id: 5, createdAt: "2026-11-07T10:05:00.000Z" }],
    first.nextCursor,
    2,
  );

  assert.deepEqual(first.items.map((row) => row.id), [4, 3]);
  assert.deepEqual(second.items.map((row) => row.id), [2, 1]);
});
Salve o bloco como pagination.test.mjs e rode node --test pagination.test.mjs. O teste demonstra a propriedade da ordenação em memória, não a execução do PostgreSQL, a concorrência entre transações ou a garantia de um provedor de API. Para uma prova de integração, rode a mesma matriz contra o banco e o endpoint reais.
Falhas que aparecem depois do primeiro deploy
Alguns problemas escapam de uma demo feliz:
- Timestamp sem desempate: duas linhas com a mesma precisão visível podem cair antes ou depois do cursor de forma ambígua. Guarde uma chave única adicional e preserve a mesma precisão no cursor.
- Filtro ou ordenação alterados: um cursor só é válido para a consulta que o produziu. Rejeite incompatibilidade em vez de devolver uma página aparentemente correta.
- Cursor criado pelo cliente: base64 não é assinatura. Se o cursor carrega tenant, filtro ou permissão, valide integridade e reavalie autorização no servidor.
- Fim inferido por página curta: filtros, limites do provedor e leituras concorrentes podem devolver menos itens sem indicar que a lista acabou. Prefira
hasMoreounextCursor: nulldefinido pelo servidor. - Total contado em toda resposta:
COUNT(*)pode custar mais que a leitura da página. Só o inclua quando a interface realmente precisa dele. - Exclusão entre páginas: um cursor deve continuar representando uma posição mesmo que a linha que o originou tenha sido apagada. Não dependa de buscar a linha do cursor antes de continuar.
Se o produto exige uma fotografia consistente de uma coleção, cursor normal não basta. Você precisará de uma estratégia de snapshot, uma janela por versão ou um mecanismo de exportação próprio. O perfil de cursor do JSON:API admite que o servidor codifique uma identidade de sessão quando a lista não puder mudar entre requisições, mas isso traz retenção e custo operacional próprios.
Checklist para escolher
Antes de publicar o endpoint, responda:
- O cliente precisa saltar para uma página arbitrária ou apenas avançar e voltar?
- A coleção muda enquanto o cliente lê?
- A ordenação termina em uma chave única e indexada?
- O cursor preserva versão, filtro e direção sem expor detalhes que o cliente possa editar?
- A resposta informa de forma confiável se há outra página?
- A fixture força inserção, exclusão, empate de timestamp, cursor inválido e filtro alterado?
Se as respostas apontarem para navegação sequencial em uma lista mutável, comece com cursor/keyset. Se o requisito principal for acesso aleatório em uma lista pequena e estável, offset pode ser a interface mais simples. Em ambos os casos, a ordenação única e os testes de mudança entre páginas são mais importantes que o nome do parâmetro.
Este texto é uma síntese técnica com exemplos locais, não um benchmark. O código JavaScript foi executado com node --test; o SQL precisa ser conferido contra a versão do banco, o plano de índices e a política de consistência do seu serviço. Para uma prova complementar de dados que chegam em ordem diferente, veja os testes de consistência eventual sem sleep fixo. Para uma API que precisa retomar uma exportação depois de uma falha, a execução durável com filas e checkpoints ajuda a separar posição confirmada de trabalho ainda pendente.
Fontes consultadas
- PostgreSQL, "LIMIT and OFFSET", consultado em 2026-11-07.
- Microsoft Learn, "Pagination", consultado em 2026-11-07.
- GraphQL, "Pagination", consultado em 2026-11-07.
- JSON:API, "Cursor Pagination Profile", consultado em 2026-11-07.
- Zendesk Developer Docs, "Comparing cursor pagination and offset pagination", consultado em 2026-11-07.