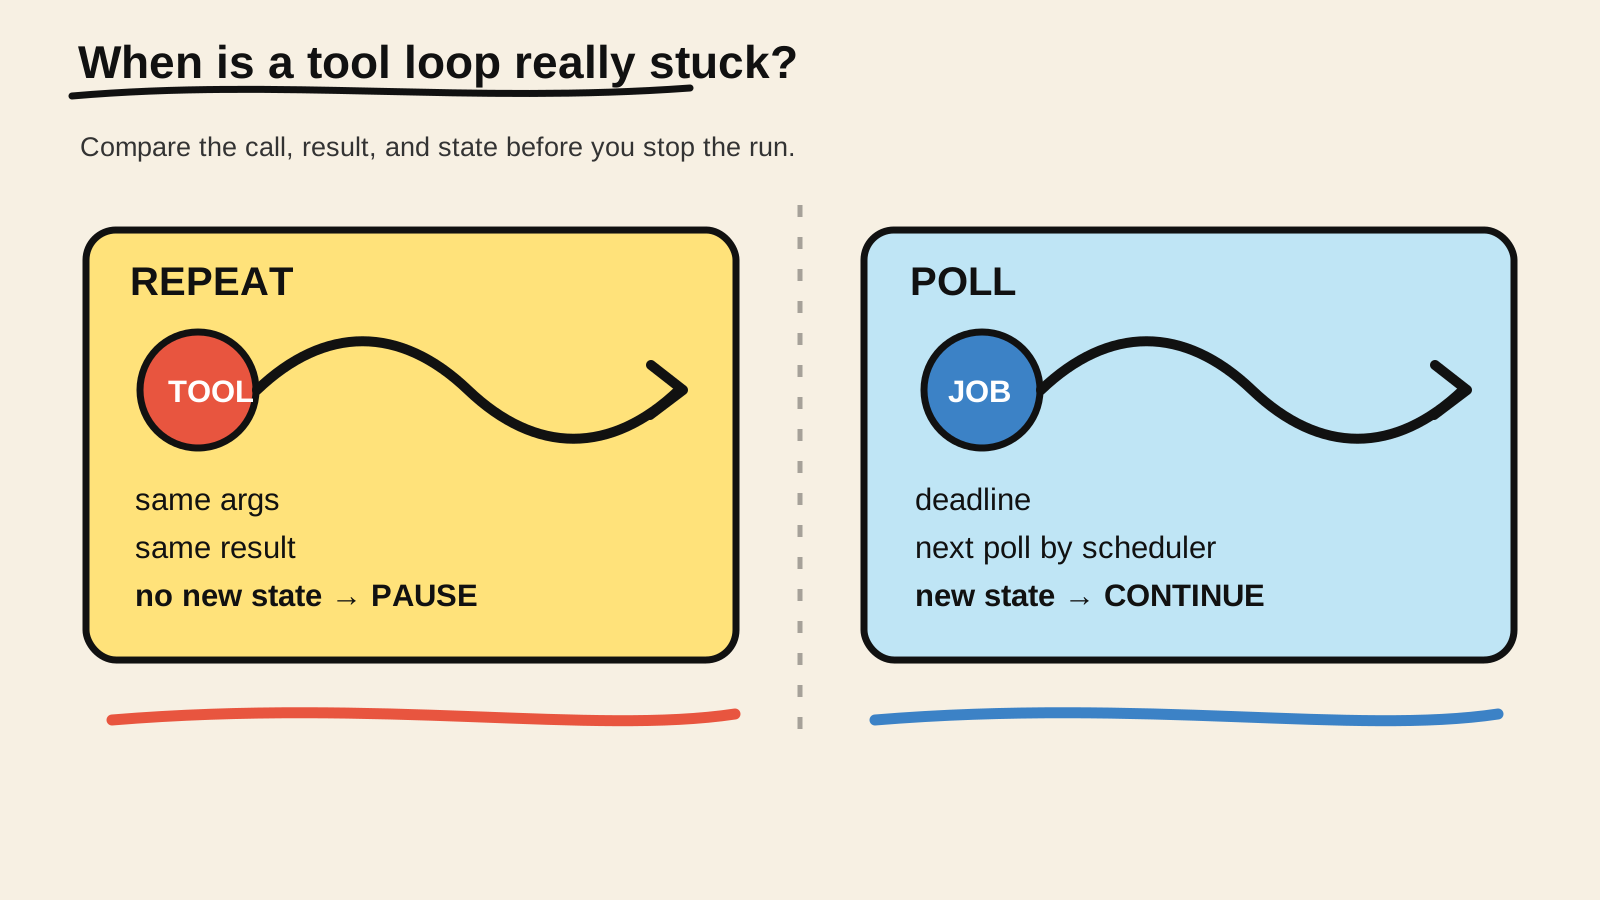
Uma tool repetida não é automaticamente um loop. Um agente pode chamar get_job_status várias vezes porque o job ainda está executando. O sinal de problema aparece quando a chamada, o resultado relevante e o estado da tarefa continuam iguais, sem um prazo ou uma mudança esperada que justifique a próxima consulta.
A regra prática é colocar um detector no runtime, antes de executar a próxima tool. Normalize o nome e os argumentos, compare o resultado que importa e registre alguma evidência de progresso. Quando a mesma combinação volta sem progresso, pause a execução com um motivo explícito. Quando for polling, o scheduler precisa controlar o intervalo, o prazo e o estado terminal, em vez de deixar o modelo decidir sozinho.
Este é um spoke de como evitar loop infinito em um agente de IA. O artigo anterior trata das barreiras gerais de parada. Aqui, a pergunta é mais estreita: como reconhecer uma repetição antes de gastar todo o limite e como não bloquear um job que ainda pode avançar.

Resposta curta
- Conte o nome da tool e os argumentos normalizados, não apenas o nome da ferramenta.
- Compare o resultado ou a versão de estado que pode mudar a próxima decisão.
- Pause quando a mesma chamada devolve a mesma evidência sem progresso observável.
- Trate polling como um contrato separado, com deadline, próximo horário e estado terminal controlados pelo runtime.
- Retorne
no_progressoupoll_deadline_exceededao chamador. Não esconda a parada em um prompt.
Por que contar chamadas não basta?
Um contador simples acusa quase todo agente que trabalha de verdade. Buscar três documentos, ler dois arquivos ou consultar cinco pedidos pode repetir a mesma tool com argumentos diferentes. O nome search aparece várias vezes, mas a tarefa avançou.
O Agents SDK para JavaScript documenta o loop do runner: o runtime chama o modelo, executa as tools quando elas aparecem e volta ao modelo até obter uma saída final ou atingir maxTurns. A documentação também diz que o limite padrão é 10 turnos e que o SDK lança MaxTurnsExceededError quando o teto é atingido, salvo configuração diferente. Esse limite é uma barreira de segurança, não um detector de progresso.
O Microsoft Agent Framework recomenda limitar loops autônomos porque uma condição de conclusão pode falhar, o modelo pode travar e um avaliador pode ser probabilístico. A recomendação sustenta o limite duro. Ela não diz qual repetição é inútil para o seu domínio. Essa parte precisa de evidência da execução.
Um detector local deve responder a três perguntas:
- A chamada é estruturalmente a mesma?
- O resultado relevante é o mesmo?
- Alguma parte do estado da tarefa mudou desde a última tentativa?
Se a resposta for "sim, sim e não" várias vezes seguidas, você tem um sinal melhor do que um contador global. Ainda não tem uma prova universal. Uma leitura repetida pode ser uma verificação deliberada, e uma API pode produzir o mesmo resultado antes de mudar depois. Por isso, o detector deve pausar ou pedir decisão, não fingir que conhece a intenção do modelo.
Como criar uma impressão digital estável da tool?
Compare a estrutura da chamada, não a representação textual que apareceu no transcript. A ordem das chaves de um objeto JSON não deveria fazer duas chamadas iguais parecerem diferentes. Campos voláteis, como requestId e timestamp, também não representam uma mudança de intenção.
Uma impressão digital mínima contém o nome da tool e os argumentos normalizados. Para elevar a confiança, guarde também uma impressão do resultado que realmente afeta o próximo passo. Não coloque o prompt inteiro nessa chave. Além de ser desnecessário, isso pode levar dados sensíveis para logs ou métricas.
O exemplo a seguir é uma fixture offline. Ele não chama um LLM nem executa uma tool real. O progressKey precisa vir do domínio: uma versão do job, uma contagem de itens processados, um hash do diff ou outro fato que a aplicação consiga observar.
import assert from "node:assert/strict";

function stableJson(value) {
  if (Array.isArray(value)) {
    return `[${value.map(stableJson).join(",")}]`;
  }
  if (value && typeof value === "object") {
    return `{${Object.keys(value).sort().map((key) =>
      `${JSON.stringify(key)}:${stableJson(value[key])}`,
    ).join(",")}}`;
  }
  return JSON.stringify(value);
}

function fingerprint(step) {
  return stableJson({ tool: step.tool, args: step.args });
}

function resultFingerprint(step) {
  return stableJson({ tool: step.tool, result: step.result });
}

function inspectStep(step, previous, options = { repeatLimit: 3 }) {
  const call = fingerprint(step);
  const result = resultFingerprint(step);
  const sameObservation = call === previous.call && result === previous.result;
  const stateChanged = step.progressKey !== undefined
    && step.progressKey !== previous.progressKey;
  const repeats = sameObservation && !stateChanged
    ? previous.repeats + 1
    : 0;

  if (stateChanged) {
    return { action: "continue", reason: "progress", call, result, repeats: 0 };
  }
  if (repeats >= options.repeatLimit) {
    return { action: "pause", reason: "no_progress", call, result, repeats };
  }
  return { action: "continue", reason: "observe", call, result, repeats };
}

const first = {
  tool: "read_status",
  args: { jobId: "job-7", verbose: false },
  result: { status: "running" },
  progressKey: "version-4",
};

let state = {
  call: fingerprint(first),
  result: resultFingerprint(first),
  progressKey: first.progressKey,
  repeats: 0,
};

for (let i = 0; i < 3; i += 1) {
  const decision = inspectStep(first, state);
  assert.equal(decision.action, i === 2 ? "pause" : "continue");
  state = { ...state, ...decision, progressKey: first.progressKey };
}

const changed = inspectStep({ ...first, progressKey: "version-5" }, state);
assert.deepEqual(changed, {
  action: "continue",
  reason: "progress",
  call: state.call,
  result: state.result,
  repeats: 0,
});

console.log("no-progress detector fixture passed");
Execute com Node.js:
node repeated-tool-guard.mjsNa fixture, repeatLimit: 3 é um parâmetro de teste. Não o trate como um valor recomendado para toda tool. Uma chamada de leitura pode ser barata e segura; uma escrita pode exigir pausa na primeira repetição. A política precisa conhecer o risco e o contrato da operação.
Quando uma repetição é polling legítimo?
Polling é uma forma esperada de repetir uma consulta quando um estado externo pode mudar com o tempo. O problema aparece quando o modelo controla a repetição sem um limite. A mesma resposta running pode ocupar muitos turnos, e o runtime pode não saber se o próximo pedido vai esperar, mudar o intervalo ou simplesmente chamar de novo.
Separe o polling do loop livre. A tool ou o runtime deve declarar algo parecido com:
| Campo | Responsabilidade |
|---|---|
jobId |
identifica o trabalho que está sendo consultado |
status |
distingue running, completed e failed |
nextPollAt |
diz quando a próxima consulta pode acontecer |
deadline |
encerra a espera compartilhada |
progressKey |
mostra se algo observável mudou |
Enquanto status for running, o scheduler pode agendar uma próxima consulta até deadline. O modelo não precisa emitir a mesma tool novamente a cada turno. Se a deadline chegar sem estado terminal, retorne poll_deadline_exceeded e deixe o chamador decidir se espera mais, reencaminha o job ou pede intervenção.
Não use o nome get_status como passe livre. Uma leitura pode ser legítima por alguns ciclos e depois virar desperdício. O limite deve ser por execução e por job, com um relógio compartilhado. Um retry criado dentro da tool não pode reiniciar o contador do run.
O código de detecção de loop do Gemini CLI é uma referência de implementação pública para uma distinção importante: comparar os argumentos da chamada e considerar equivalência semântica, em vez de comparar somente o nome da tool. A implementação de um produto pode ter regras diferentes. Use-a como fonte de inspeção de código, não como uma política universal.
O que fazer quando o detector dispara?
Não chame a mesma tool novamente antes de mudar a condição que causou a repetição. O runtime pode seguir três caminhos:
- Pausar: registre
no_progress, o fingerprint, a última evidência e a próxima decisão permitida. - Pedir uma mudança de estratégia: devolva ao agente uma mensagem curta com a chamada repetida e exija outra tool, outro argumento ou uma explicação de bloqueio. Isso é uma nova tentativa controlada, não uma permissão para repetir automaticamente.
- Escalar: se a tool produz efeito externo, se o estado é desconhecido ou se o detector não pode decidir com segurança, encaminhe a execução para uma pessoa ou uma fila de reconciliação.
O artigo sobre como rastrear tool calls com OpenTelemetry explica onde registrar run, tool, tentativa e resultado resumido. O trace ajuda a investigar o primeiro ponto de repetição. Ele não deve ser o único controle: a guarda precisa existir no dispatcher antes da próxima execução.
Também não transforme todo erro em no_progress. Um 401 pode exigir renovação de credencial, um 400 pode exigir correção de argumentos e um timeout depois de uma escrita pode exigir verificar se a tool call teve efeito antes de repetir. A razão de parada precisa dizer qual decisão está bloqueada.
Se a falha é apenas um timeout de teste, use um relógio injetável e uma fixture que separe espera de efeito, como no guia sobre testar timeout de tool sem esperar nem duplicar efeitos. Timeout, repetição sem progresso e efeito desconhecido são diagnósticos diferentes, mesmo quando aparecem na mesma execução.
Como testar sem depender do modelo?
Monte trajetórias pequenas e determinísticas. O teste não precisa provar que o modelo escolheria uma tool. Precisa provar que o runtime reconhece o padrão e não executa a chamada proibida.
| Cenário | Evidência | Decisão esperada |
|---|---|---|
| Mesmo nome, argumentos diferentes | a intenção mudou | continuar |
| Mesmo nome e argumentos, resultado diferente | há nova evidência | continuar e atualizar o estado |
| Mesmo nome, argumentos e resultado, estado igual | não há progresso observado | pausar após o limite |
get_status com running |
job ainda pode avançar | agendar pelo scheduler até a deadline |
get_status após a deadline |
espera não tem mais orçamento | retornar poll_deadline_exceeded |
| mesma escrita depois de timeout | efeito externo é ambíguo | verificar o efeito antes de repetir |
| ciclo A, B, A, B | o conjunto de chamadas oscila | pausar ou pedir intervenção |
Teste também a normalização. Duas cargas com chaves em ordem diferente devem gerar a mesma impressão digital. Um campo volátil deve ser removido antes da comparação se ele não representa mudança de intenção. Por outro lado, não remova o campo que identifica o recurso ou a versão que realmente pode mudar o resultado.
No caminho de produção, conte a tentativa quando o dispatcher admite a chamada, não depois que ela termina. Se o processo morrer, a contagem local pode desaparecer. Para uma execução durável, persista o estado da guarda junto do run, sem confundir esse registro com um recibo do sistema externo.
Método e limites
Consultei a documentação atual do OpenAI Agents SDK, a documentação do Microsoft Agent Framework e uma implementação pública de detecção de loops do Gemini CLI em 19/11/2026. Também comparei resultados públicos e discussões de praticantes, mas usei essas discussões apenas para linguagem e sintomas. Não executei o detector contra um provedor de modelo ou uma tool de produção; a fixture é local e determinística.
A assistência de IA ajudou a organizar a pesquisa, revisar a redação, gerar as localizações e conferir a consistência dos exemplos. Ela não forneceu uma medição de taxa de falso positivo. Quando preciso prolongar uma sessão de depuração com menos contexto repetido, uso o RemoteCode, uma ferramenta minha; essa menção é editorial e não prova o comportamento do detector.
Conclusão
Um agente está travado quando continua consumindo passos sem acrescentar evidência útil, não simplesmente porque chamou uma tool mais de uma vez. Compare a chamada normalizada, o resultado relevante e o estado observável. Se os três ficam iguais, pause com uma razão que o runtime consiga registrar.
Polling merece outro contrato. O scheduler controla o próximo horário, a deadline e o estado terminal. Assim, um job lento continua podendo terminar, enquanto uma repetição sem progresso não consome o restante do orçamento escondida atrás de um transcript que parece ativo.
Fontes consultadas
- OpenAI Agents SDK, Running Agents, consultado em 19/11/2026.
- Microsoft Agent Framework, Agent looping, consultado em 19/11/2026.
- Google Gemini CLI, loopDetectionService.ts, consultado em 19/11/2026.