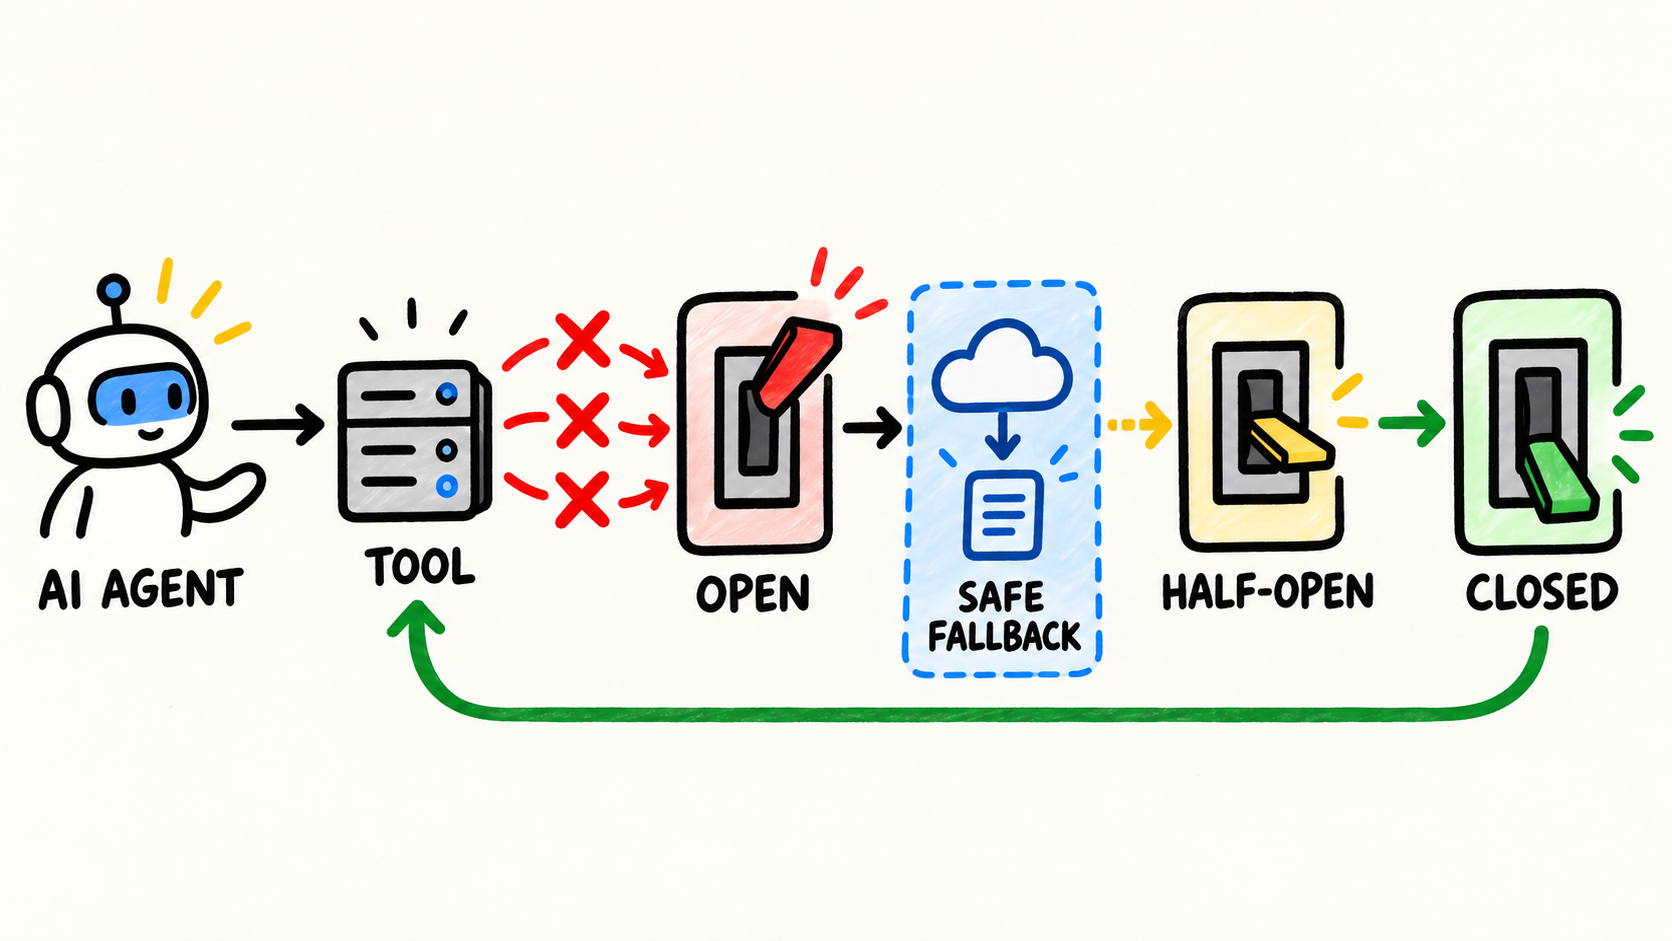
Uma tool de agente falha, o runtime tenta de novo e a dependência continua devolvendo timeout ou 503. O modelo recebe mais um erro, escolhe a mesma tool e o ciclo consome tempo sem aumentar a informação disponível.
Retry e circuit breaker resolvem problemas diferentes. O retry tenta novamente uma falha que pode ser passageira. O circuit breaker interrompe chamadas quando os sinais mostram que a próxima tentativa provavelmente falhará também. Em um agente, essa decisão precisa ficar na fronteira da tool, antes da chamada externa, e não apenas no prompt. O post sobre como evitar que um agente entre em loop infinito cobre o problema geral; aqui o foco é a dependência que está falhando.
Resposta curta
- Mantenha um breaker separado para cada dependência que pode falhar de forma independente.
- Conte apenas falhas classificadas, como timeout, indisponibilidade e rate limit, não erro de validação causado pelo próprio pedido.
- No estado aberto, rejeite a chamada rapidamente e devolva um resultado estruturado que o agente possa explicar ou encaminhar.
- Depois do cooldown, deixe passar uma única sonda em
half-open.- Feche o circuito após uma sonda bem-sucedida e abra de novo quando a dependência continuar falhando.
Retry e circuit breaker não são a mesma guarda
O retry é apropriado quando existe uma chance razoável de a próxima chamada funcionar. O circuit breaker entra quando a falha parece correlacionada: um serviço está indisponível, uma fila está saturada ou uma API está recusando chamadas. A documentação da AWS sobre o padrão Circuit breaker, consultada em 22 de outubro de 2026, descreve o breaker como uma forma de impedir retries repetidos contra uma dependência que já está falhando.
Essas guardas podem trabalhar juntas. Um retry curto pode tratar um erro transitório dentro de uma chamada protegida. Se a classificação indicar que a dependência continua indisponível, o breaker deve impedir a próxima tentativa. A orientação da AWS sobre Retry with backoff, consultada em 22 de outubro de 2026, também separa falhas transitórias de casos em que é melhor falhar rápido.
No runtime de um agente, há uma terceira camada: o modelo pode receber o erro da tool e pedir a mesma ação outra vez. Por isso, o breaker não deve ser apenas um contador dentro do cliente HTTP. Ele precisa envolver o caminho que decide se a tool pode ser executada e devolver uma razão estável quando a chamada for bloqueada.
Um retry pergunta "tento mais uma vez?". Um circuit breaker pergunta "essa dependência deve receber alguma chamada agora?". Se as duas perguntas forem misturadas, o agente pode interpretar a abertura do circuito como um erro temporário e recriar o próprio retry que a guarda tentou impedir.
O que acontece em cada estado?
A documentação da Microsoft sobre o padrão Circuit Breaker, consultada em 22 de outubro de 2026, modela o breaker como uma máquina com os estados closed, open e half-open. Esse modelo serve para uma tool de agente, mas o resultado precisa carregar o contexto operacional que o modelo e o chamador humano conseguem usar.
| Estado | Decisão antes da tool | Transição |
|---|---|---|
closed |
Permite a chamada e observa o resultado | Falhas classificadas acumulam; sucesso limpa a sequência |
open |
Rejeita sem chamar a dependência | Depois do cooldown, passa para half-open |
half-open |
Permite uma sonda; rejeita sondas concorrentes | Sucesso fecha; falha abre novamente |
O estado deve ser por dependência, e não por agente inteiro. Se a busca estiver fora do ar, isso não significa que o banco de dados ou a ferramenta de leitura de arquivos também esteja indisponível. Um breaker global transforma uma falha localizada em uma queda desnecessária de todo o agente.
Também decida quem pode fazer a sonda. Uma única requisição controlada dá à dependência espaço para se recuperar. Liberar um lote inteiro quando o cooldown termina recria o pico no exato momento em que o serviço está voltando.
Quais falhas devem abrir o circuito?
Não abra o circuito para qualquer exceção. Um 400 causado por argumentos inválidos, uma regra de autorização ou uma entrada que o schema rejeitou não prova que a dependência está doente. Contar esse erro como indisponibilidade pode bloquear uma tool saudável e esconder um problema no contrato da chamada.
Classifique a falha antes de atualizar o breaker. Timeout, conexão recusada, 429 e respostas 5xx podem ser candidatos, dependendo do contrato do provedor. Erros de autenticação, recurso inexistente e argumentos inválidos normalmente precisam de correção ou encaminhamento, não de uma sonda automática. A classificação deve ser específica para a dependência e documentada junto da tool.
O número de falhas e o cooldown do exemplo abaixo não são recomendações universais. Eles são parâmetros de uma fixture local. Uma API lenta, uma fila de trabalho e um provedor de modelo têm tempos de recuperação diferentes. Meça a dependência antes de escolher uma política, e comece com uma configuração que possa ser alterada sem redeploy.
Como implementar um circuit breaker para uma tool?
Uma implementação pequena fica mais fácil de revisar quando recebe o relógio por injeção. Assim, o teste consegue avançar o tempo sem sleep, e a transição para half-open não depende da velocidade da máquina.
O wrapper abaixo protege uma operação por vez, permite uma única sonda e mantém a decisão fora do modelo. O método shouldCount representa a classificação da aplicação. Em produção, registre também a dependência, o runId, a transição e o motivo, sem enviar segredos ou o resultado completo da tool para o log.
type CircuitState = "closed" | "open" | "half-open";

type BreakerOptions = {
  failureThreshold: number;
  cooldownMs: number;
  now?: () => number;
  shouldCount: (error: unknown) => boolean;
};

export class CircuitOpenError extends Error {
  constructor(public readonly retryAfterMs: number) {
    super("tool dependency is temporarily unavailable");
    this.name = "CircuitOpenError";
  }
}

export class ToolCircuit {
  private state: CircuitState = "closed";
  private failures = 0;
  private openedAt = 0;
  private probeInFlight = false;

  constructor(private readonly options: BreakerOptions) {}

  getState(): CircuitState {
    if (this.state === "open" && this.remainingCooldown() === 0) {
      this.state = "half-open";
    }
    return this.state;
  }

  async run<T>(operation: () => Promise<T>): Promise<T> {
    const state = this.getState();

    if (state === "open") {
      throw new CircuitOpenError(this.remainingCooldown());
    }

    if (state === "half-open") {
      if (this.probeInFlight) {
        throw new CircuitOpenError(this.options.cooldownMs);
      }
      this.probeInFlight = true;
    }

    try {
      const result = await operation();
      this.failures = 0;
      this.state = "closed";
      return result;
    } catch (error) {
      if (this.options.shouldCount(error)) {
        this.failures += 1;
        if (state === "half-open" || this.failures >= this.options.failureThreshold) {
          this.state = "open";
          this.openedAt = this.options.now?.() ?? Date.now();
        }
      }
      throw error;
    } finally {
      if (state === "half-open") {
        this.probeInFlight = false;
      }
    }
  }

  private remainingCooldown(): number {
    if (this.state !== "open") return 0;
    const now = this.options.now?.() ?? Date.now();
    return Math.max(0, this.options.cooldownMs - (now - this.openedAt));
  }
}
O método não tenta novamente e não chama o modelo. Ele só decide se a operação externa pode começar. Essa separação deixa a política observável e evita que um catch escondido dentro da tool faça o agente acreditar que a chamada foi executada quando ela foi recusada antes do efeito.
Como devolver um fallback que o agente consiga tratar?
Um erro do breaker não deve parecer igual a um erro de argumento. O executor pode transformar CircuitOpenError em um resultado estruturado, com estado temporário, nome da dependência e próxima ação permitida. A mensagem que chega ao modelo deve dizer que a tool está indisponível, não sugerir que ele repita imediatamente.
type ToolResult =
  | { status: "ok"; value: unknown }
  | { status: "blocked"; reason: "dependency_open"; retryAfterMs: number };

declare function searchService(query: string): Promise<unknown>;

async function callSearchTool(circuit: ToolCircuit, query: string): Promise<ToolResult> {
  try {
    const value = await circuit.run(() => searchService(query));
    return { status: "ok", value };
  } catch (error) {
    if (error instanceof CircuitOpenError) {
      return {
        status: "blocked",
        reason: "dependency_open",
        retryAfterMs: error.retryAfterMs,
      };
    }
    throw error;
  }
}
O fallback pode pedir ao agente para responder com o que já sabe, usar uma tool independente ou encaminhar a tarefa. Não deve prometer que a busca será refeita naquele instante. Se a operação for necessária para continuar, persista o estado e retome depois com uma política explícita. A execução durável para agentes de IA cobre essa fronteira de checkpoint e retomada.
Como testar as transições sem esperar de verdade?
O teste principal não precisa de um provedor de modelo nem de uma API real. Use uma operação falsa que falha de forma controlada e um relógio que o teste possa avançar. O objetivo é provar o contrato do breaker, não a disponibilidade da dependência.
O código abaixo é uma fixture ilustrativa, compatível com TypeScript, e não um cliente pronto para produção.
import { strict as assert } from "node:assert";

const clock = { value: 0 };
const counted = (error: unknown) => error instanceof Error && error.message === "down";
const circuit = new ToolCircuit({
  failureThreshold: 2,
  cooldownMs: 100,
  now: () => clock.value,
  shouldCount: counted,
});

const down = async () => { throw new Error("down"); };

await assert.rejects(() => circuit.run(down));
await assert.rejects(() => circuit.run(down));
assert.equal(circuit.getState(), "open");

let calls = 0;
await assert.rejects(() => circuit.run(async () => {
  calls += 1;
  return "should not run";
}));
assert.equal(calls, 0);

clock.value = 100;
assert.equal(circuit.getState(), "half-open");
assert.equal(await circuit.run(async () => "recovered"), "recovered");
assert.equal(circuit.getState(), "closed");
Uma cobertura de produção deve acrescentar quatro casos: erro não classificável não abre o circuito, duas sondas concorrentes não passam juntas, uma sonda que falha volta para open e um sucesso limpa a sequência de falhas. Se o runtime permite várias instâncias do worker, o estado precisa estar em um armazenamento compartilhado ou cada instância terá uma visão diferente da dependência.
Como combinar breaker, retry, timeout e orçamento?
Esses controles não são substitutos. O timeout encerra uma chamada que demorou demais. O retry decide se uma falha transitória merece nova tentativa. O breaker decide se a dependência deve receber a próxima chamada. O orçamento limita o quanto uma execução pode gastar em tokens, tempo ou tools. O post sobre cancelar um agente quando uma tool trava detalha timeout e cancelamento; o fallback de LLM que evita tool calls duplicadas trata de repetição durante failover.
Uma ordem prática é aplicar o prazo da execução, verificar o breaker, executar a tool com timeout, classificar a falha e só então decidir se um retry curto cabe. Quando o breaker abrir, o retry deve parar. Quando o orçamento terminar, o resultado deve registrar stop_reason e não tentar contornar a guarda chamando a mesma tool por outro caminho.
Registre as mudanças de estado e as chamadas bloqueadas. O guia de tool calls com OpenTelemetry ajuda a ligar o evento do breaker ao runId e à dependência. Sem essa trilha, o time verá apenas uma resposta incompleta e não saberá se o serviço falhou, se o circuito abriu ou se o modelo insistiu depois da abertura.
Checklist antes de liberar o breaker
- O breaker protege uma dependência específica, e não o agente inteiro?
- A classificação separa timeout, rate limit,
5xx, autenticação, validação e recurso inexistente? - A chamada é rejeitada antes de qualquer efeito externo quando o estado está
open? - O estado
half-openpermite uma sonda controlada, sem liberar um lote inteiro? - O modelo recebe um resultado que explica a indisponibilidade sem pedir retry imediato?
- O teste usa relógio falso e prova sucesso, falha, cooldown e concorrência?
- O estado compartilhado é consistente quando há mais de um worker?
- O log registra dependência, transição, motivo,
runIde duração sem guardar segredos? - O fallback tem uma ação definida: responder, usar alternativa, pausar ou encaminhar?
Não escolha o limiar porque um exemplo na internet usou o mesmo número. Observe a dependência que a tool chama, classifique as falhas que realmente indicam indisponibilidade e teste a transição antes de permitir efeitos importantes. O breaker deve tornar a falha menor e mais legível, não transformar qualquer erro em silêncio.
Como este artigo foi produzido
Samuel Fajreldines é o autor responsável. A pesquisa comparou as orientações atuais da Microsoft e da AWS sobre circuit breakers e retries com a documentação de agentes e discussões públicas recentes. As discussões foram usadas apenas para linguagem e falhas recorrentes. Uma fixture equivalente em JavaScript foi executada localmente com relógio falso e uma operação em memória; o código TypeScript acima é uma adaptação ilustrativa e não chamou um modelo, um provedor ou um serviço externo.
Usei o RemoteCode como ferramenta do autor para manter contexto entre sessões. Ele apoiou a organização da pesquisa e do texto, mas não executou a fixture nem forneceu prova de produção.
Fontes consultadas
- Microsoft Learn, "Circuit Breaker pattern", consultada em 2026-10-22
- AWS Prescriptive Guidance, "Circuit breaker pattern", consultada em 2026-10-22
- AWS Prescriptive Guidance, "Retry with backoff pattern", consultada em 2026-10-22
- Microsoft Learn, "Develop an agentic RAG solution with Azure", consultada em 2026-10-22